C++进阶学习
C++
之前有刷过黑马的基础c++视频,但是实际中远远不够,所以在这里记录自己c++进阶语法的学习过程,仅供参考
参考文献:
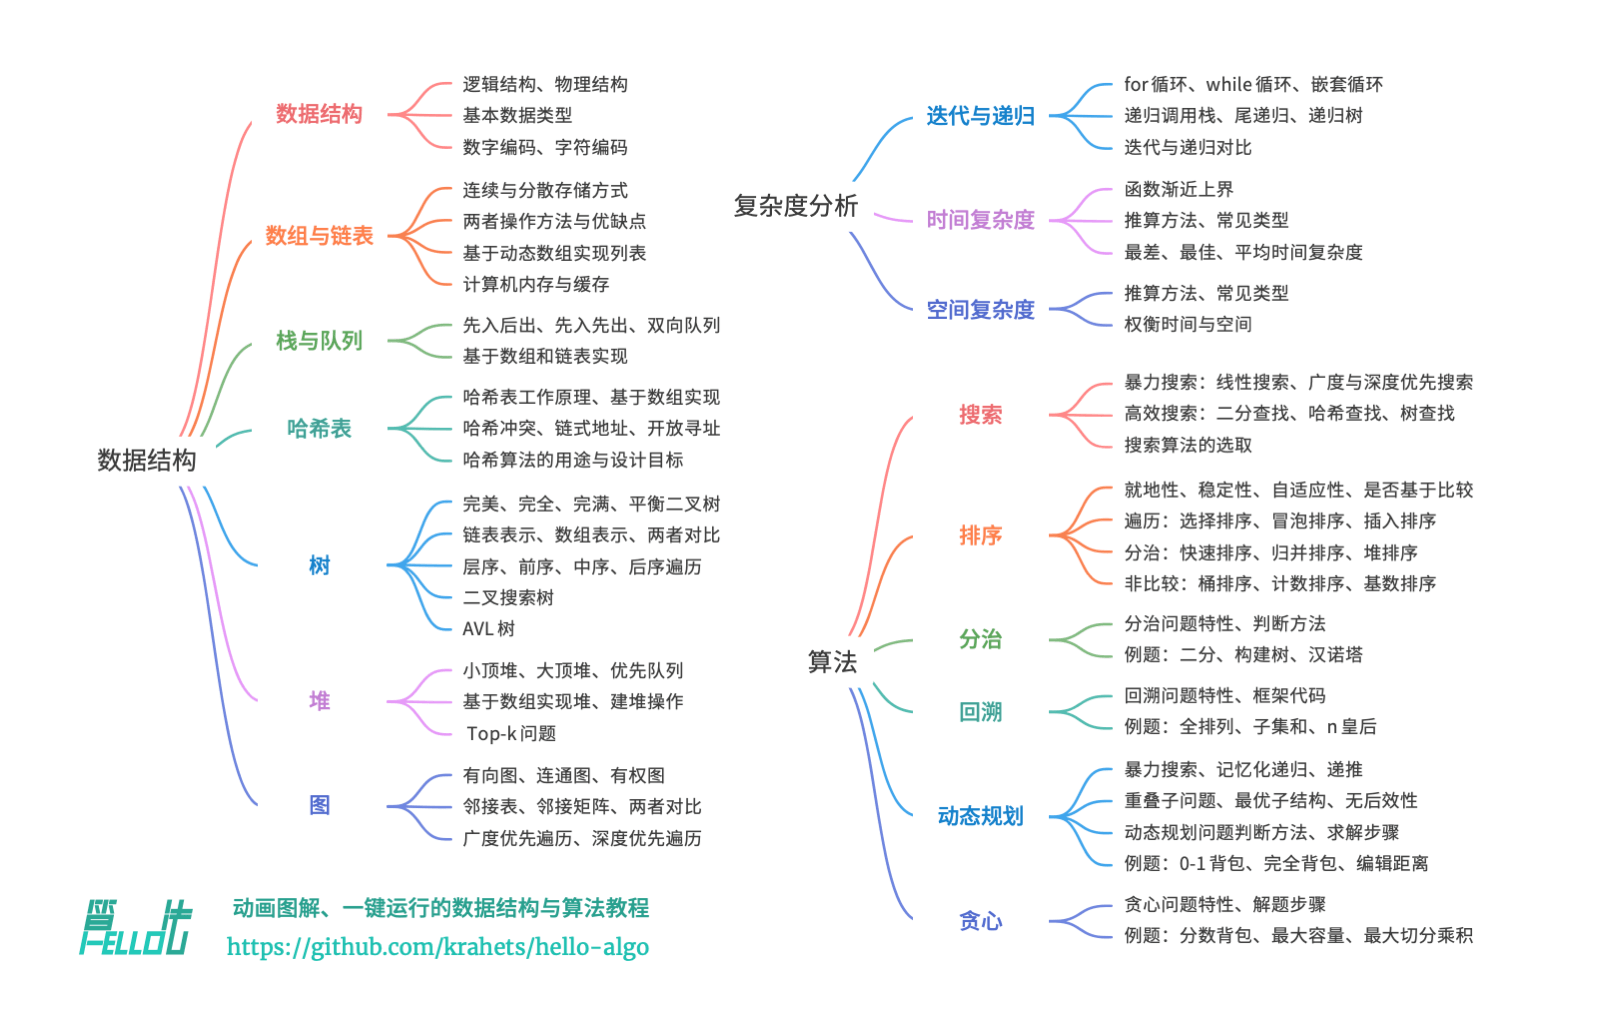
Hello 算法学习网页,本文章的主要学习资料
本书建议的 LeetCode 刷题清单
上一次更新时间:2025-10-29
目前看到的部分
文章目录
学习内容
提示:这里可以添加本文要记录的大概内容:
提示:以下是本篇文章正文内容,下面案例可供参考
快速温故STL
- 顺序容器:vector
特点:动态数组,连续内存。随机访问 O(1)。尾部插入 O(1)。中间插入/删除 O(n)
常见创建方式:
std::vector<int> v; // 空
std::vector<int> v2 = {1,2,3}; // 初始化列表
std::vector<int> v3(5, 0); // 5个元素,每个0
- 顺序容器:deque
特点:双端队列,支持两端高效插入/删除(O(1) 均摊),中间操作 O(n)。随机访问 O(1)(比 vector 常数略差)
常见创建方式:创建类似 vector
- 顺序容器:list(双向链表) 与 forward_list(单向链表)
特点:链表,插入/删除在任意位置 O(1)(已知位置,需通过迭代器),随机访问 O(n)。splice 可在 O(1) 内移动节点
常见创建方式:
std::list<int> lst = {1,2,3};
- 顺序容器:array
特点:固定大小数组
记忆小技巧:
需要随机访问(索引) → vector 或 array
需要两端快 → deque
需要中间频繁插入删除 → list / forward_list
- 关联容器:基于红黑树(RB-tree)–set/multiset
特点:元素唯一(set)或允许重复(multiset)。自动按 < 排序
常见创建方式:
std::set<int> s = {3,1,2};
- 关联容器:基于红黑树(RB-tree)–map/multimap
特点:键值对,按 key 排序。operator[] 可用(会插入默认值)
常见创建方式:
std::map<std::string,int> m;
记忆技巧:
有序(ordered)+ 红黑树 → O(log n)
- 无序关联容器:基于哈希表–unordered_set/unordered_map/unordered_multiset/unordered_multimap
特点:无序、基于 hash。插入/查找平均 O(1)。可自定义 hash 和相等函数
常见创建方式:
std::unordered_map<std::string,int> um;
记忆技巧:
要 O(1) 查找且不关心顺序 → unordered 系列
一、配置window的c++环境
参考资料:
操作指南-下面视频里面有相关软件的下载链接
操作视频
视频博主的知乎链接
按照上面的配置了自己vescode环境
二、算法
1.目标
- 解决问题
- 优化解决方法
- 时间效率
- 空间效率
复杂度分析关注的不是运行时间或占用空间的具体值,而是时间或空间增长的“快慢”
1.1 迭代与递归
1.1.1 迭代:自下而上
for
while
1.1.2 递归:自上而下
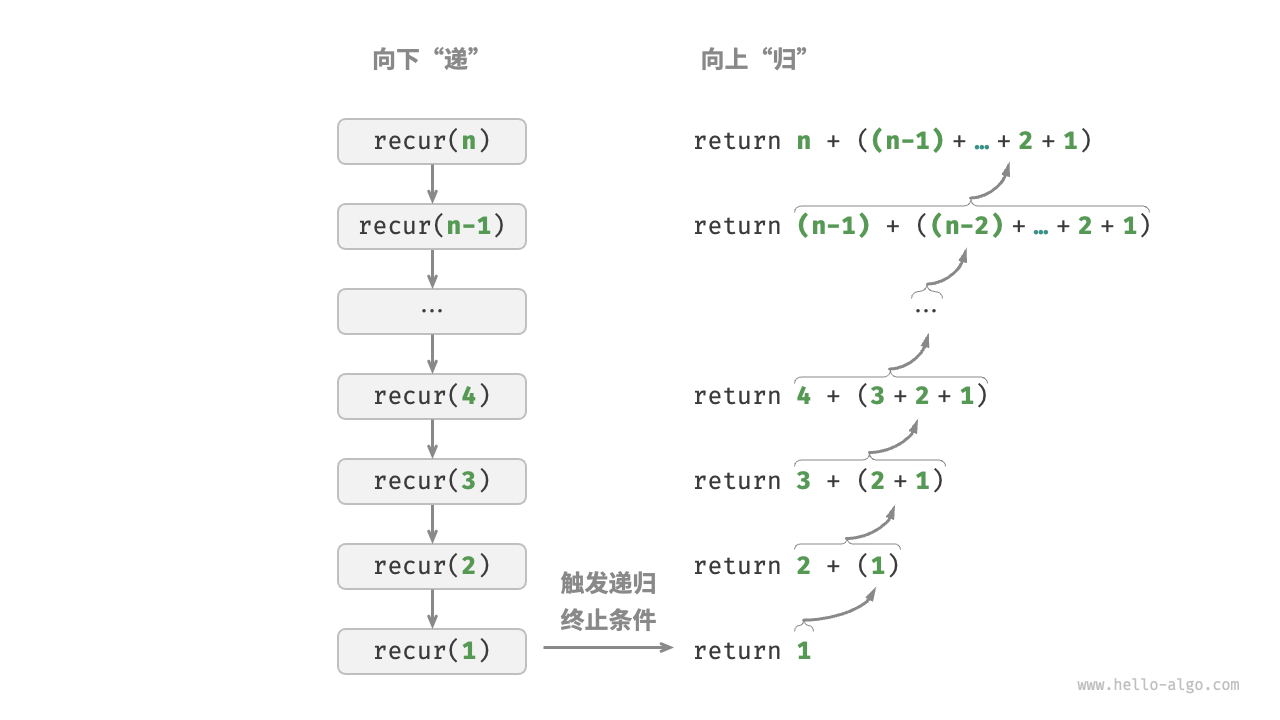
1.1.2.1普通递归:
调用栈
递:当函数被调用时,系统会在“调用栈”上为该函数分配新的栈帧
归:当函数完成执行并返回时,对应的栈帧会被从“调用栈”上移除,恢复之前函数的执行环境
可以使用一个显式的栈来模拟调用栈的行为
递归函数每次调用本身的时候,系统会为新开启的函数分配内存,来存储局部变量,调用地址等信息
- 函数的上下文数据都被存放在称作“栈帧空间”的内存区域,函数结束才被释放,所以比起迭代更费内存空间
- 调用函数产生额外开销,所以比起循环的时间效率更低
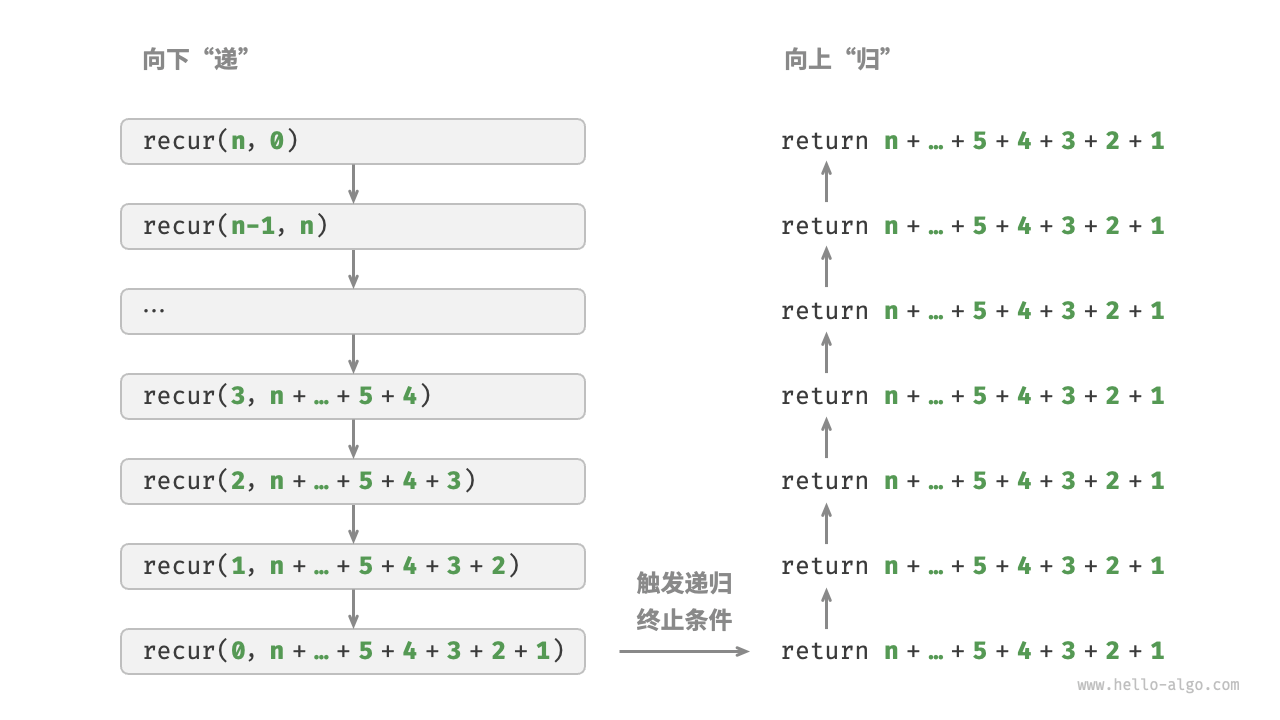
1.1.2.2尾递归:
如果函数在返回前的最后一步才进行递归调用,可以使得空间效率和迭代相当
许多编译器或解释器并不支持尾递归优化。例如,Python 默认不支持尾递归优化,因此即使函数是尾递归形式,仍然可能会遇到栈溢出问题
1.1.2.3普通递归vs尾递归:
普通
int recur(int n){
	if (n==1)
		return 1;
	int res =recur(n-1);
	return n+res;
	}
尾
int tailcur(int n,int res){
	if (n==0)
		return res;
	return tailrecur(int n-1,int res+n);
	}
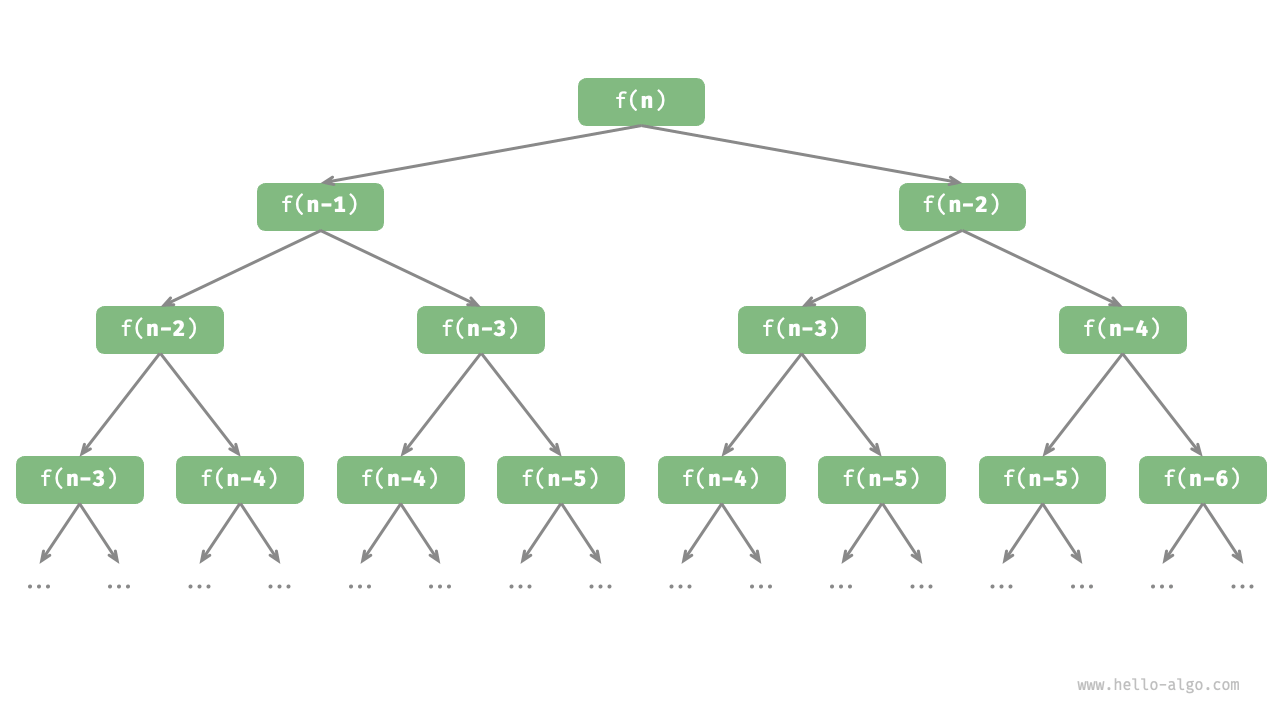
1.1.2.4 递归树
斐波那契数列 :每个数字是前两个数字的和
分治思想
int fib(int n){
	if (n==1||n==2)
		return n-1;
	int res = fib(n-1)+fib(n-2);
	return res;
	}
1.2 复杂度分析
时间复杂度分析本质上是计算“操作数量 T(n)”的渐近上界
1.2.1 常数阶
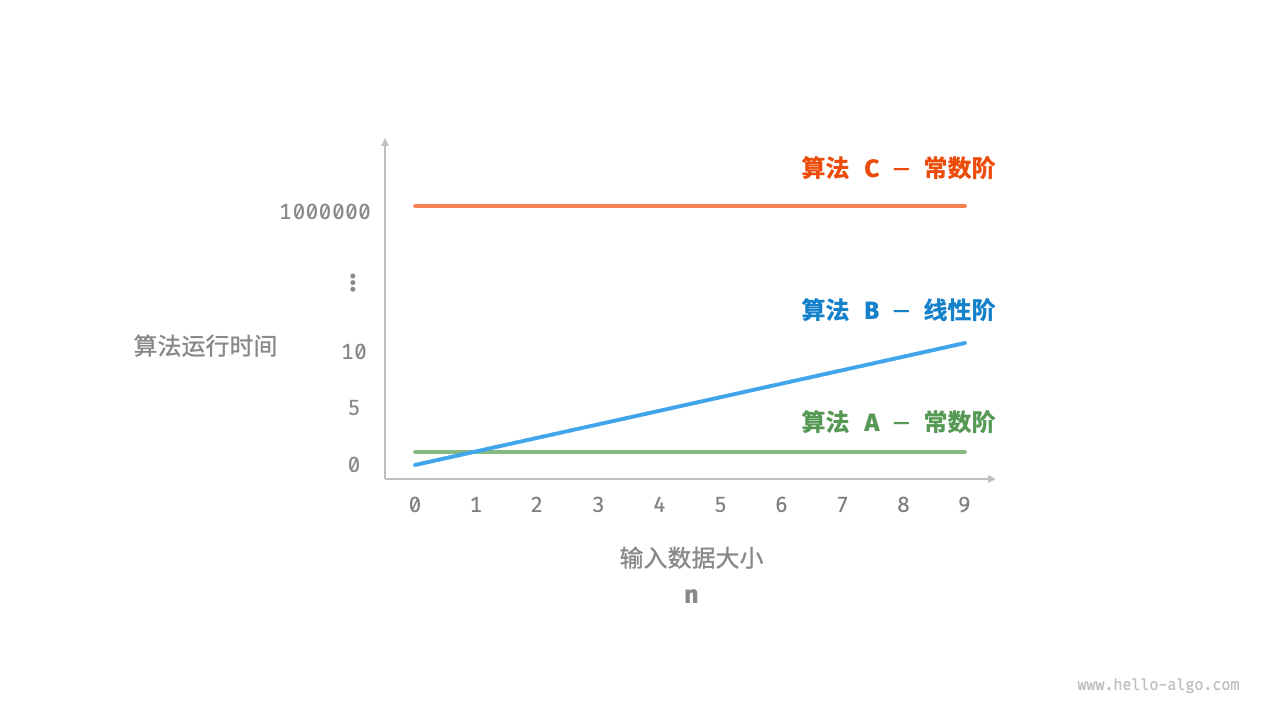
算法运行时间不随着输入增大而增长
1.2.2 线性阶
法运行时间随着输入增大呈线性增长
只要输入数据大小 足够大,复杂度为“常数阶”的算法一定优于“线性阶”的算法
1.2.2 渐近上界
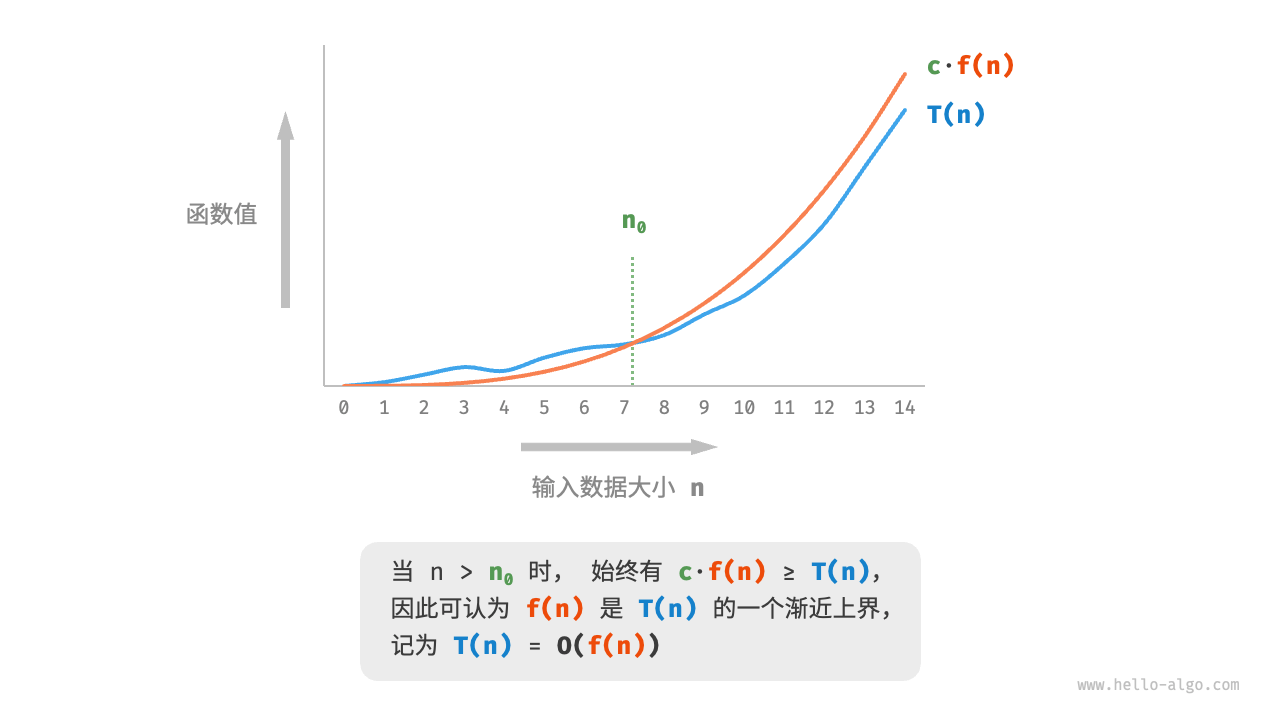
T(n)和f(n)相同的增长级别,仅相差一个常数系数c
1.2.3 计算时间复杂度
1.2.3.1 函数渐近上界-最差时间复杂度
完整统计 T(n)
    int a = 1;  // +1
    a = a + n;  // +1
    //  循环 5 * n+1 次
    for (int i = 0; i < 5 * n + 1; i++) {// +1
        cout << 0 << endl; // +1
    }

    //外层循环2n次 内层循环n+1次
    for (int i = 0; i < 2 * n; i++) {// +1
        for (int j = 0; j < n + 1; j++) {// +1
            cout << 0 << endl;// +1
        }
    } }
     // T(n)=2+5n+1+2n(n+1)
由渐进上届可以知道,c可以取任意大小,所以我们可以忽略T(n)的各种系数,常数
- 忽略T(n)系数,常数
- 循环嵌套时使用乘法:总操作数量等于外层循环和内层循环操作数量之积
void algorithm(int n) {
    int a = 1;  // +0(技巧 1)
    a = a + n;  // +0(技巧 1)
    // +n(技巧 2)
    for (int i = 0; i < 5 * n + 1; i++) {
        cout << 0 << endl;
    }
    // +n*n(技巧 3)
    for (int i = 0; i < 2 * n; i++) {
        for (int j = 0; j < n + 1; j++) {
            cout << 0 << endl;
        }
    }
}
// 渐近上界=n+n(n)
时间复杂度由最高阶的项来决定:
常数项的时间复杂度是O(1)
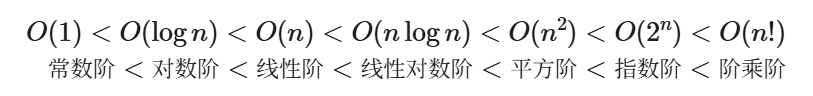
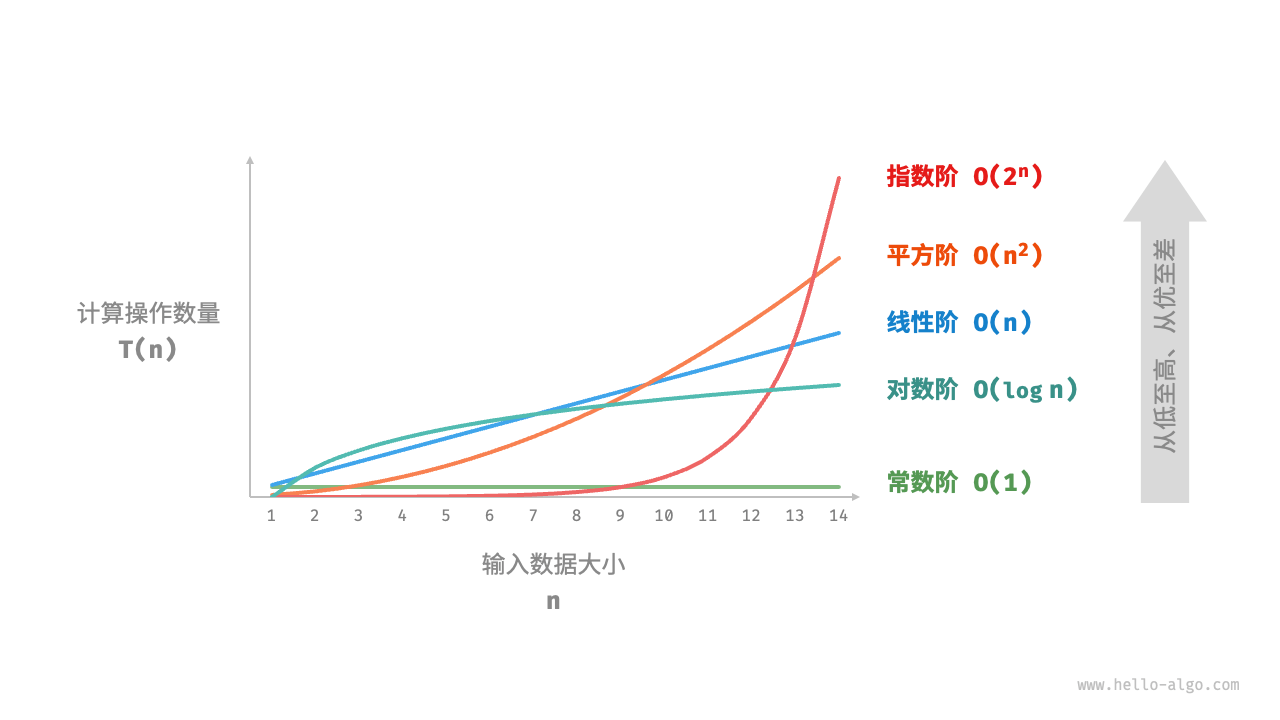
常见的时间复杂度排序
指数阶增长非常迅速,在穷举法(暴力搜索、回溯等)中比较常见。对于数据规模较大的问题,指数阶是不可接受的,通常需要使用动态规划或贪心算法等来解决
例子:
此外注意:输入数据大小需根据输入数据的类型来具体确定

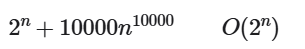
例子:
- 指数阶:如细胞分裂 1–>2–>4–>…
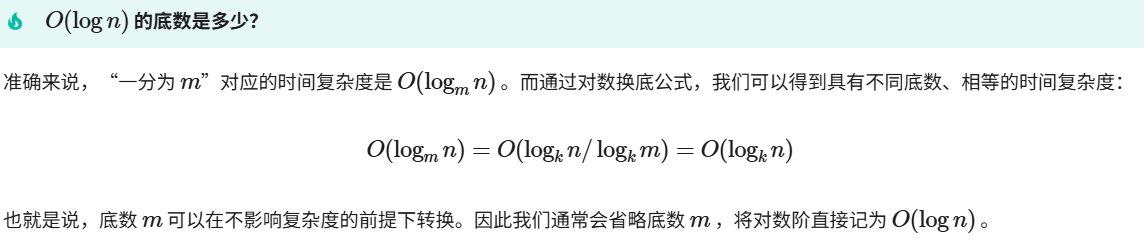
- 对数阶: 与指数阶相反,对数阶反映了“每轮缩减到一半”的情况 n–>n/2–>n/4–>…
由于每轮缩减到一半,因此循环次数,
ps:

- 线性对数阶常出现于嵌套循环中
主流排序算法的时间复杂度通常是这个,如快速排序、归并排序、堆排序
- 阶乘阶 :对应数学上的“全排列”问题,如给定
n个互不重复的元素,求其所有可能的排列方案
int factorialRecur(int n) {
    if (n == 0)
        return 1;
    int count = 0;
    for (int i = 0; i < n; i++) {
        count += factorialRecur(n - 1);
    }
    return count;
}
//每一层调用自己 n 次,下一层的 n 减 1
//T(n)=n×T(n−1)
1.2.3.2 函数渐近下界-最佳时间复杂度
假设输入一个长度为n的数组 nums ,其中 nums 由从1 至n 的数字组成,每个数字只出现一次;但元素顺序是随机打乱的,任务目标是返回元素 的索引
当 nums = [?, ?, …, 1] ,即当末尾元素是1时,需要完整遍历数组,达到最差时间复杂度
当 nums = [1, ?, ?, …] ,即当首个元素为1时,无论数组多长都不需要继续遍历,达到最佳时间复杂度
1.2.4 计算空间复杂度
1.2.4.1 内存空间分类
- 输入空间:用于存储算法的输入数据。
- 暂存空间:用于存储算法在运行过程中的变量、对象、函数上下文等数据。
- 暂存数据:用于保存算法运行过程中的各种常量、变量、对象等
- 栈帧空间:用于保存调用函数的上下文数据。系统在每次调用函数时都会在栈顶部创建一个栈帧,函数返回后,栈帧空间会被释放
- 指令空间:用于保存编译后的程序指令,在实际统计中通常忽略不计
- 输出空间:用于存储算法的输出数据
分析一段程序的空间复杂度时,我们通常统计暂存数据、栈帧空间和输出数据三部分
/* 结构体 */
struct Node {
    int val;
    Node *next;
    Node(int x) : val(x), next(nullptr) {}
};

/* 函数 */
int func() {
    // 执行某些操作...
    return 0;
}

int algorithm(int n) {        // 输入数据
    const int a = 0;          // 暂存数据(常量)
    int b = 0;                // 暂存数据(变量)
    Node* node = new Node(0); // 暂存数据(对象)
    int c = func();           // 栈帧空间(调用函数)
    return a + b + c;         // 输出数据
}
常见的空间复杂度类型:
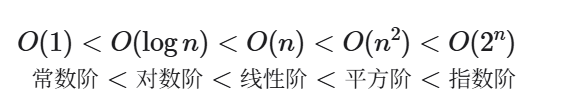
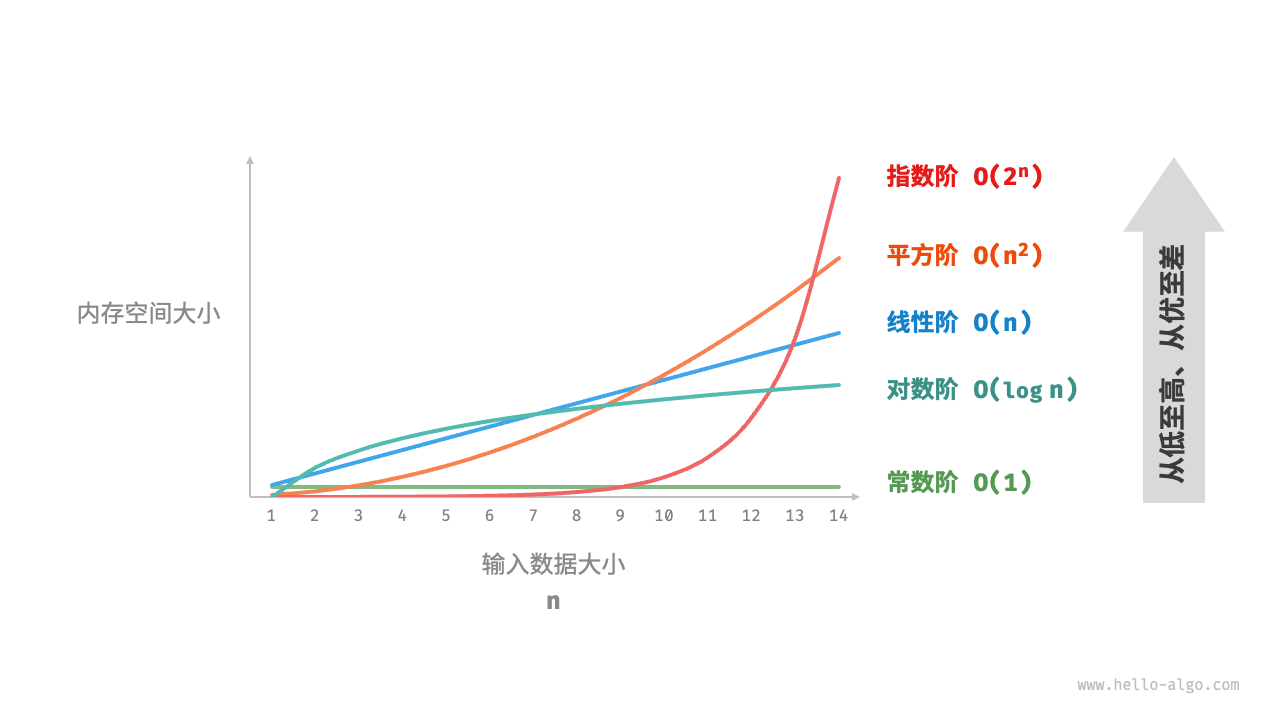
1.2.4.2 最差空间复杂度
- 以最差输入数据为准:在n<10之前,空间复杂度为O(1),但初始化数组 nums 时占用O(n),所以最差空间复杂度为O(n)
- 以算法运行中的峰值内存为准:程序在执行最后一行之前O(1),初始化数组 nums 时,占用O(n),所以最差空间复杂度为O(n)
void algorithm(int n) {
    int a = 0;               // O(1)
    vector<int> b(10000);    // O(1)
    if (n > 10)
        vector<int> nums(n); // O(n)
}
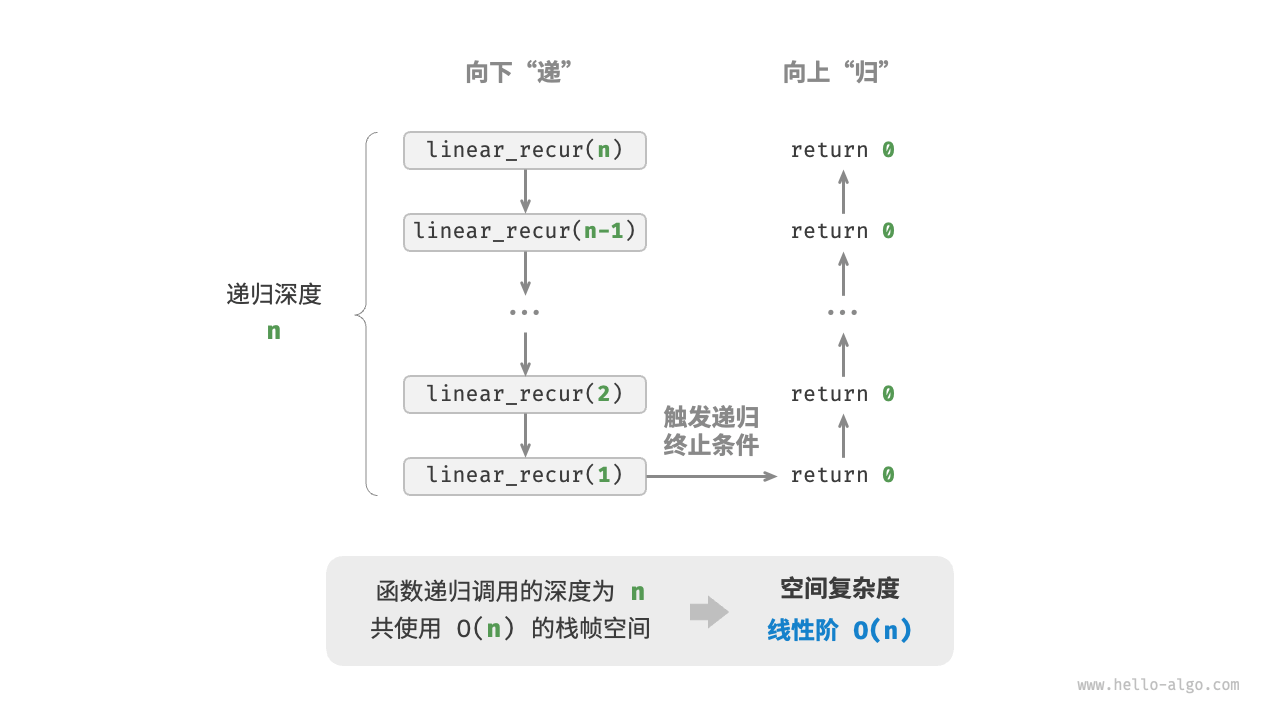
递归函数中,需要注意统计栈帧空间:
函数loop() 和 递归函数recur() 的时间复杂度都是O(n),但是空间复杂度不同
loop() 在循环中调用了n次 function() ,每轮function() 都返回并释放了栈帧空间
recur() 在运行过程中会同时存在 n个未返回的 recur()
int func() {
    // 执行某些操作
    return 0;
}
/* 循环的空间复杂度为 O(1) */
void loop(int n) {
    for (int i = 0; i < n; i++) {
        func();
    }
}
/* 递归的空间复杂度为 O(n) */
void recur(int n) {
    if (n == 1) return;
    recur(n - 1);
}
常见的空间复杂度类型例子
- 常数阶:常见于数量与输入数据大小 n无关的常量、变量、对象
- 线性阶:常见于元素数量与n成正比的数组、链表、栈、队列等
vector<ListNode> nodes;// 长度为 n 的列表占用 O(n) 空间
unordered_map<int, string> map;//长度为 n 的哈希表占用 O(n) 空间
vector<int> nums(n);// 长度为 n 的数组占用 O(n) 空间
- 平方阶:平方阶常见于矩阵和图
vector<vector<int>> numMatrix;// 二维列表占用 O(n^2) 空间
- 指数阶:指数阶常见于二叉树
/* 指数阶(建立满二叉树) */
TreeNode *buildTree(int n) {
    if (n == 0)
        return nullptr;
    TreeNode *root = new TreeNode(0);
    root->left = buildTree(n - 1);
    root->right = buildTree(n - 1);
    return root;
}
- 对数阶:对数阶常见于分治算法
- 尾递归的空间复杂度是 O(1)?
A:理论上,尾递归函数的空间复杂度可以优化到 O(1),但是绝大多数编程语言不支持自动优化尾递归,因此通常认为空间复杂度是O(n)- 实际使用场景,选择牺牲时间还是空间?
A:实际应用中,大部分情况会选择牺牲空间换时间,空间资源宝贵的场景,也会选择牺牲时间换空间
1.3 数据结构
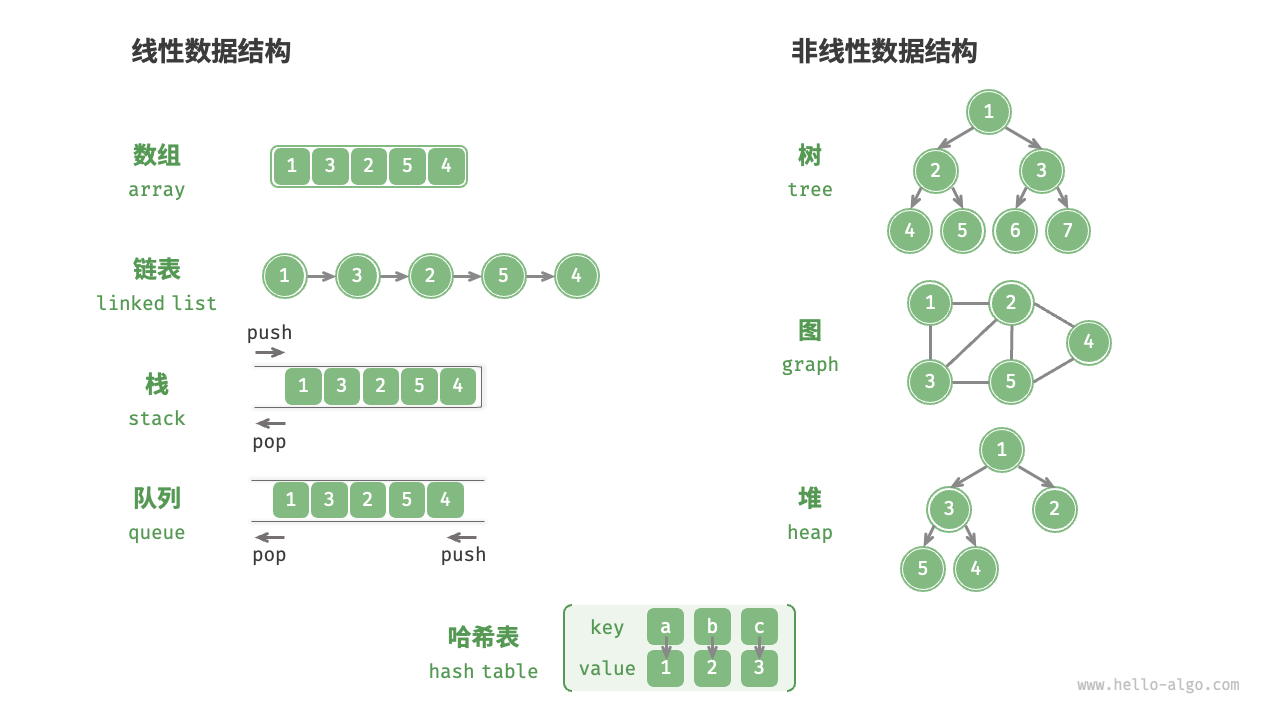
常见的数据结构包括数组、链表、栈、队列、哈希表、树、堆、图,它们可以从“逻辑结构”和“物理结构”两个维度进行分类
1.3.1数据结构分类
逻辑结构:可分为“线性”和“非线性”两大类
线性数据结构:数组、链表、栈、队列、哈希表,元素之间是一对一的顺序关系。
非线性数据结构:树、堆、图、哈希表
- 可以进一步划分为树形结构和网状结构
树形结构:树、堆、哈希表,元素之间是一对多的关系
网状结构:图,元素之间是多对多的关系
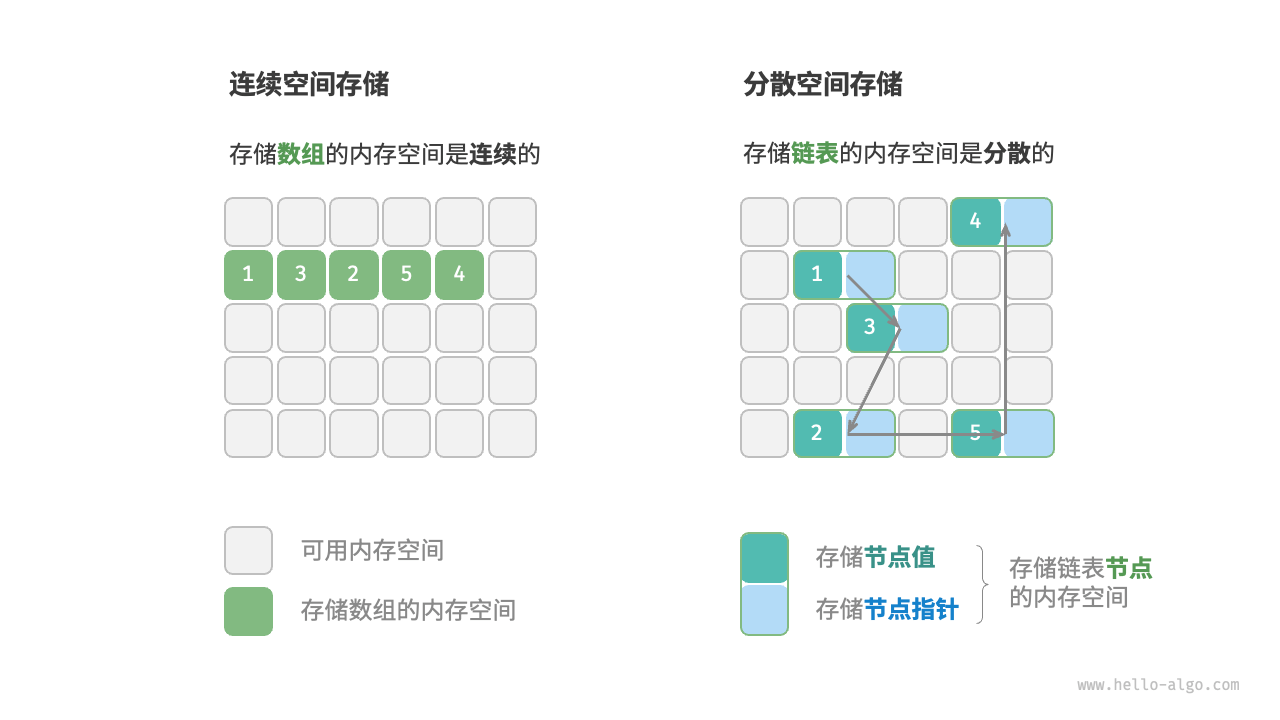
物理结构:连续与分散
当算法程序运行时,正在处理的数据主要存储在内存中。一个计算机内存条,其中每个黑色方块都包含一块内存空间。我们可以将内存想象成一个巨大的 Excel 表格,其中每个单元格都可以存储一定大小的数据。实际内存的工作机制比较复杂,涉及地址空间、内存管理、缓存机制、虚拟内存和物理内存等概念。
系统通过内存地址来访问目标位置的数据。计算机根据特定规则为表格中的每个单元格分配编号,确保每个内存空间都有唯一的内存地址。有了这些地址,程序便可以访问内存中的数据。
- 内存是所有程序的共享资源
- 在数据结构与算法的设计中,内存资源是一个重要的考虑因素
- 物理结构反映了数据在计算机内存中的存储方式
- 两种物理结构在时间效率和空间效率方面呈现出互补的特点
所有数据结构都是基于数组、链表或二者的组合实现的
- 基于数组可实现:栈、队列、哈希表、树、堆、图、矩阵、张量(维度>=3的数组)等。
- 基于链表可实现:栈、队列、哈希表、树、堆、图等。
1.3.2 数据结构与数据类型
基本数据类型提供了数据的“内容类型”,而数据结构提供了数据的“组织方式”,例如以下代码,我们用相同的数据结构(数组)来存储与表示不同的基本数据类型
// 使用多种基本数据类型来初始化数组
int numbers[5];
float decimals[5];
char characters[5];
bool bools[5];
1.3.3 字符编码
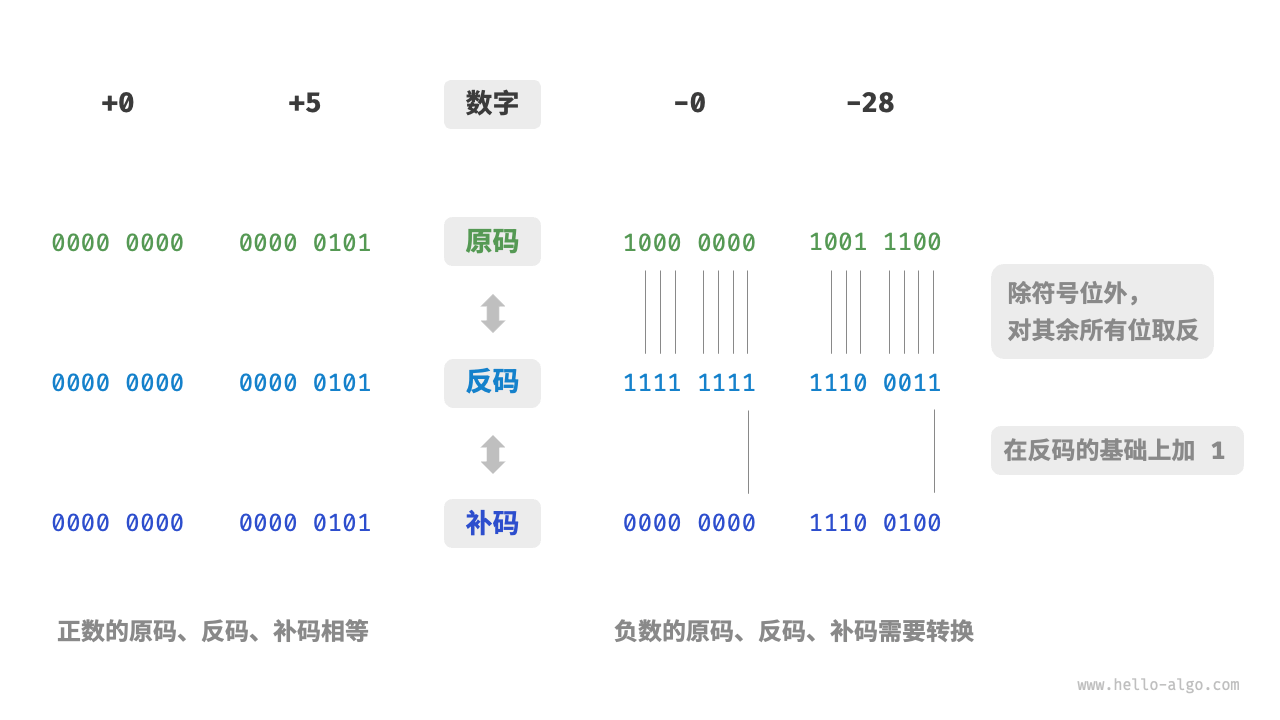
- 首先需要指出,数字是以“补码”的形式存储在计算机中的。在分析这样做的原因之前,首先给出三者的定义。
原码:我们将数字的二进制表示的最高位视为符号位,其中 0表示正数,1表示负数,其余位表示数字的值。负数的原码不能直接用于运算–>引入了反码,数字零的原码有 -0和+0,两种表示方式–>引入了补码
反码:正数的反码与其原码相同,负数的反码是对其原码除符号位外的所有位取反。
补码:正数的补码与其原码相同,负数的补码是在其反码的基础上加 1
计算机规定这个特殊的补码 1000 0000代表 -128
计算机内部的硬件电路主要是基于加法运算设计的
通过将加法与一些基本逻辑运算结合,计算机能够实现各种其他的数学运算
1.3.4 小结
Q:为什么哈希表同时包含线性数据结构和非线性数据结构?
哈希表底层是数组,而为了解决哈希冲突,我们可能会使用“链式地址”:数组中每个桶指向一个链表,当链表长度超过一定阈值时,又可能被转化为树(通常为红黑树)。哈希表可能同时包含线性数据结构(数组、链表)和非线性数据结构(树)。
Q:基于数组实现的数据结构也称“静态数据结构” 是否有歧义?栈也可以进行出栈和入栈等操作,这些操作都是“动态”的。
栈确实可以实现动态的数据操作,但数据结构仍然是“静态”(长度不可变)的。尽管基于数组的数据结构可以动态地添加或删除元素,但它们的容量是固定的。如果数据量超出了预分配的大小,就需要创建一个新的更大的数组,并将旧数组的内容复制到新数组中。
Q:在构建栈(队列)的时候,未指定它的大小,为什么它们是“静态数据结构”呢?
在高级编程语言中,我们无须人工指定栈(队列)的初始容量,这个工作由类内部自动完成。
1.4 数组与链表
1.4.1数组
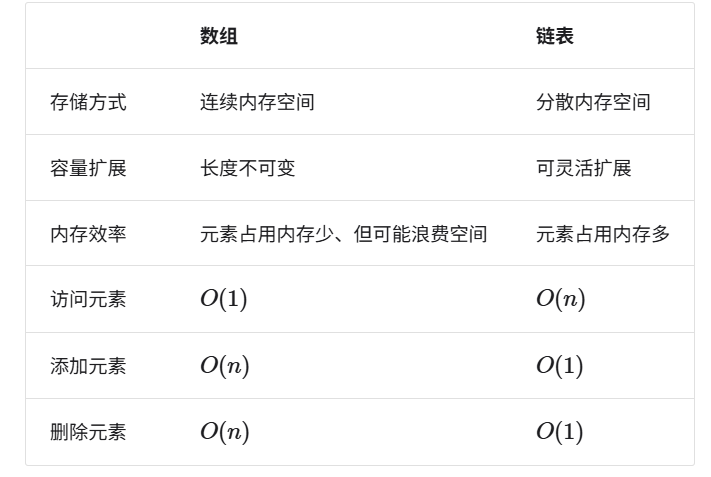
1.4.1.1 数组特点
- 数组(array)是一种线性数据结构,
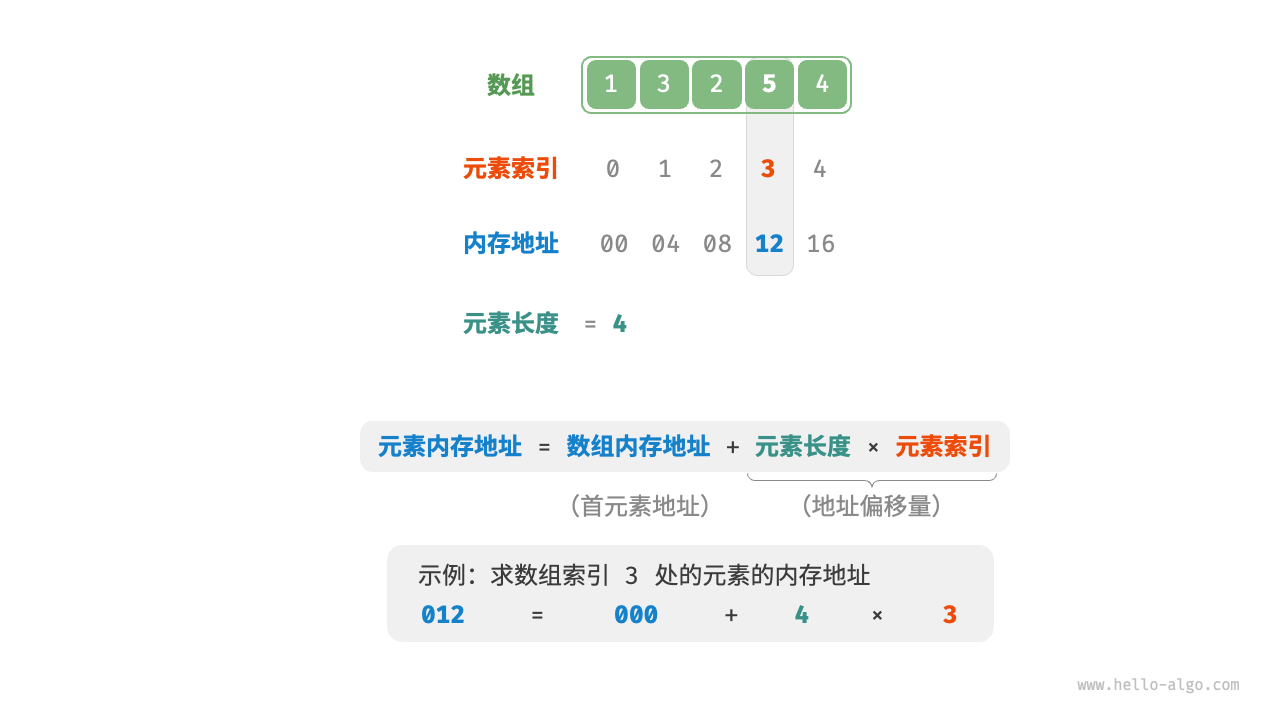
- 相同类型的元素存储在连续的内存空间中,这意味着计算数组元素的内存地址非常容易,数组中访问元素非常高效,
- 我们可以在 O(1)时间内随机访问数组中的任意一个元素
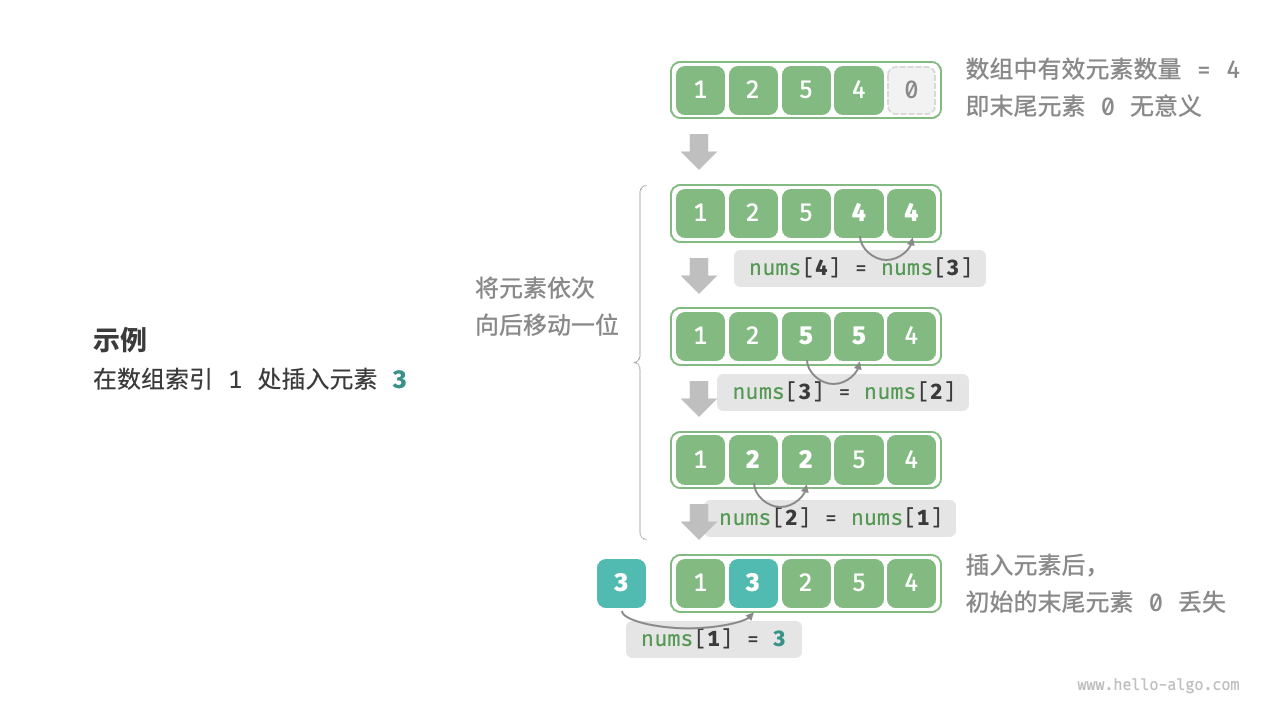
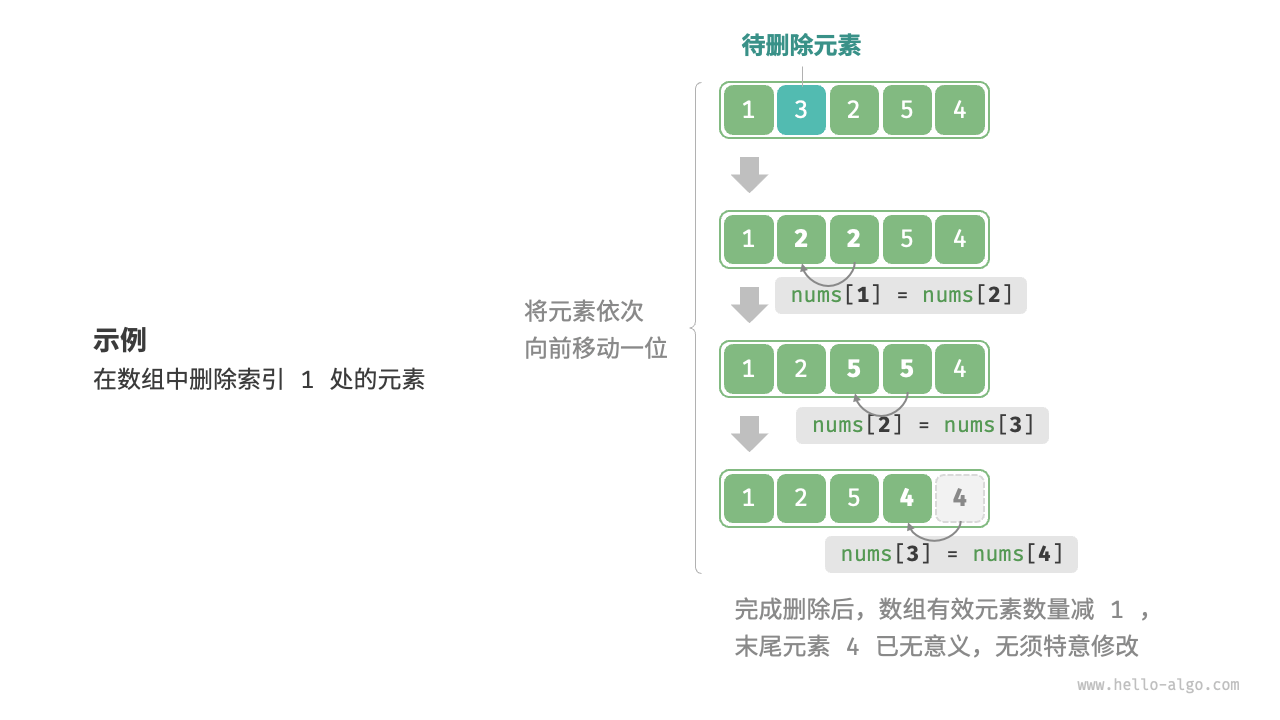
- 数组元素在内存中是“紧挨着的”,它们之间没有空间再存放任何数据。如果想在数组中间插入一个元素,则需要将该元素之后的所有元素都向后移动一位,之后再把元素赋值给该索引,由于数组的长度是固定的,因此插入一个元素必定会导致数组尾部元素“丢失”,若想删除索引 i处的元素,则需要把索引i 之后的元素都向前移动一位,数组的插入和删除的平均时间复杂度均为O(n),
我们可以初始化一个比较长的数组,只用前面一部分,这样在插入数据时,丢失的末尾元素都是“无意义”的,但这样做会造成部分内存空间浪费
总结
- ⭐空间效率高:连续内存块,无需额外结构开销
- ⭐ 支持随机访问:时间复杂度O(1)
- ⭐缓存局部性:当访问数组元素时,计算机不仅会加载它,还会缓存其周围的其他数据,从而借助高速缓存来提升后续操作的执行速度。
- ⚠️插入与删除效率低:当数组中元素较多时,插入与删除操作需要移动大量的元素
- ⚠️长度不可变:数组在初始化后长度就固定了,扩容数组需要将所有数据复制到新数组,开销很大。
- ⚠️空间浪费:如果数组分配的大小超过实际所需,那么多余的空间就被浪费了
1.4.1.2 数组应用
- 随机访问:如果我们想随机抽取一些样本:生成一个随机序列,根据索引实现随机抽样。
- 排序和搜索:数组是排序和搜索算法最常用的数据结构。快速排序、归并排序、二分查找等都主要在数组上进行。
- 查找表:当需要快速查找一个元素或其对应关系时,可以使用数组作为查找表。可以把值作为索引,对应的元素存放在数组中的对应位置。
- 机器学习:神经网络中大量使用了向量、矩阵、张量之间的线性代数运算,这些数据都是以数组的形式构建的。数组是神经网络编程中最常使用的数据结构。
- 数据结构实现:数组可以用于实现栈、队列、哈希表、堆、图等数据结构。
1.4.2 链表
1.4.2.1 链表特点
·
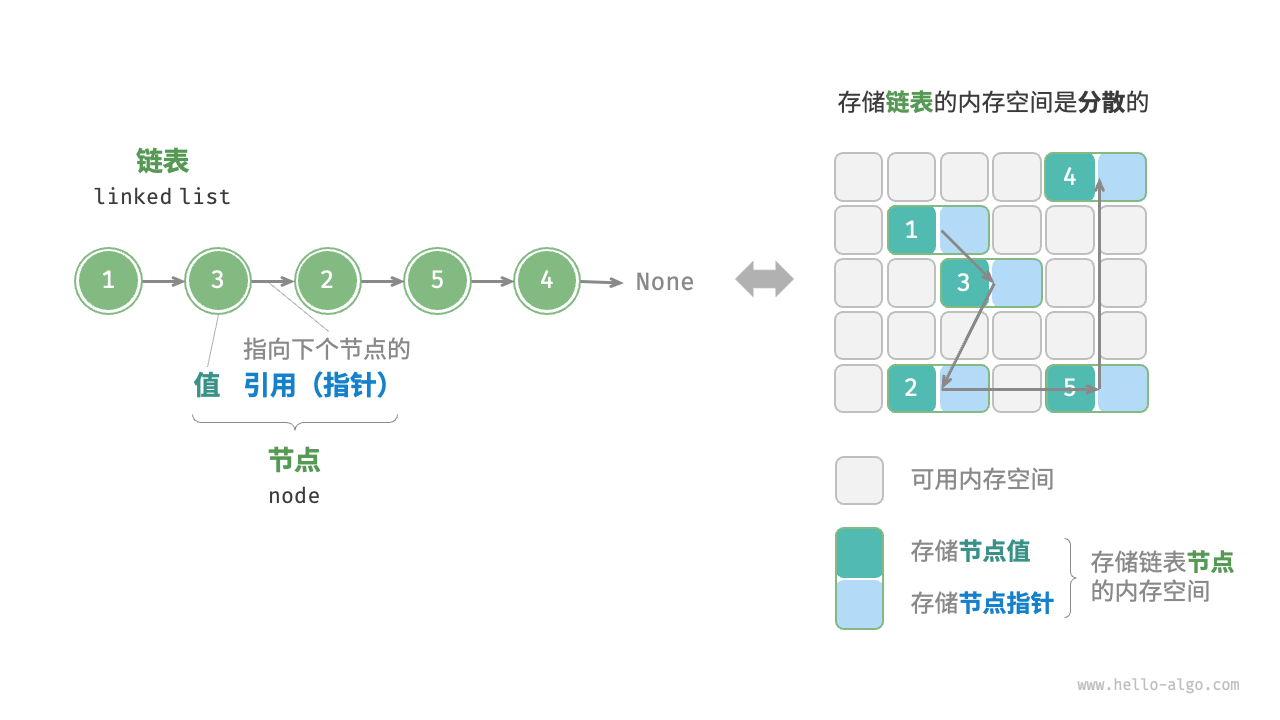
- 链表是一种线性数据结构,其中的每个元素都是一个节点对象,各个节点通过“引用”相连接。引用记录了下一个节点的内存地址,通过它可以从当前节点访问到下一个节点。
- 链表的组成单位是节点(node)对象:每个节点都包含两项数据:节点的“值”和指向下一节点的“引用”,因此在相同数据量下,链表比数组占用更多的内存空间
首个节点被称为“头节点”,最后一个节点被称为“尾节点”
尾节点指向的是“空”,C++ 和 Python 中分别被记为 nullptr 和 None在C++支持指针的语言中,上述“引用”应被替换为“指针”/* 链表节点结构体 */ struct ListNode { int val; // 节点值 ListNode *next; // 指向下一节点的指针 // 当你创建一个新的节点时,把节点的 val 赋值为 x,同时让指针 next 指向空(nullptr)。在对象构造时直接初始化成员变量,效率高,尤其是对象类型成员 ListNode(int x) : val(x), next(nullptr) {}// 构造函数 }; // 初始化各个节点 ListNode* n0 = new ListNode(1); ListNode* n1 = new ListNode(3); ListNode* n2 = new ListNode(2); // 构建节点之间的引用 n0->next = n1; n1->next = n2;
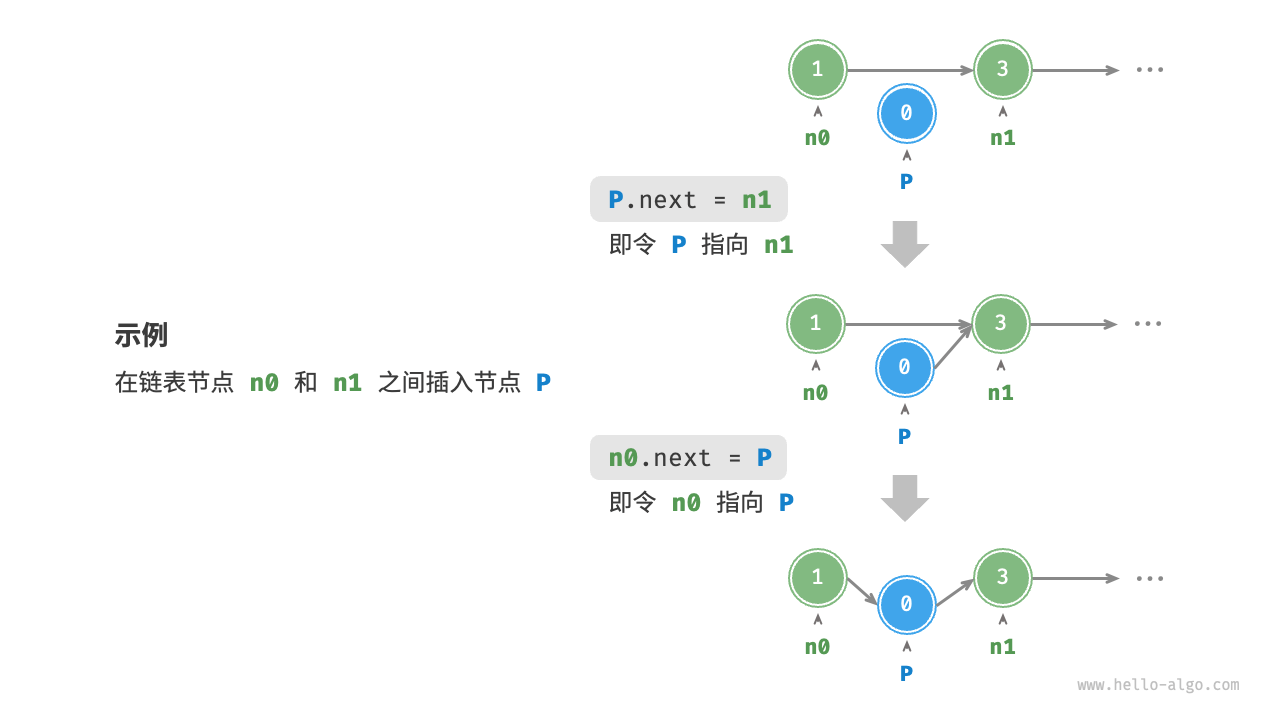
- 在链表中插入节点非常容易,则只需改变两个节点引用(指针)即可,时间复杂度为O(1),数组插入的时间复杂度是O(n)
/* 在链表的节点 n0 之后插入节点 P */
void insert(ListNode *n0, ListNode *P)
{
    ListNode *n1 = n0->next;
    P->next = n1;
    n0->next = P;
 }
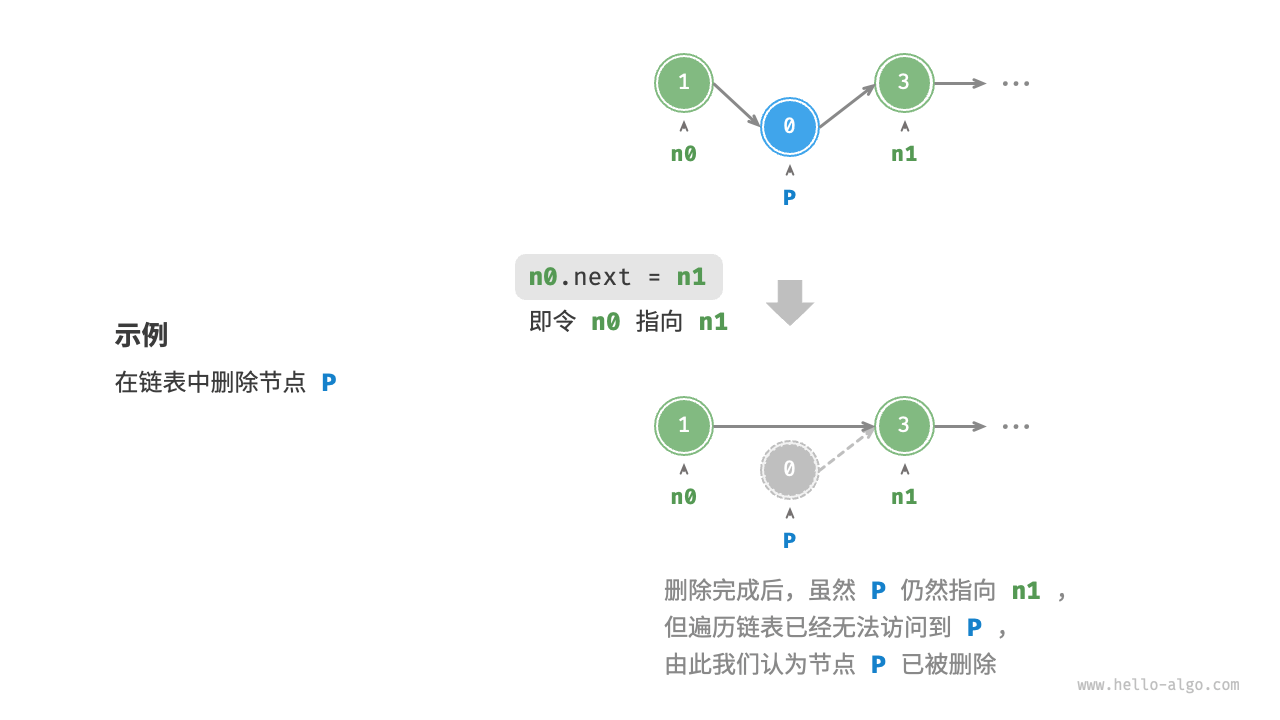
- 在链表中删除节点也非常方便,只需改变一个节点的引用(指针)即可,尽管在删除操作完成后节点 P 仍然指向 n1 ,但实际上遍历此链表已经无法访问到 P ,这意味着 P 已经不再属于该链表了
在这里插入图片描述
/* 删除链表的节点 n0 之后的首个节点 */
void remove(ListNode *n0) {
    if (n0->next == nullptr)
        return;
    // n0 -> P -> n1
    ListNode *P = n0->next;
    ListNode *n1 = P->next;
    n0->next = n1;
    // 释放内存
    delete P; }
- 在链表中访问节点的效率较低,数组
时间复杂度为O(1),但是链表需要从头开始逐渐遍历,时间复杂度为O(n)int find(ListNode *head,int target){ int index=0; while(head!=nullptr) { if (head->val==target) return index; head = head->next; index++; } return -1; }
常见链表类型
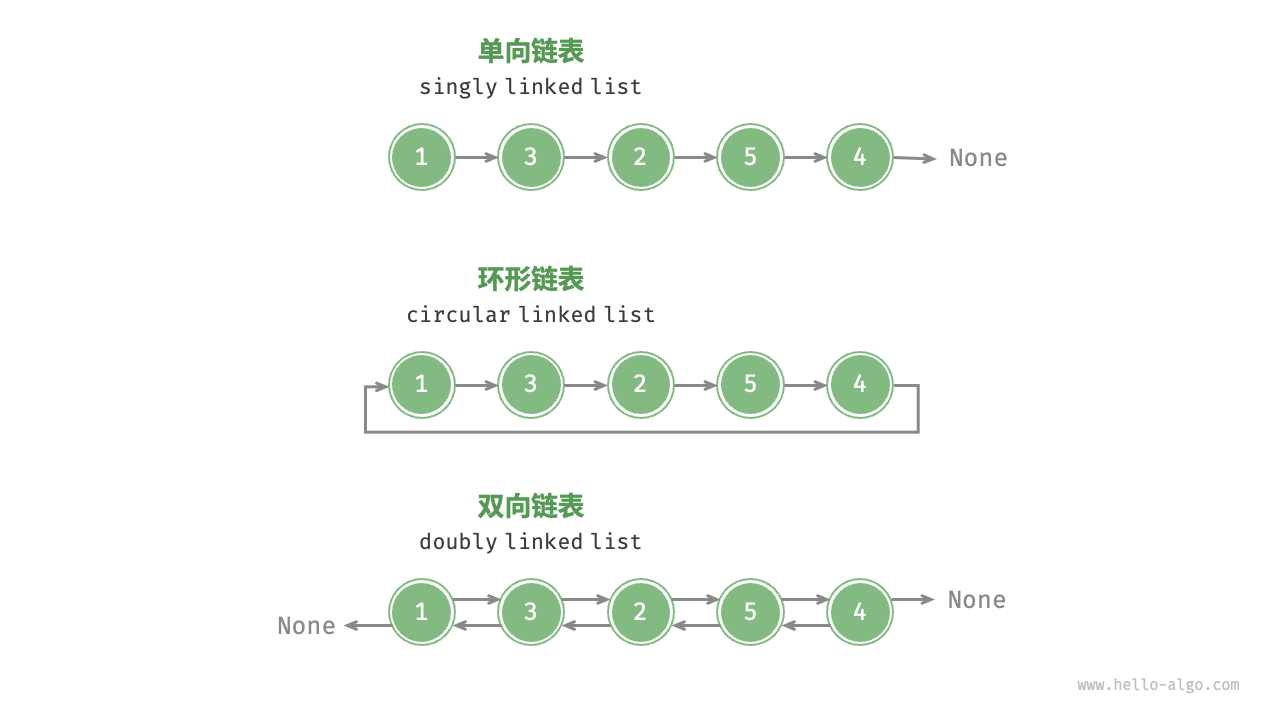
- 单向链表:单向链表的节点包含值和指向下一节点的引用两项数据。
- 环形链表:如果我们令单向链表的尾节点指向头节点(首尾相接),则得到一个环形链表。在环形链表中,任意节点都可以视作头节点。
- 双向链表:双向链表记录了两个方向的引用。双向链表的节点定义同时包含指向后继节点(下一个节点)和前驱节点(上一个节点)的引用(指针)。双向链表更具灵活性,可以朝两个方向遍历链表,但相应地也需要占用更多的内存空间。
数组 vs 链表
1.4.2.2 链表应用
- 单向链表通常用于实现栈、队列、哈希表和图等数据结构。
栈:插入和删除操作都在链表的一端–先进后出
队列:一端插入(队尾),另一端删除(队头)–先进先出
哈希表:当两个键被哈希到相同的位置时,会发生哈希冲突,使用链式地址把所有冲突的元素都会被放到一个链表中。
图:图可以用“邻接矩阵”或“邻接表”来存储。如邻接表:图的每个顶点都与一个链表相关联,链表中的每个元素都代表与该顶点相连的其他顶点。
- 双向链表常用于需要快速查找前一个和后一个元素的场景。
比如在红黑树、B 树中,我们需要访问节点的父节点,这可以通过在节点中保存一个指向父节点的引用来实现,类似于双向链表。
浏览器历史:浏览器需要知道用户访问过的前一个和后一个网页。双向链表的特性使得这种操作变得简单。
LRU 算法:在缓存淘汰(LRU)算法中,我们需要快速找到最近最少使用的数据,以及支持快速添加和删除节点。这时候使用双向链表就非常合适。
- 环形链表常用于需要周期性操作的场景,比如操作系统的资源调度。
时间片轮转调度算法:在操作系统中,时间片轮转调度算法是一种常见的 CPU 调度算法,它需要对一组进程进行循环。每个进程被赋予一个时间片,当时间片用完时,CPU将切换到下一个进程。这种循环操作可以通过环形链表来实现。
数据缓冲区:在某些数据缓冲区的实现中,也可能会使用环形链表。比如在音频、视频播放器中,数据流可能会被分成多个缓冲块并放入一个环形链表,以便实现无缝播放。
1.4.3 列表
它表示元素的有序集合,支持元素访问、修改、添加、删除和遍历等操作,无须使用者考虑容量限制的问题,列表本质上是数组,因此可以在O(1)时间内访问和更新元素,效率很高;相较于数组,列表可以自由地添加与删除元素。在列表尾部添加元素的时间复杂度为 O(1),但插入和删除元素的效率仍与数组相同,时间复杂度为O(n) ;
- 链表天然可以看作一个列表,其支持元素增删查改操作,并且可以灵活动态扩容。
- 数组也支持元素增删查改,但由于其长度不可变,因此只能看作一个具有长度限制的列表,可以使用动态数组来实现列表
常见操作:
/* 清空列表 */
nums.clear();

/* 在尾部添加元素 */
nums.push_back(1);
nums.push_back(3);

/* 在中间插入元素 */
nums.insert(nums.begin() + 1, 6);  // 在索引 3 处插入数字 6

/* 删除元素 */
nums.erase(nums.begin() + 1);      // 删除索引 3 处的元素

/* 通过索引遍历列表 */
int count = 0;
for (int i = 0; i < nums.size(); i++) {
    count += nums[i];
}

/* 直接遍历列表元素 */
count = 0;
for (int num : nums) {
    count += num;
}

/* 拼接两个列表 */
vector<int> nums1 = { 6, 8, 7, 10, 9 };
// 将列表 nums1 拼接到 nums 之后
nums.insert(nums.end(), nums1.begin(), nums1.end());

/* 排序列表 */
sort(nums.begin(), nums.end());  // 排序后,列表元素从小到大排列
1.4.4 内存与缓存
硬盘用于长期存储大量数据
内存用于临时存储程序运行中正在处理的数据
缓存则用于存储经常访问的数据和指令
在程序运行时,数据会从硬盘中被读取到内存中,供 CPU 计算使用。缓存可以看作 CPU 的一部分,它通过智能地从内存加载数据,给 CPU 提供高速的数据读取,从而显著提升程序的执行效率,减少对较慢的内存的依赖。
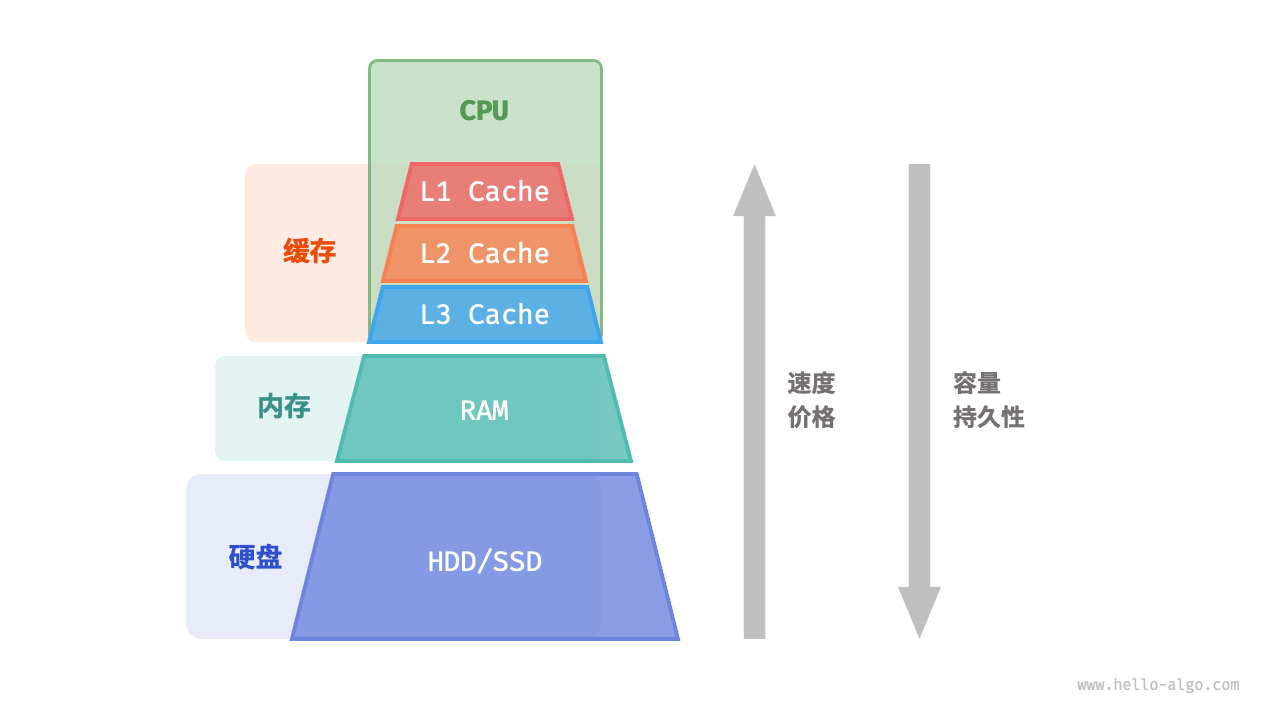
内存空间利用方面:数组和链表各自具有优势和局限性
- 内存是有限的,且同一块内存不能被多个程序共享,尽可能高效地利用空间。数组的空间效率更高。 数组需要一次性分配足够的连续内存空间,这可能导致内存浪费,数组扩容也需要额外的时间和空间成本。
- 链表以“节点”为单位进行动态内存分配和回收,提供了更大的灵活性。程序运行时,随着反复申请与释放内存,空闲内存的碎片化程度会越来越高,从而导致内存的利用效率降低,链表的元素是分散存储的,在频繁的插入与删除操作中,更容易导致内存碎片化。
数组和链表对缓存的利用效率是不同的:
占用空间:链表元素比数组元素占用空间更多,导致缓存中容纳的有效数据量更少。
缓存行:链表数据分散在内存各处,而缓存是“按行加载”的,因此加载到无效数据的比例更高。
预取机制:数组比链表的数据访问模式更具“可预测性”,即系统更容易猜出即将被加载的数据。
空间局部性:数组被存储在集中的内存空间中,因此被加载数据附近的数据更有可能即将被访问。
总体而言,数组具有更高的缓存命中率,因此它在操作效率上通常优于链表。这使得在解决算法问题时,基于数组实现的数据结构往往更受欢迎。高缓存效率并不意味着数组在所有情况下都优于链表
1.4.5 小结
问题与答案:
- 数组存储在栈上和存储在堆上,对时间效率和空间效率是否有影响?
1.数据操作效率: 存储在栈上和堆上的数组数据操作效率基本一致。
2. 分配和释放效率:栈是一块较小的内存,分配由编译器自动完成;而堆内存相对更大,可以在代码中动态分配,更容易碎片化。因此,堆上的分配和释放操作通常比栈上的慢。
3. 大小限制:栈内存相对较小,堆的大小一般受限于可用内存。因此堆更加适合存储大型数组。
4. 灵活性:栈上的数组的大小需要在编译时确定,而堆上的数组的大小可以在运行时动态确定。
- 数组要求相同类型的元素,而在链表中却没有强调相同类型呢?
数组元素通过计算偏移量来获取对应元素位置,则必须是相同类型的
元素内存地址 = 数组内存地址(首元素内存地址) + 元素长度 * 元素索引
- 删除节点 P 后,是否需要把 P.next 设为 None 呢?
不修改 P.next 也可以
- 在列表末尾添加元素是否时时刻刻都为 O(1)
如果添加元素时超出列表长度,则需要先扩容列表再添加。系统会申请一块新的内存,并将原列表的所有元素搬运过去,这时候时间复杂度就会是 O(n)
- “列表的出现极大地提高了数组的实用性,但可能导致部分内存空间浪费”,这里的空间浪费是指额外增加的变量如容量、长度、扩容倍数所占的内存吗?
一方面,列表都会设定一个初始长度,我们不一定需要用这么多;
另一方面,为了防止频繁扩容,扩容一般会乘以一个系数,这样一来,也会出现很多空位,我们通常不能完全填满它们
- Python:在 Python 中初始化 n = [1, 2, 3] 后,这 3 个元素的地址是相连的,但是初始化 m = [2, 1, 3] 会发现它们每个元素的 id 并不是连续的,而是分别跟 n 中的相同。这些元素的地址不连续,那么 m 还是数组吗?
Python 中的数字也被包装为对象,列表中存储的不是数字本身,而是对数字的引用。因此,我们会发现两个数组中的相同数字拥有同一个 id ,并且这些数字的内存地址无须连续
- C++ STL 里面的 std::list 已经实现了双向链表,但好像一些算法书上不怎么直接使用它,是不是因为有什么局限性呢?
空间开销:由于每个元素需要两个额外的指针(一个用于前一个元素,一个用于后一个元素),所以 std::list 通常比 std::vector 更占用空间。
缓存不友好:由于数据不是连续存放的,因此 std::list 对缓存的利用率较低。一般情况下,std::vector 的性能会更好。
另一方面,必要使用链表的情况主要是二叉树和图。栈和队列往往会使用编程语言提供的 stack 和 queue ,而非链表。
- Python:操作 res = [[0]] * n 生成了一个二维列表,其中每一个 [0] 都是独立的吗?
⚠️不是独立的⚠️。此二维列表中,所有的 [0] 实际上是同一个对象的引用。如果我们修改其中一个元素,会发现所有的对应元素都会随之改变。
如果希望二维列表中的每个 [0] 都是独立的,可以使用 res = [[0] for _ in range(n)] 来实现。这种方式的原理是初始化了 n个独立的 [0] 列表对象。
- Python:操作 res = [0] * n 生成了一个列表,其中每一个整数 0 都是独立的吗?
在该列表中,所有整数 0 都是同一个对象的引用。这是因为 Python 对小整数(通常是 -5 到 256)采用了缓存池机制,以便最大化对象复用,从而提升性能。
⚠️虽然它们指向同一个对象,但我们仍然可以独立修改列表中的每个元素,这是因为 Python 的整数是“不可变对象”。当我们修改某个元素时,实际上是切换为另一个对象的引用,而不是改变原有对象本身。
⚠️然而,当列表元素是“可变对象”时(例如列表、字典或类实例等),修改某个元素会直接改变该对象本身,所有引用该对象的元素都会产生相同变化。
1.5 栈与队列
1.5.1栈
栈(stack)是一种遵循先入后出逻辑的线性数据结构。后进先出LIFO
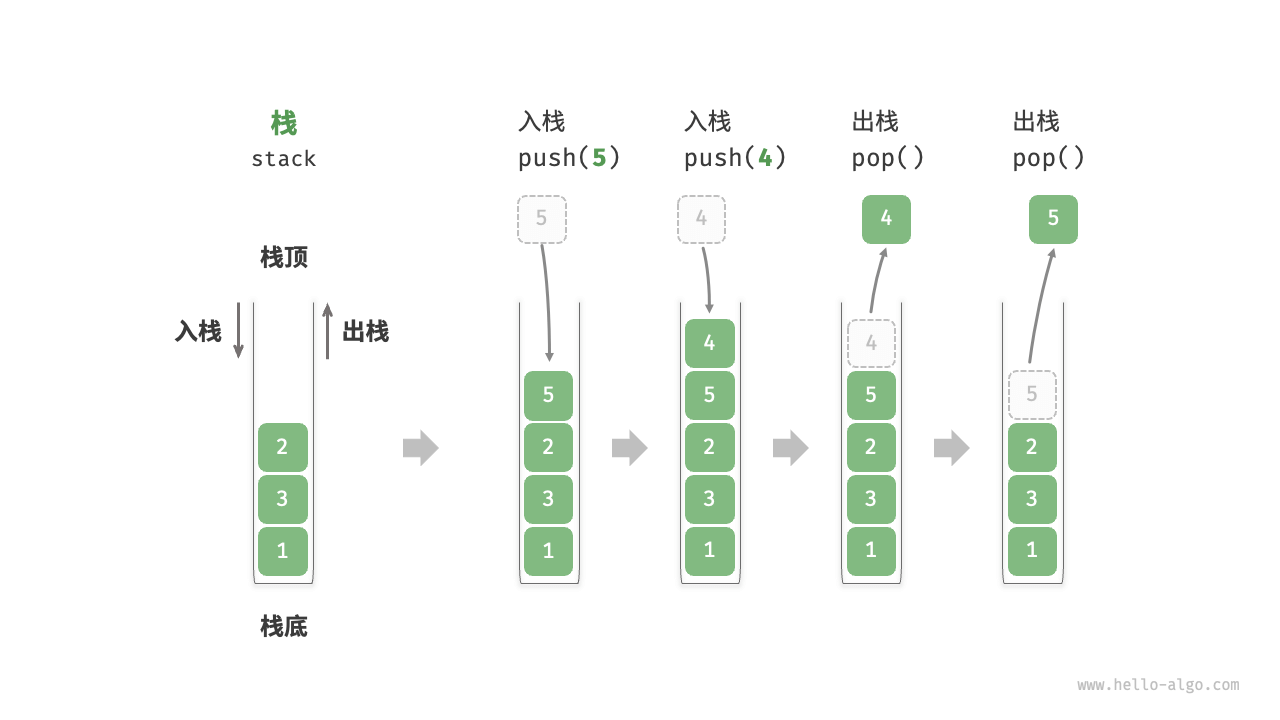
常见操作:
/* 初始化栈 */
stack<int> stack;

/* 元素入栈 */
stack.push(1);

/* 访问栈顶元素 */
int top = stack.top();

/* 元素出栈 */
stack.pop(); // 无返回值

/* 获取栈的长度 */
int size = stack.size();

/* 判断是否为空 */
bool empty = stack.empty();
1.5.1.1 基于链表的实现
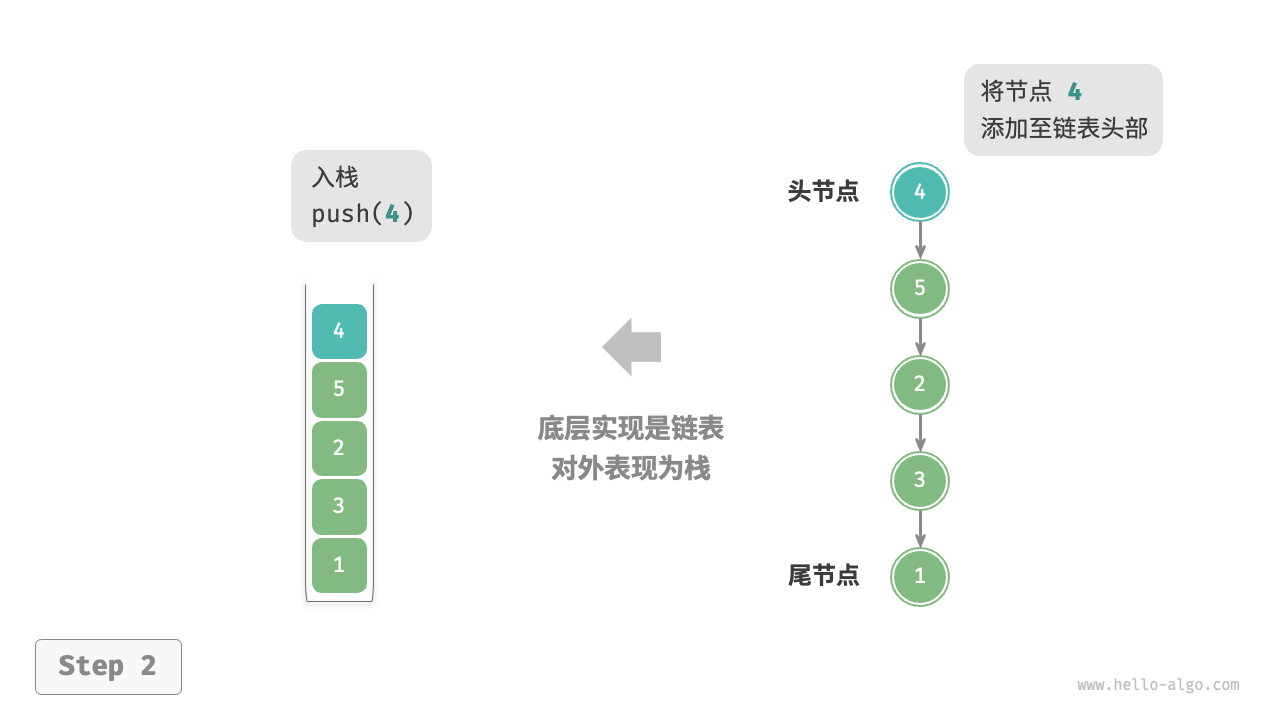
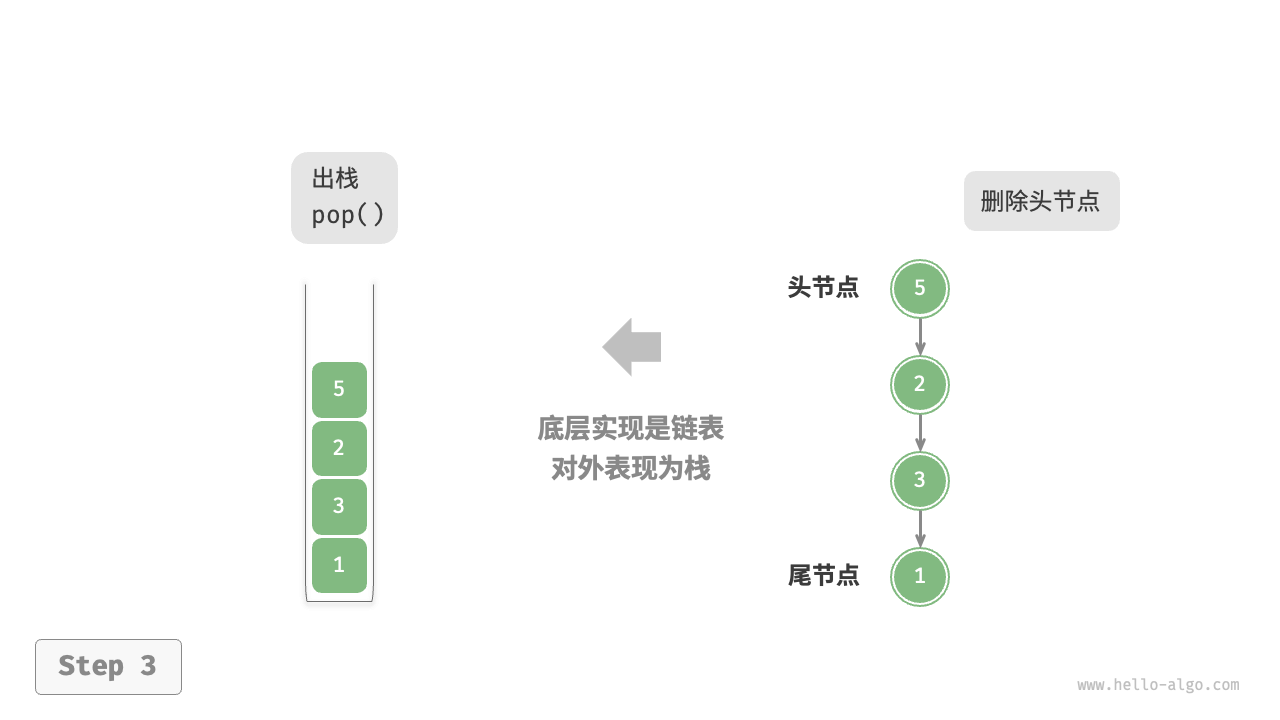
使用链表实现栈时,我们可以将链表的头节点视为栈顶,尾节点视为栈底。
- 基于链表实现的栈可以提供更加稳定的效率表现。
- 链表节点需要额外存储指针,因此链表节点占用的空间相对较大
入栈:
入栈前:
stackTop → [原栈顶A] → [B] → [C] → nullptr
入栈一个新元素 X 之后执行:
node->next = stackTop;
node(X)->next → [A] → [B] → [C] → nullptr
入栈:
stackTop = node;
stackTop → [X] → [A] → [B] → [C] → nullptr/* 入栈 */ void push(int num) { //创建一个新的节点 node,其中存放值 num。 ListNode *node = new ListNode(num); node->next = stackTop; stackTop = node; stkSize++; }出栈:
  /* 出栈 */
  int pop() {
  		int num = top();
  		ListNode *tmp = stackTop;
       stackTop = stackTop->next;
       delete tmp;
       stkSize--;
       return num;
  }
1.5.1.2 基于数组的实现
使用数组实现栈时,我们可以将数组的尾部作为栈顶。
- 数组实现额外支持随机访问,但这已超出了栈的定义范畴,因此一般不会用到
- 基于数组实现的栈在触发扩容时效率会降低,但由于扩容是低频操作,因此平均效率更高。
入栈:
/* 入栈 */ vector<int> stack; void push(int num) { stack.push_back(num); }出栈:
 /* 出栈 */
 int pop() {
     int num = top();
     stack.pop_back();
     return num;
 }
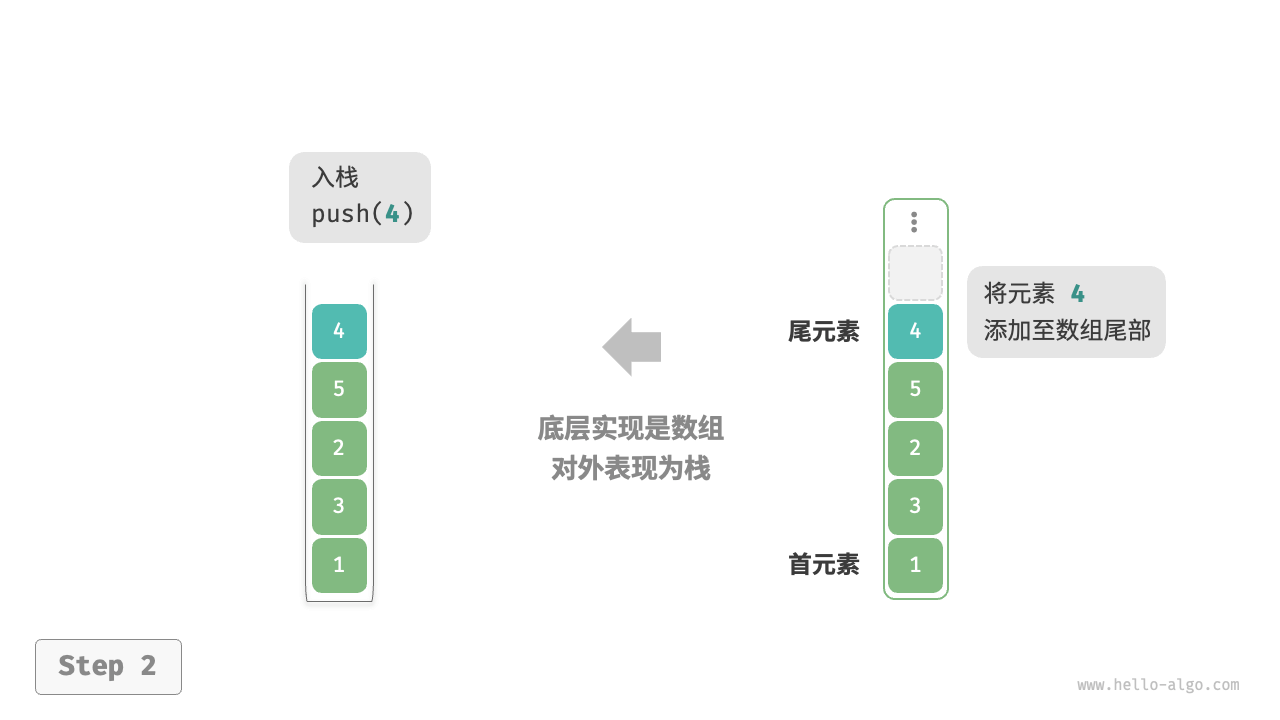
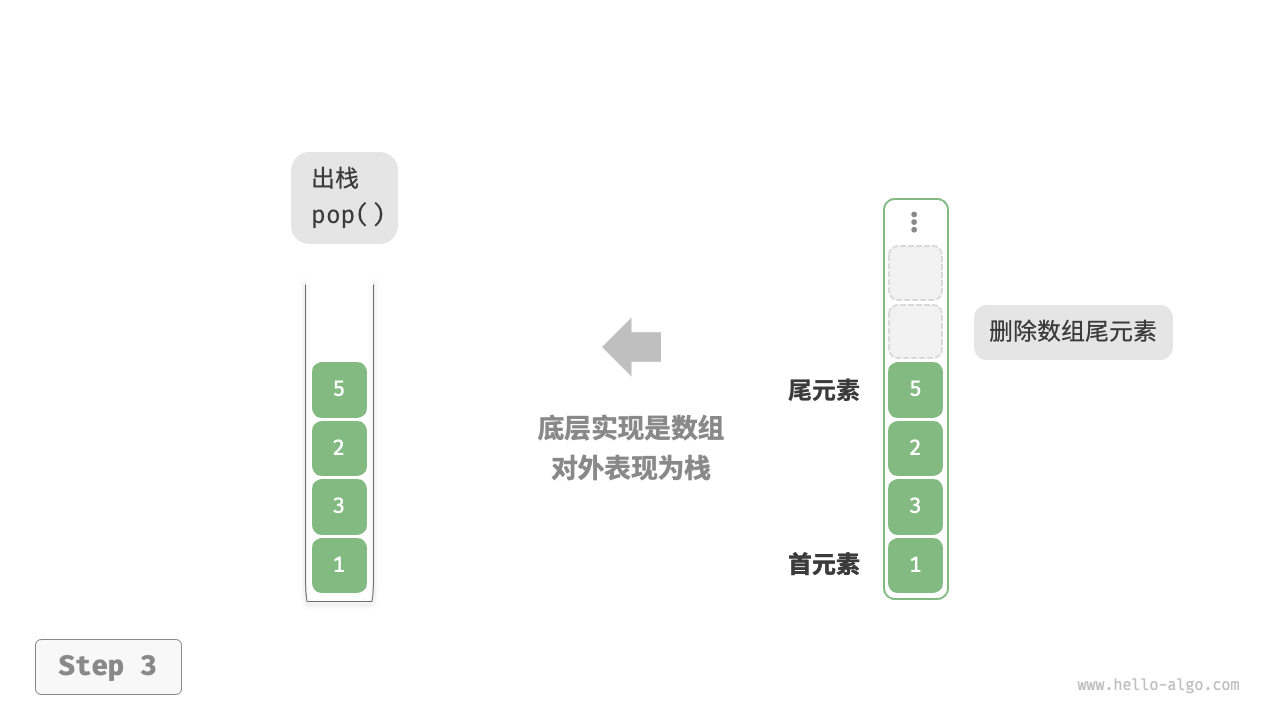
1.5.2队列
队列(queue)是一种遵循先入先出规则的线性数据结构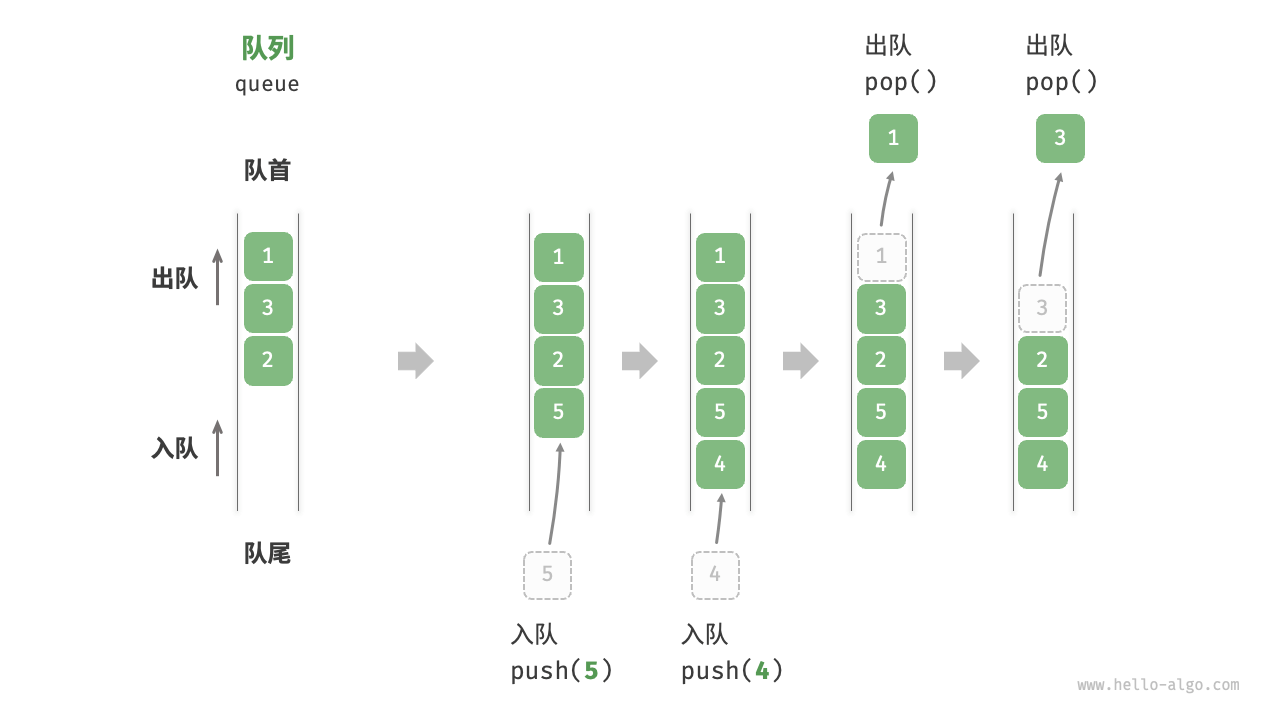
常见操作:
/* 初始化队列 */
queue<int> queue;

/* 元素入队 */
queue.push(1);

/* 访问队首元素 */
int front = queue.front();

/* 元素出队 */
queue.pop();

/* 获取队列的长度 */
int size = queue.size();

/* 判断队列是否为空 */
bool empty = queue.empty();
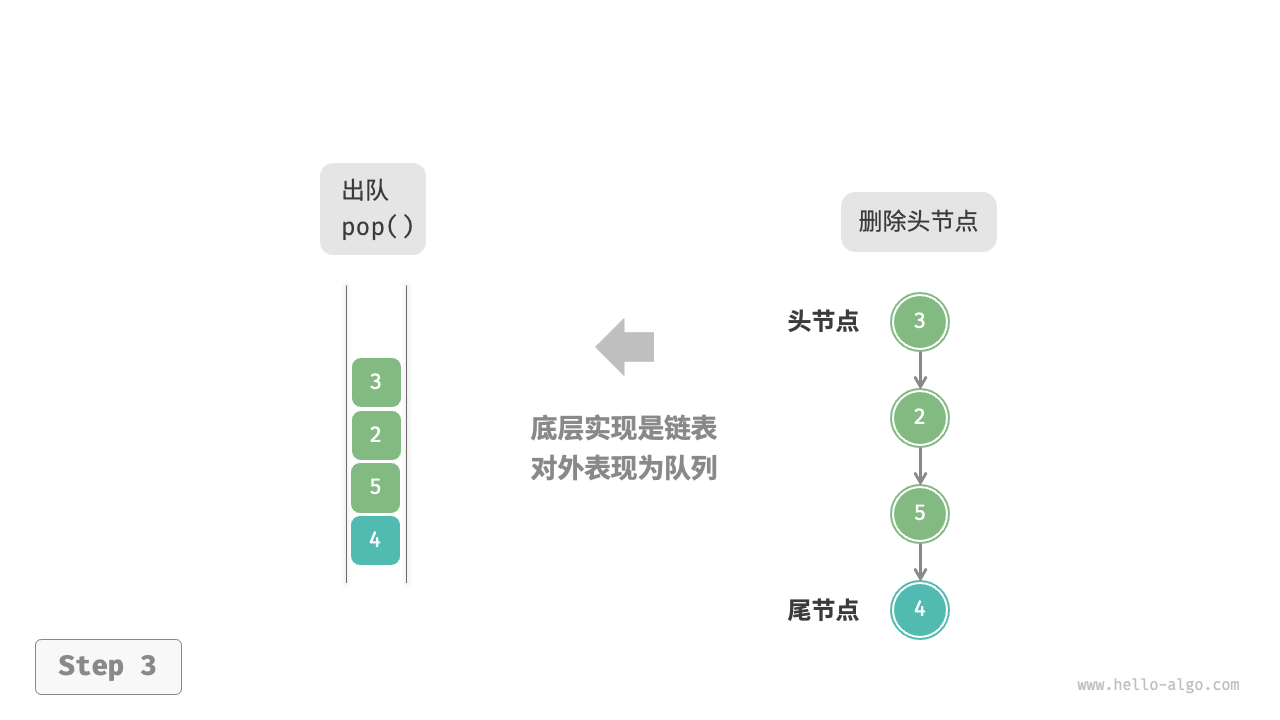
1.5.2.1 基于链表的实现
们可以将链表的“头节点”和“尾节点”分别视为“队首”和“队尾”,规定队尾仅可添加节点,队首仅可删除节点。
入队:
/* 入队 */ void push(int num) { // 在尾节点后添加 num ListNode *node = new ListNode(num); // 如果队列为空,则令头、尾节点都指向该节点 if (front == nullptr) { front = node; rear = node; } // 如果队列不为空,则将该节点添加到尾节点后 else { rear->next = node; rear = node; } queSize++; }出队:
 /* 出队 */
 int pop() {
     int num = peek();
     // 删除头节点
    ListNode *tmp = front;
    front = front->next;
     // 释放内存
     delete tmp;
    queSize--;
    return num;
}
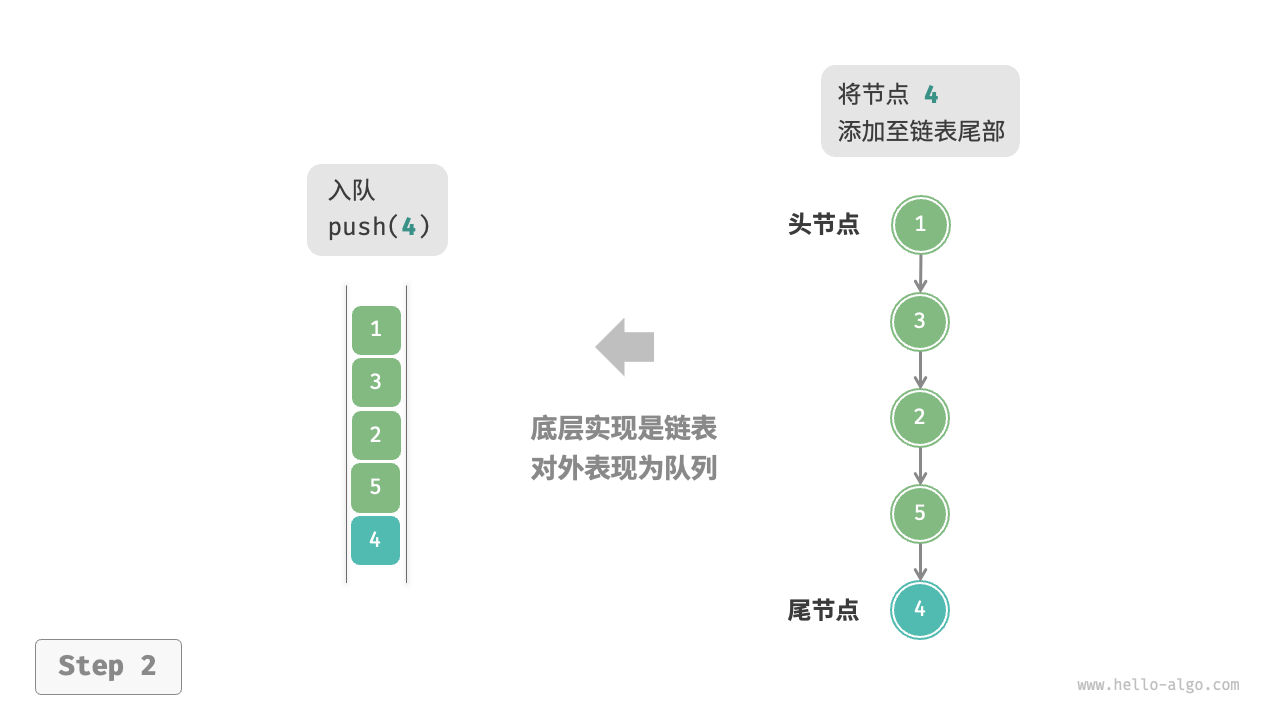
1.5.2.2 基于数组的实现
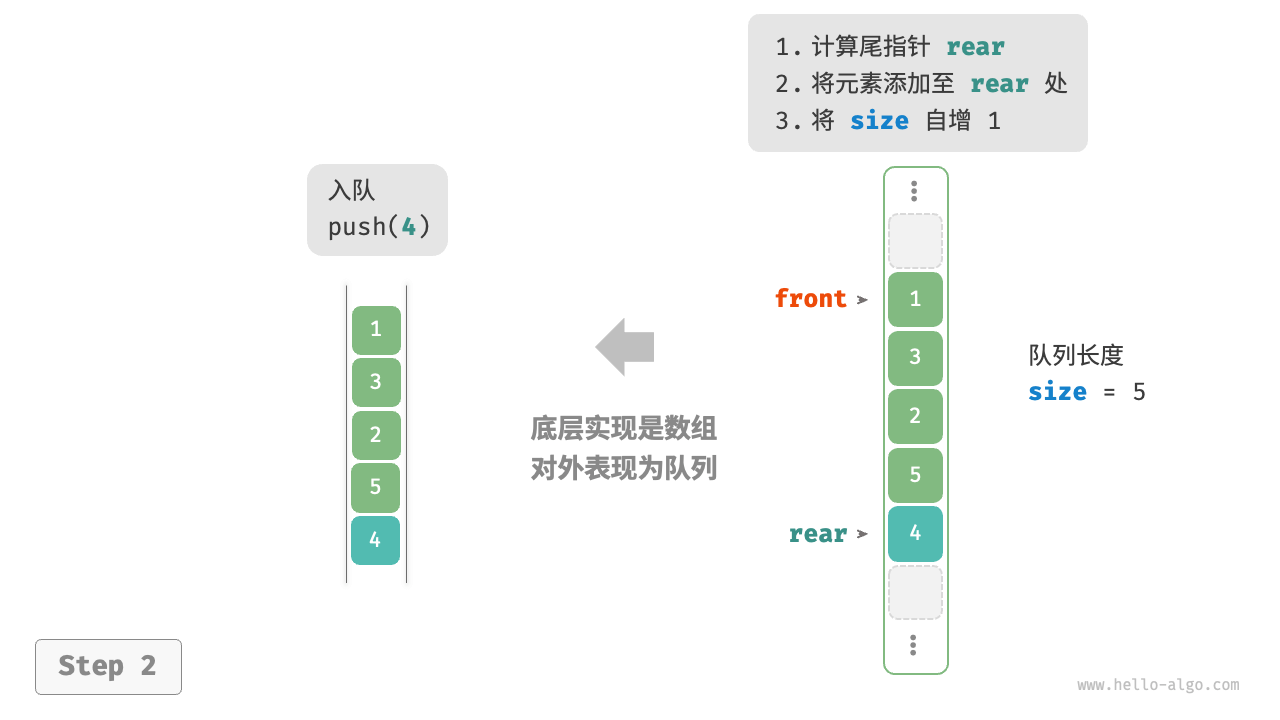
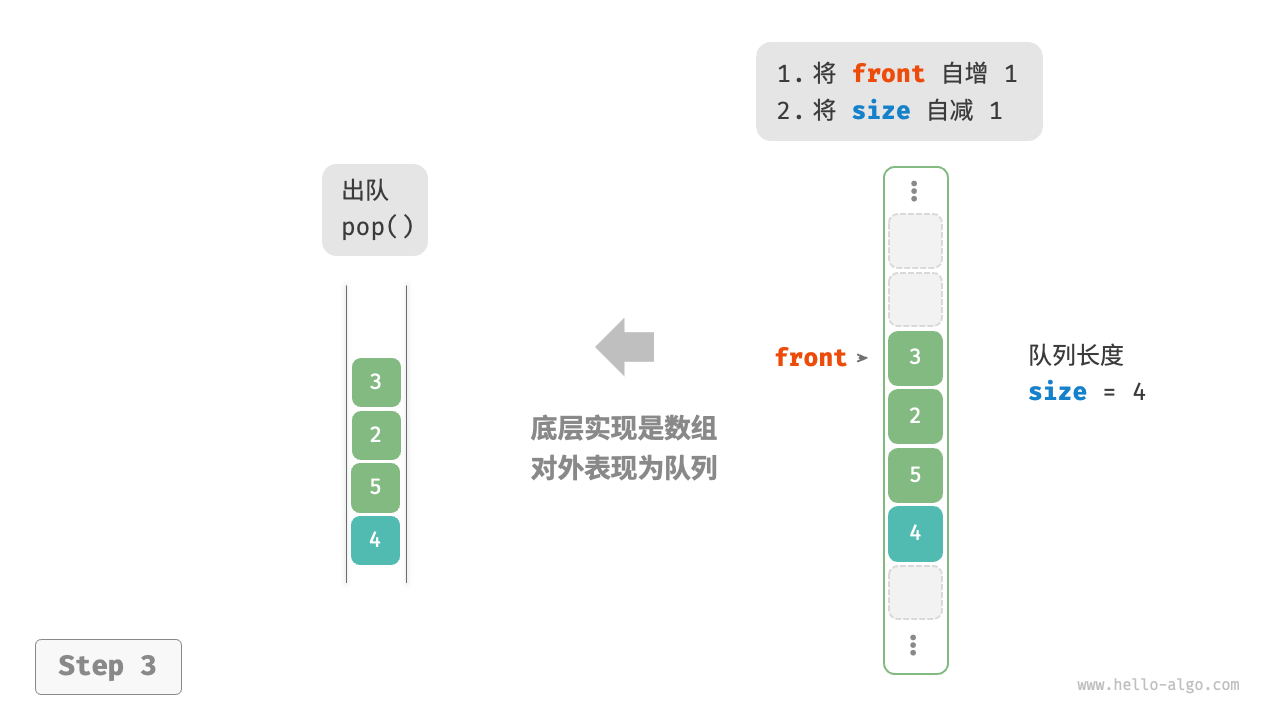
数组中删除首元素的时间复杂度为O(n) ,这会导致出队操作效率较低,
可以使用一个变量 front 指向队首元素的索引,并维护一个变量 size 用于记录队列长度
定义 rear = front + size,这个公式计算出的 rear 指向队尾元素之后的下一个位置
基于此设计,数组中包含元素的有效区间为 [front, rear - 1]
入队和出队操作都只需进行一次操作,时间复杂度均为O(1)
在不断进行入队和出队的过程中,front 和 rear 都在向右移动,当它们到达数组尾部时就无法继续移动了?
为了解决此问题,我们可以将数组视为首尾相接的“环形数组”,我们需要让 front 或 rear 在越过数组尾部时,直接回到数组头部继续遍历。这种周期性规律可以通过“取余操作”来实现
入队:
入队操作:将输入元素赋值给 rear 索引处,并将 size 增加 1
/* 入队 */ void push(int num) { if (queSize == queCapacity) { cout << "队列已满" << endl; return; } // 计算队尾指针,指向队尾索引 + 1 // 通过取余操作实现 rear 越过数组尾部后回到头部 int rear = (front + queSize) % queCapacity; // 将 num 添加至队尾 nums[rear] = num; queSize++; }出队:
 /* 出队 */
 int pop() {
     int num = peek();
    // 队首指针向后移动一位,若越过尾部,则返回到数组头部
     front = (front + 1) % queCapacity;
     queSize--;
     return num;
}
1.5.3 双向队列
允许在头部和尾部执行元素的添加或删除操作
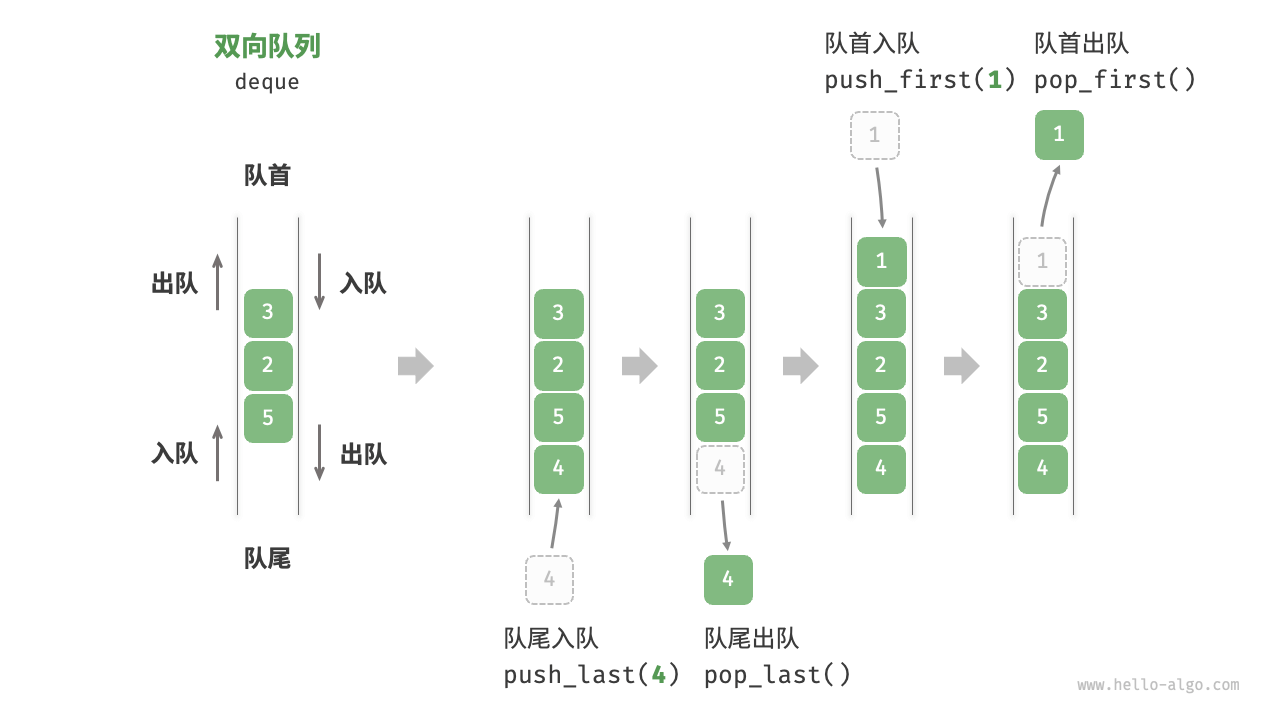
常见操作:
/* 初始化双向队列 */
deque<int> deque;

/* 元素入队 */
deque.push_back(2);   // 添加至队尾
deque.push_front(3);  // 添加至队首

/* 访问元素 */
int front = deque.front(); // 队首元素
int back = deque.back();   // 队尾元素

/* 元素出队 */
deque.pop_front();  // 队首元素出队
deque.pop_back();   // 队尾元素出队

/* 获取双向队列的长度 */
int size = deque.size();

/* 判断双向队列是否为空 */
bool empty = deque.empty();
1.5.3.1 基于双向链表的实现
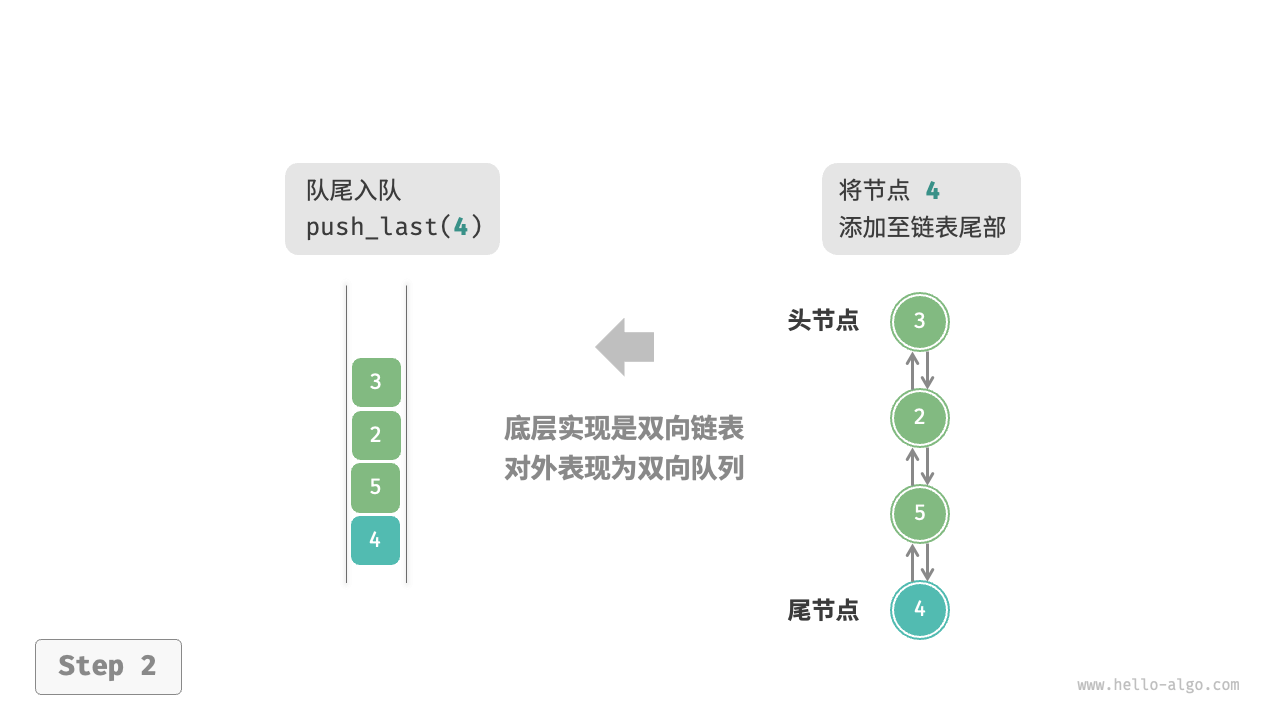
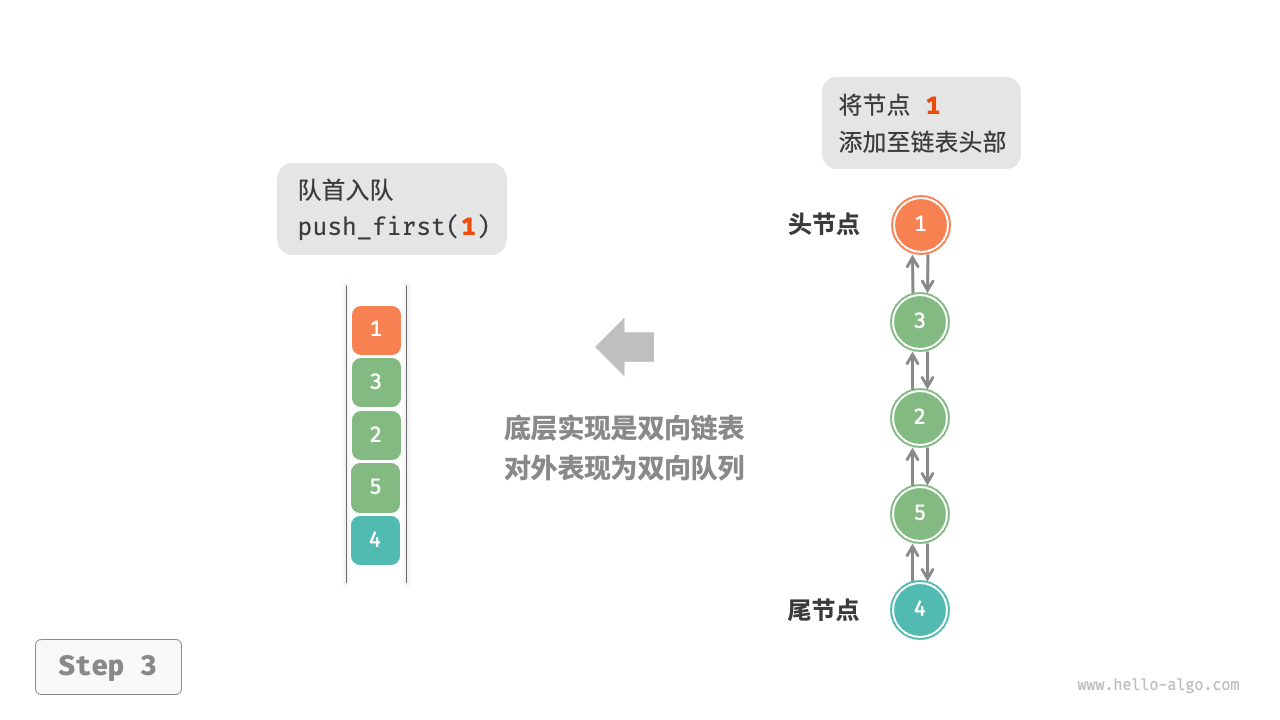
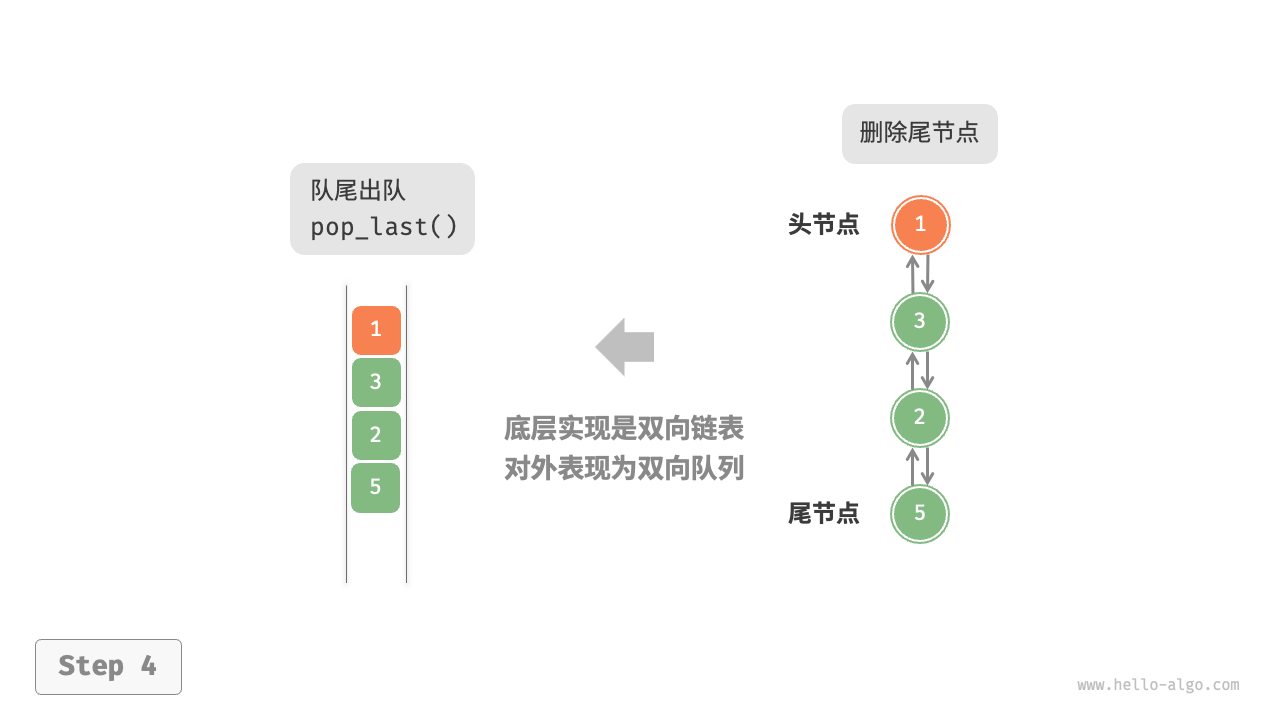
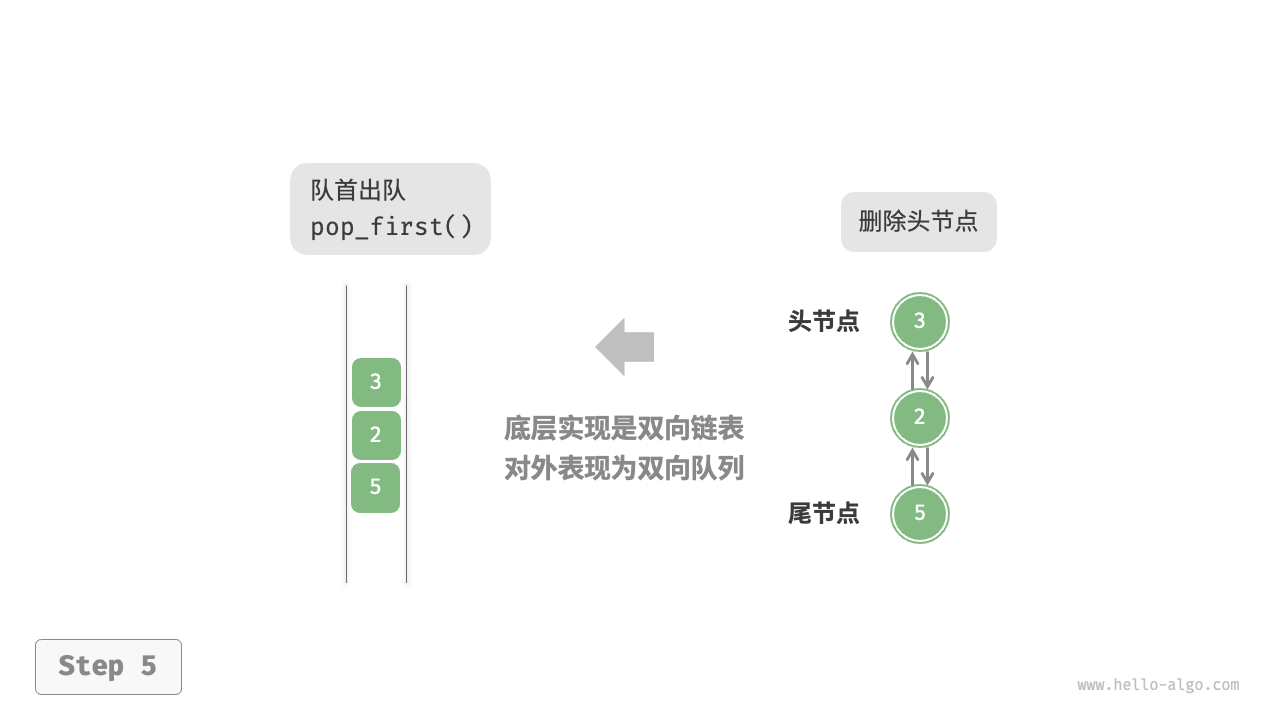
我们将双向链表的头节点和尾节点视为双向队列的队首和队尾,同时实现在两端添加和删除节点的功能
入队:
/* 入队操作 */ void push(int num, bool isFront) { DoublyListNode *node = new DoublyListNode(num); // 若链表为空,则令 front 和 rear 都指向 node if (isEmpty()) front = rear = node; // 队首入队操作 else if (isFront) { // 将 node 添加至链表头部 front->prev = node; node->next = front; front = node; // 更新头节点 // 队尾入队操作 } else { // 将 node 添加至链表尾部 rear->next = node; node->prev = rear; rear = node; // 更新尾节点 } queSize++; // 更新队列长度 } /* 队首入队 */ void pushFirst(int num) { push(num, true); } /* 队尾入队 */ void pushLast(int num) { push(num, false); }出队:
    /* 出队操作 */
    int pop(bool isFront) {
        if (isEmpty())
            throw out_of_range("队列为空");
        int val;
        // 队首出队操作
        if (isFront) {
            val = front->val; // 暂存头节点值
            // 删除头节点
            DoublyListNode *fNext = front->next;
            if (fNext != nullptr) {
                fNext->prev = nullptr;
                front->next = nullptr;
            }
            delete front;
            front = fNext; // 更新头节点
        // 队尾出队操作
        } else {
            val = rear->val; // 暂存尾节点值
            // 删除尾节点
            DoublyListNode *rPrev = rear->prev;
            if (rPrev != nullptr) {
                rPrev->next = nullptr;
                rear->prev = nullptr;
            }
            delete rear;
            rear = rPrev; // 更新尾节点
        }
        queSize--; // 更新队列长度
        return val;
    }

    /* 队首出队 */
    int popFirst() {
        return pop(true);
    }

    /* 队尾出队 */
    int popLast() {
        return pop(false);
    }
1.5.3.1 基于数组的实现
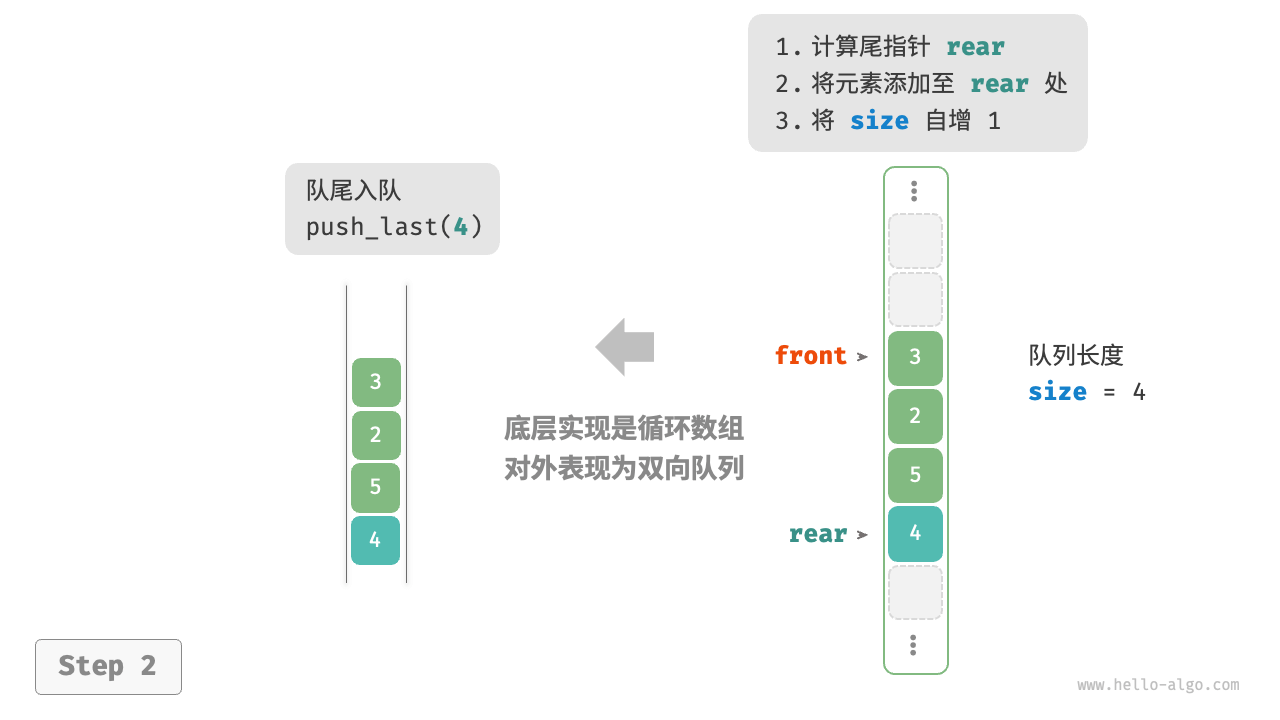
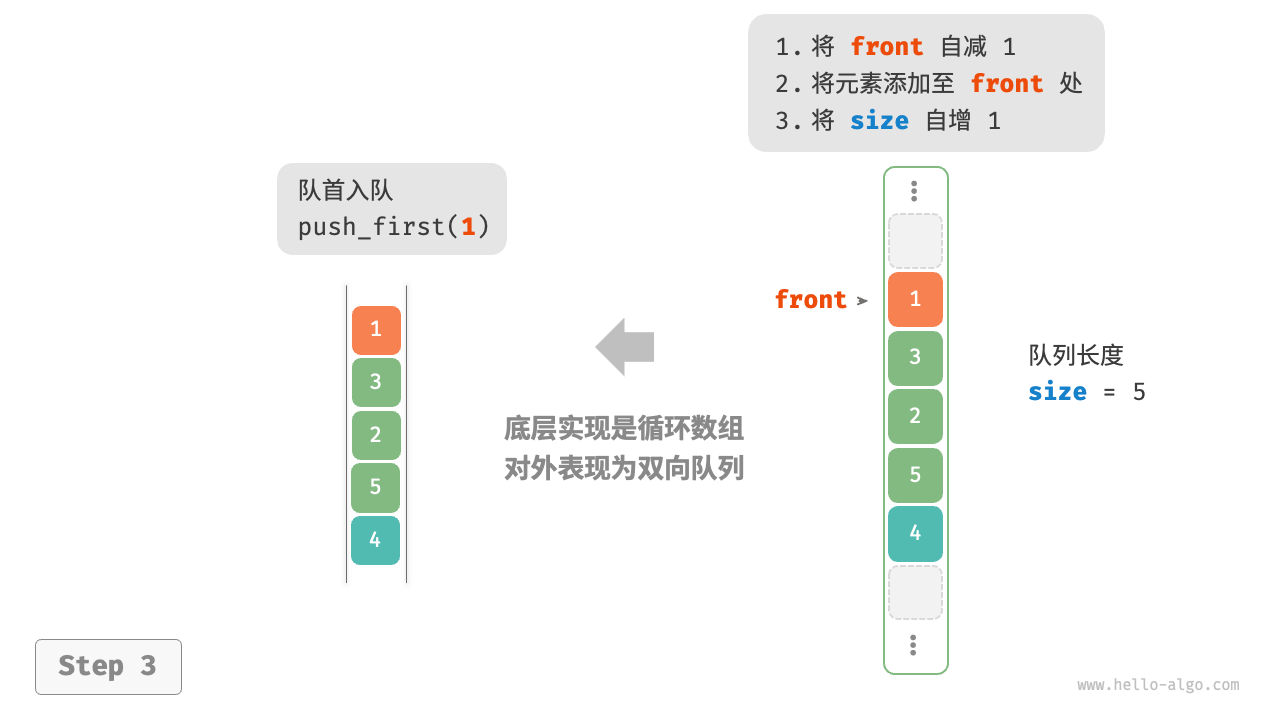
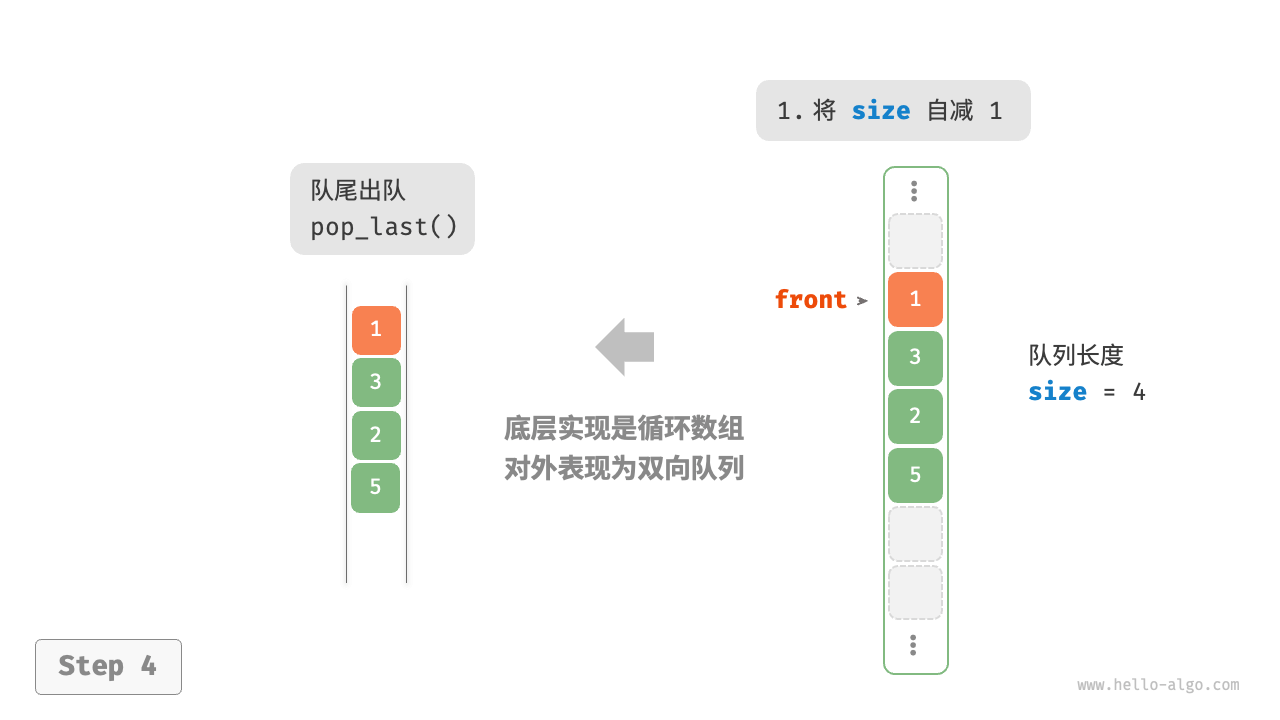
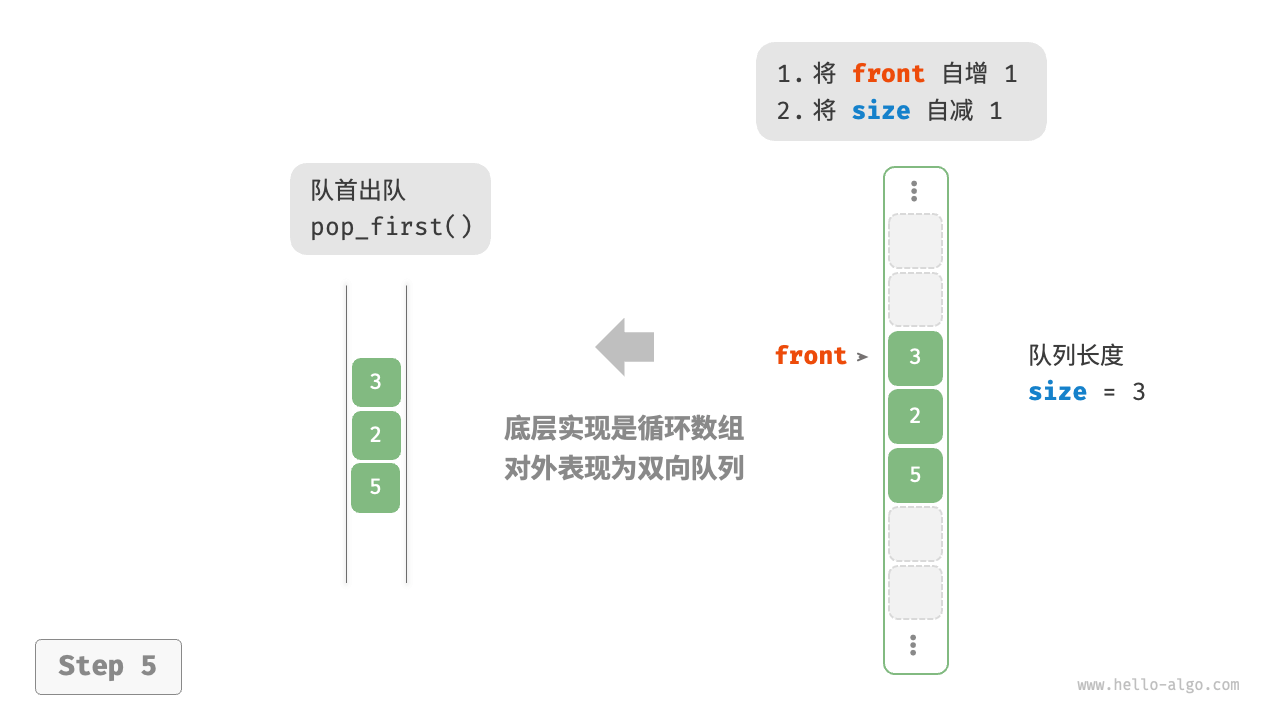
我们也可以使用环形数组来实现双向队列
入队:
/* 计算环形数组索引 */ int index(int i) { // 通过取余操作实现数组首尾相连 // 当 i 越过数组尾部后,回到头部 // 当 i 越过数组头部后,回到尾部 return (i + capacity()) % capacity(); } /* 队首入队 */ void pushFirst(int num) { if (queSize == capacity()) { cout << "双向队列已满" << endl; return; } // 队首指针向左移动一位 // 通过取余操作实现 front 越过数组头部后回到尾部 front = index(front - 1); // 将 num 添加至队首 nums[front] = num; queSize++; } /* 队尾入队 */ void pushLast(int num) { if (queSize == capacity()) { cout << "双向队列已满" << endl; return; } // 计算队尾指针,指向队尾索引 + 1 int rear = index(front + queSize); // 将 num 添加至队尾 nums[rear] = num; queSize++; }出队:
    /* 队首出队 */
    int popFirst() {
        int num = peekFirst();
        // 队首指针向后移动一位
        front = index(front + 1);
        queSize--;
        return num;
    }

    /* 队尾出队 */
    int popLast() {
        int num = peekLast();
        queSize--;
        return num;
    }
1.5.4 小结
- 双向队列像是两个栈拼接在了一起,它的用途是什么?
双向队列就像是栈和队列的组合或两个栈拼在了一起。它表现的是栈 + 队列的逻辑,因此可以实现栈与队列的所有应用,并且更加灵活。
- 撤销(undo)和反撤销(redo)具体是如何实现的?
使用两个栈,栈 A 用于撤销,栈 B 用于反撤销。
- 每当用户执行一个操作,将这个操作压入栈 A ,并清空栈 B 。
- 当用户执行“撤销”时,从栈 A 中弹出最近的操作,并将其压入栈 B 。
- 当用户执行“反撤销”时,从栈 B 中弹出最近的操作,并将其压入栈 A 。
1.6 哈希表
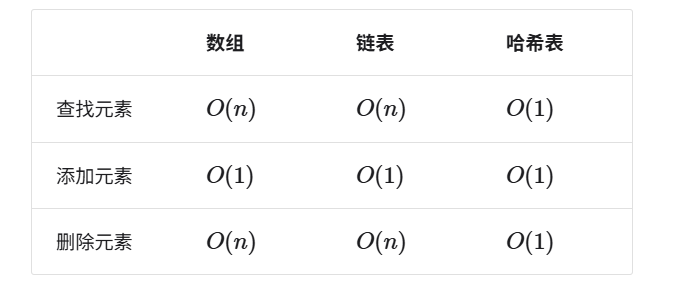
向哈希表中输入一个键 key ,则可以在 O(1)时间内获取对应的值 value
- 添加:加在末尾
- 查询:由于数组(链表)是乱序的,因此需要遍历其中的所有元素
- 删除:需要先查询到元素,再从数组(链表)中删除
常见操作:
/* 初始化哈希表 */
unordered_map<int, string> map;

/* 添加操作 */
// 在哈希表中添加键值对 (key, value)
map[12836] = "小哈";
map[15937] = "小啰";
/* 查询操作 */
// 向哈希表中输入键 key ,得到值 value
string name = map[15937];

/* 删除操作 */
// 在哈希表中删除键值对 (key, value)
map.erase(12836);

/* 遍历哈希表 */
// 遍历键值对 key->value
for (auto kv: map) {
    cout << kv.first << " -> " << kv.second << endl;
}
// 使用迭代器遍历 key->value
for (auto iter = map.begin(); iter != map.end(); iter++) {
    cout << iter->first << "->" << iter->second << endl;
}
1.6.1 基于数组实现哈希表
在哈希表中,输入空间是所有 key ,输出空间是所有桶(数组索引)。
通过哈希函数得到该 key 对应的键值对在数组中的存储位置步骤
- 通过某种哈希算法 hash() 计算得到哈希值。
- 将哈希值对桶数量(数组长度)capacity 取模,从而获取该 key 对应的桶(数组索引)index 。
index = hash(key) % capacity
我们将 key 和 value 封装成一个类 Pair ,以表示键值对
/* 键值对 */
struct Pair {
  public:
    int key;
    string val;
    Pair(int key, string val) {
        this->key = key;
        this->val = val;
    }
};

/* 基于数组实现的哈希表 */
class ArrayHashMap {
  private:
    vector<Pair *> buckets;

  public:
    ArrayHashMap() {
        // 初始化数组,包含 100 个桶
        //buckets 是一个 vector(动态数组),里面存的是 Pair* 指针,也就是存储每个键值对的地址。
        //buckets[index] 取出来的东西是一个 指针,类型是 Pair*
        buckets = vector<Pair *>(100);
    }

    ~ArrayHashMap() {
        // 释放内存
        //对于每个指针 bucket,如果它指向了 Pair 对象,需要 delete 释放内存
        for (const auto &bucket : buckets) {
            delete bucket;
        }
        //最后 buckets.clear() 清空整个数组
        buckets.clear();
    }

    /* 哈希函数 */
    int hashFunc(int key) {
        int index = key % 100;
        return index;
    }

    /* 查询操作 */
    string get(int key) {
        int index = hashFunc(key);
        Pair *pair = buckets[index];
        if (pair == nullptr)
            return "";
        return pair->val;
    }

    /* 添加操作 */
    void put(int key, string val) {
        Pair *pair = new Pair(key, val);
        int index = hashFunc(key);
        buckets[index] = pair;
    }

    /* 删除操作 */
    void remove(int key) {
        int index = hashFunc(key);
        // 释放内存并置为 nullptr
        //之前用 new Pair(key, val) 动态创建了对象
        //delete 只是释放了内存,但指针本身还存在,指向一个已经被释放的内存区域
        delete buckets[index];
        buckets[index] = nullptr;
    }

    /* 获取所有键值对 */
    vector<Pair *> pairSet() {
        vector<Pair *> pairSet;
        for (Pair *pair : buckets) {
            if (pair != nullptr) {
                pairSet.push_back(pair);
            }
        }
        return pairSet;
    }

    /* 获取所有键 */
    vector<int> keySet() {
        vector<int> keySet;
        for (Pair *pair : buckets) {
            if (pair != nullptr) {
                keySet.push_back(pair->key);
            }
        }
        return keySet;
    }

    /* 获取所有值 */
    vector<string> valueSet() {
        vector<string> valueSet;
        for (Pair *pair : buckets) {
            if (pair != nullptr) {
                valueSet.push_back(pair->val);
            }
        }
        return valueSet;
    }

    /* 打印哈希表 */
    void print() {
        for (Pair *kv : pairSet()) {
            cout << kv->key << " -> " << kv->val << endl;
        }
    }
};
注意
-
哈希函数的作用是将所有 key 构成的输入空间映射到数组所有索引构成的输出空间,而输入空间往往远大于输出空间。因此,理论上一定存在“多个输入对应相同输出”的情况。
-
容易想到,哈希表容量 越大,多个 key 被分配到同一个桶中的概率就越低,冲突就越少。因此,我们可以通过扩容哈希表来减少哈希冲突
-
类似于数组扩容,哈希表扩容需将所有键值对从原哈希表迁移至新哈希表,非常耗时;并且由于哈希表容量 capacity 改变,我们需要通过哈希函数来重新计算所有键值对的存储位置,这进一步增加了扩容过程的计算开销。为此,编程语言通常会预留足够大的哈希表容量,防止频繁扩容。
/* 链式地址哈希表 */
class HashMapChaining {
  private:
    int size;                       // 键值对数量
    int capacity;                   // 哈希表容量
    double loadThres;               // 触发扩容的负载因子阈值
    int extendRatio;                // 扩容倍数
    vector<vector<Pair *>> buckets; // 桶数组

  public:
    /* 构造方法 */
    HashMapChaining() : size(0), capacity(4), loadThres(2.0 / 3.0), extendRatio(2) {
        buckets.resize(capacity);
    }

    /* 析构方法 */
    ~HashMapChaining() {
        for (auto &bucket : buckets) {
            for (Pair *pair : bucket) {
                // 释放内存
                delete pair;
            }
        }
    }

    /* 哈希函数 */
    int hashFunc(int key) {
        return key % capacity;
    }

    /* 负载因子 */
    double loadFactor() {
        return (double)size / (double)capacity;
    }

    /* 查询操作 */
    string get(int key) {
        int index = hashFunc(key);
        // 遍历桶,若找到 key ,则返回对应 val
        for (Pair *pair : buckets[index]) {
            if (pair->key == key) {
                return pair->val;
            }
        }
        // 若未找到 key ,则返回空字符串
        return "";
    }

    /* 添加操作 */
    void put(int key, string val) {
        // 当负载因子超过阈值时,执行扩容
        if (loadFactor() > loadThres) {
            extend();
        }
        int index = hashFunc(key);
        // 遍历桶,若遇到指定 key ,则更新对应 val 并返回
        //key 已存在 → 找到原节点,直接 用新的 val 覆盖原来的 val,不新增节点。
        for (Pair *pair : buckets[index]) {
            if (pair->key == key) {
                pair->val = val;
                return;
            }
        }
        // 若无该 key ,则将键值对添加至尾部
        buckets[index].push_back(new Pair(key, val));
        size++;
    }

    /* 删除操作 */
    void remove(int key) {
        int index = hashFunc(key);
        auto &bucket = buckets[index];
        // 遍历桶,从中删除键值对
        for (int i = 0; i < bucket.size(); i++) {
            if (bucket[i]->key == key) {
                // ① 先保存指针
                //保存指针:因为一会儿要 delete,不能直接用 bucket[i],否则 erase 会把它移除,指针就找不到了。
                Pair *tmp = bucket[i];
                // ② 从 vector 中删除元素
                bucket.erase(bucket.begin() + i); // 从中删除键值对
                // ③ 释放堆上的 Pair 对象
                delete tmp;                       // 释放内存
                size--;
                return;
            }
        }
    }

    /* 扩容哈希表 */
    void extend() {
        // 暂存原哈希表
        vector<vector<Pair *>> bucketsTmp = buckets;
        // 初始化扩容后的新哈希表
        capacity *= extendRatio;
        buckets.clear();
        buckets.resize(capacity);
        size = 0;
        // 将键值对从原哈希表搬运至新哈希表
        for (auto &bucket : bucketsTmp) {
            for (Pair *pair : bucket) {
                put(pair->key, pair->val);
                // 释放内存
                delete pair;
            }
        }
    }

    /* 打印哈希表 */
    void print() {
        for (auto &bucket : buckets) {
            cout << "[";
            for (Pair *pair : bucket) {
                cout << pair->key << " -> " << pair->val << ", ";
            }
            cout << "]\n";
        }
    }
};
1.6.2 哈希冲突
通常情况下哈希函数的输入空间远大于输出空间,进行哈希表扩容,直至冲突消失为止。此方法简单粗暴且有效,但效率太低
改良哈希表数据结构,使得哈希表可以在出现哈希冲突时正常工作。
仅在必要时,即当哈希冲突比较严重时,才执行扩容操作。
1.6.2.1 哈希冲突-链式地址
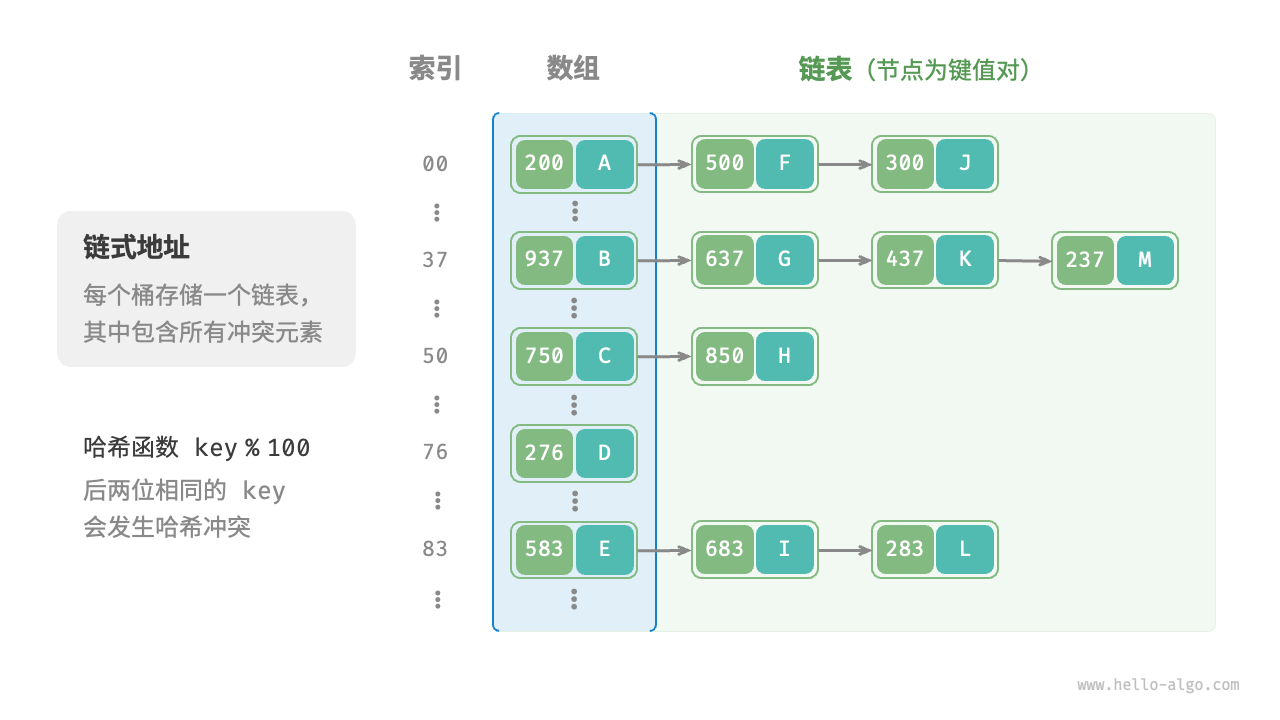
原始哈希表中,每个桶仅能存储一个键值对。链式地址(separate chaining)将单个元素转换为链表,将键值对作为链表节点,将所有发生冲突的键值对都存储在同一链表中
-
查询元素:输入 key ,经过哈希函数得到桶索引,即可访问链表头节点,然后遍历链表并对比 key 以查找目标键值对。
-
添加元素:首先通过哈希函数访问链表头节点,然后将节点(键值对)添加到链表中。
-
删除元素:根据哈希函数的结果访问链表头部,接着遍历链表以查找目标节点并将其删除。
-
局限性
- 占用空间增大:链表包含节点指针,它相比数组更加耗费内存空间。
- 查询效率降低:因为需要线性遍历链表来查找对应元素
当链表很长时,查询效率O(n)很差。此时可以将链表转换为“AVL 树”或“红黑树”,从而将查询操作的时间复杂度优化至O(logn)
1.6.2.1 哈希冲突-开放寻址
开放寻址(open addressing)不引入额外的数据结构,而是通过“多次探测”来处理哈希冲突,探测方式主要包括线性探测、平方探测和多次哈希等。
-
插入元素:通过哈希函数计算桶索引,若发现桶内已有元素,则从冲突位置向后线性遍历(步长通常为1),直至找到空桶,将元素插入其中。
-
查找元素:若发现哈希冲突,则使用相同步长向后进行线性遍历,直到找到对应元素,返回 value 即可;如果遇到空桶,说明目标元素不在哈希表中,返回 None 。
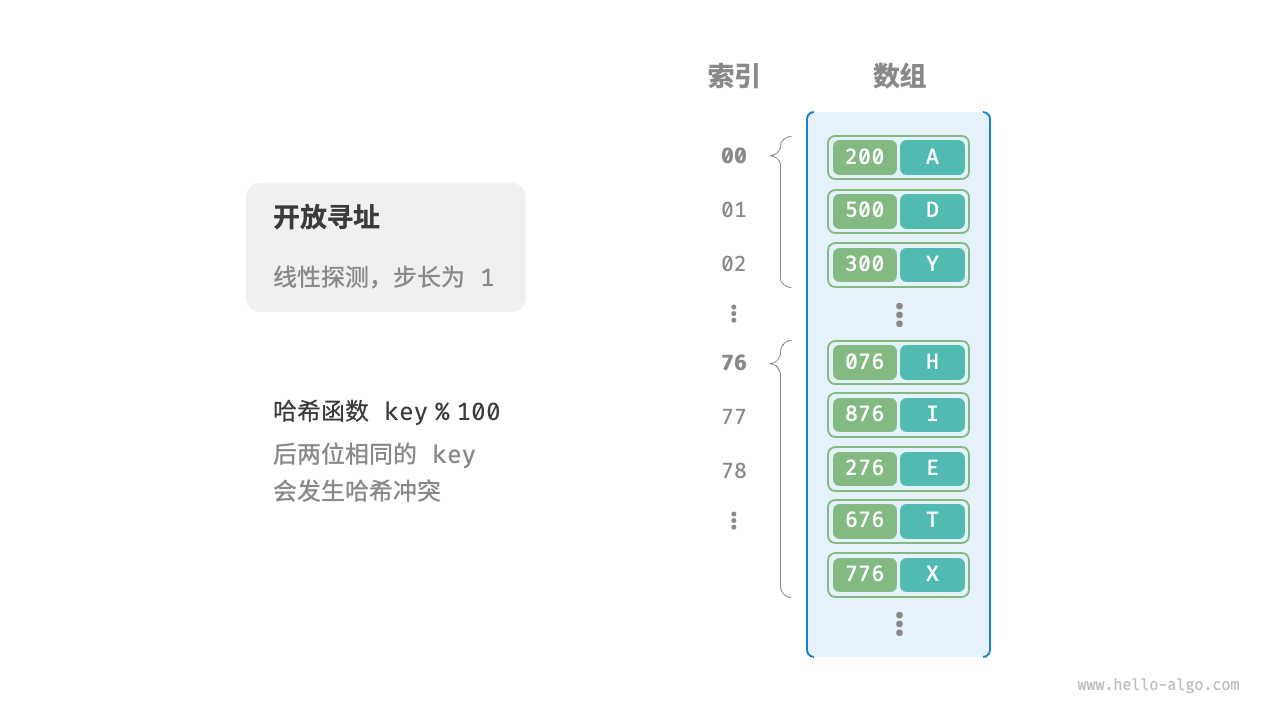
- 线性探测容易产生“聚集现象”。具体来说,数组中连续被占用的位置越长,这些连续位置发生哈希冲突的可能性越大,从而进一步促使该位置的聚堆生长,形成恶性循环,最终导致增删查改操作效率劣化。
- 我们不能在开放寻址哈希表中直接删除元素。这是因为删除元素会在数组内产生一个空桶 None ,而当查询元素时,线性探测到该空桶就会返回,因此在该空桶之下的元素都无法再被访问到,程序可能误判这些元素不存在
- 懒删除机制:它不直接从哈希表中移除元素,而是利用一个常量 TOMBSTONE 来标记这个桶
- 懒删除可能会加速哈希表的性能退化。这是因为每次删除操作都会产生一个删除标记,随着 TOMBSTONE 的增加,搜索时间也会增加,因为线性探测可能需要跳过多个 TOMBSTONE 才能找到目标元素
- 记录遇到的首个 TOMBSTONE 的索引,并将搜索到的目标元素与该 TOMBSTONE 交换位置,每次查询或添加元素时,元素会被移动至距离理想位置(探测起始点)更近的桶
- 为了更加充分地使用哈希表的空间,我们将哈希表看作一个“环形数组”,当越过数组尾部时,回到头部继续遍历
/* 开放寻址哈希表 */
class HashMapOpenAddressing {
  private:
    int size;                             // 键值对数量
    int capacity = 4;                     // 哈希表容量
    const double loadThres = 2.0 / 3.0;     // 触发扩容的负载因子阈值
    const int extendRatio = 2;            // 扩容倍数
    vector<Pair *> buckets;               // 桶数组
    Pair *TOMBSTONE = new Pair(-1, "-1"); // 删除标记

  public:
    /* 构造方法 */
    HashMapOpenAddressing() : size(0), buckets(capacity, nullptr) {
    }

    /* 析构方法 */
    ~HashMapOpenAddressing() {
        for (Pair *pair : buckets) {
            if (pair != nullptr && pair != TOMBSTONE) {
                delete pair;
            }
        }
        delete TOMBSTONE;
    }

    /* 哈希函数 */
    int hashFunc(int key) {
        return key % capacity;
    }

    /* 负载因子 */
    double loadFactor() {
        return (double)size / capacity;
    }

    /* 搜索 key 对应的桶索引 */
    int findBucket(int key) {
        int index = hashFunc(key);
        int firstTombstone = -1;
        // 线性探测,当遇到空桶时跳出
        while (buckets[index] != nullptr) {
            // 若遇到 key ,返回对应的桶索引
            if (buckets[index]->key == key) {
                // 若之前遇到了删除标记,则将键值对移动至该索引处
                if (firstTombstone != -1) {
                    buckets[firstTombstone] = buckets[index];
                    buckets[index] = TOMBSTONE;
                    return firstTombstone; // 返回移动后的桶索引
                }
                return index; // 返回桶索引
            }
            // 记录遇到的首个删除标记
            if (firstTombstone == -1 && buckets[index] == TOMBSTONE) {
                firstTombstone = index;
            }
            // 计算桶索引,越过尾部则返回头部
            index = (index + 1) % capacity;
        }
        // 若 key 不存在,则返回添加点的索引
        return firstTombstone == -1 ? index : firstTombstone;
    }

    /* 查询操作 */
    string get(int key) {
        // 搜索 key 对应的桶索引
        int index = findBucket(key);
        // 若找到键值对,则返回对应 val
        if (buckets[index] != nullptr && buckets[index] != TOMBSTONE) {
            return buckets[index]->val;
        }
        // 若键值对不存在,则返回空字符串
        return "";
    }

    /* 添加操作 */
    void put(int key, string val) {
        // 当负载因子超过阈值时,执行扩容
        if (loadFactor() > loadThres) {
            extend();
        }
        // 搜索 key 对应的桶索引
        int index = findBucket(key);
        // 若找到键值对,则覆盖 val 并返回
        if (buckets[index] != nullptr && buckets[index] != TOMBSTONE) {
            buckets[index]->val = val;
            return;
        }
        // 若键值对不存在,则添加该键值对
        buckets[index] = new Pair(key, val);
        size++;
    }

    /* 删除操作 */
    void remove(int key) {
        // 搜索 key 对应的桶索引
        int index = findBucket(key);
        // 若找到键值对,则用删除标记覆盖它
        if (buckets[index] != nullptr && buckets[index] != TOMBSTONE) {
            delete buckets[index];
            buckets[index] = TOMBSTONE;
            size--;
        }
    }

    /* 扩容哈希表 */
    void extend() {
        // 暂存原哈希表
        vector<Pair *> bucketsTmp = buckets;
        // 初始化扩容后的新哈希表
        capacity *= extendRatio;
        buckets = vector<Pair *>(capacity, nullptr);
        size = 0;
        // 将键值对从原哈希表搬运至新哈希表
        for (Pair *pair : bucketsTmp) {
            if (pair != nullptr && pair != TOMBSTONE) {
                put(pair->key, pair->val);
                delete pair;
            }
        }
    }

    /* 打印哈希表 */
    void print() {
        for (Pair *pair : buckets) {
            if (pair == nullptr) {
                cout << "nullptr" << endl;
            } else if (pair == TOMBSTONE) {
                cout << "TOMBSTONE" << endl;
            } else {
                cout << pair->key << " -> " << pair->val << endl;
            }
        }
    }
};
1.6.2.2 哈希冲突- 平方探测
当发生冲突时,平方探测不是简单地跳过一个固定的步数,而是跳过“探测次数的平方”的步数
1.6.2.3 哈希冲突- 多次哈希
若哈希函数 出现冲突,则尝试其他哈希函数以此类推,直到找到空位后插入元素。
Python 采用开放寻址。字典 dict 使用伪随机数进行探测
1.6 哈希表
总结
提示:这里对文章进行总结:

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐


 10
 0
- 0


 已为社区贡献2条内容

所有评论(0)