c++必知必会基础知识
c++基础知识
- 封装、继承、多态的概念
- 多态的实现原理及优点
- final 标识符的作用
- 虚函数的实现,存放,生成
- 智能指针的实现原理
- 匿名函数的本质,优点
- 右值引用
- 左值引用和指针的区别
- 指针
- weak_ptr
- malloc
- 指针如何确定具体要清理多少空间
- define 和 const 的区别
- 程序运行的步骤
- 锁的底层原理
- 原子操作
- class 与 struct 的区别
- 内存对齐
- 进程之间的通信方式
- 线程之间的通信方式
- socket 中的多路复用
- 类的生命周期
- 父类的构造函数和析构函数是否能为虚函数
- 多线程死锁
- 向过程和面向对象
- C++中左值和右值 ++i与i++
- vector、list 的底层实现原理和优缺点
- 静态变量初始化
- 实现多进程
- 空对象指针调用函数
- shared_ptr 线程安全
- push_back()左值和右值的区别
- move 底层实现
- 完美转发的原理
- 空类中的函数
- explicit 作用
- 成员变量初始化的顺序
- 指针占用的大小
- 野指针和内存泄漏
- malloc 和 new 的区别
- 多线程问题,线程同步
- STL
- 迭代器和指针的区别
- 线程的状态 与 线程锁
- map 和 unordered_map
- vector中的push_back()和emplace_back()
- 如何实现线程安全
- vector 扩容,resize 和 reserve 的区别
- vector 扩容
- C++中空类的大小是1个字节
- weak_ptr 的实现
- 虚函数的底层原理
- 一个函数 f(int a,int b),其中 a 和 b 的地址是相邻的。
- 移动构造和拷贝构造的区别
- lamda 表达式捕获列表捕获的方式,引用捕获注意点
- 哈希碰撞的处理方法
- unordered_map 的扩容过程
- vector 如 何 判断 应 该 扩容 ( size 和capacity)
- 构造函数不能声明为虚函数
- 类中 static 函数不能声明为虚函数
- 哪些函数不能被声明为虚函数
- 如何保证类的对象只能被开辟在堆上?
- 虚基类
- C++不能被重载的运算符
- 动态链接和静态链接的区别,原理
- C++中编译 C 语言代码
- 未初始化的全局变量和初始化的全局变量存放
- 内联函数及其优缺点
- C++11 中的 auto 的实现,模板转化成不同类型
- map 和 set 的区别和底层实现
- fcntl 的作用
- C++的面向对象主要体现的方面
- extern C 关键字
- 迭代器失效及其解决方法
- 编译器实现重载
- 函数调用约定
- 条件变量
- 类内普通成员函数、类内静态变量、类内静态成员函数、类内普通变量
- 强制类型转换类型,特点,原理
- 回调函数优缺点,本质
- Linux 中的信号
- 尾递归
- 为什么会有栈溢出,为什么栈会设置容量?
- 二叉树和平衡二叉树的区别
- 平衡二叉树的优缺点
- this 指针
- 重载、重写、隐藏
- 静态成员函数不可以是虚函数
- 构造函数不可以为虚函数
- make_shared 函数的优点,缺点
- 93.函数调用进行的操作:
封装、继承、多态的概念
封装:将具体实现过程和数据封装成一个类,只能通过接口进行
访问,降低耦合性,使类成为一个具有内部数据的自我隐藏能力、功
能独立的软件模块。意义:保护或防止代码在无意之中被破坏,保护
类中的成员,不让类中以外的程序直接访问或者修改,只能通过提供
的公共接口访问。
继承:子类继承父类的特征和行为,复用了基类的全体数据和成
员函数,具有从基类复制而来的数据成员和成员函数(基类私有成员
可被继承,但是无法被访问),其中构造函数、析构函数、友元函数、
静态数据成员、静态成员函数都不能被继承。基类中成员的访问方式
只能决定派生类能否访问它们。增强了代码耦合性,当父类中的成员
变量或者类本身被 final 关键字修饰时,修饰的类不能被继承,修饰
的成员函数不能重写或修改。意义:基类的程序代码可以被派生类复
用,提高了软件复用的效率,缩短了软件开发的周期。
多态:不同继承类的对象对同一消息做出不同的响应,基类的指
针指向或绑定到派生类的对象,使得基类指针呈现不同的表现形式。
意义:对已存在的代码具有可替代性,对代码具有可扩充性,新增子
类不会影响已存在类的各种性质,在程序中体现了灵活多样的操作,
提高了使用效率,简化了对应用代码的编写和修改过程。
多态的实现原理及优点
实现方式:多态分为动态多态(动态多态是利用虚函数实现运行
时的多态,即在系统编译的时候并不知道程序将要调用哪一个函数,
只有在运行到这里的时候才能确定接下来会跳转到哪一个函数。)和
静态多态(又称编译期多态,即在系统编译期间就可以确定程序将要
执行哪个函数),其中动态多态是通过虚函数实现的,虚函数是类的
成员函数,存在存储虚函数指针的表(叫做虚函数表),虚函数表是一个
存储类成员虚函数的指针,每个指针都指向调用它的地方,当子类调
用虚函数时,就会去虚表里面找自己对应的函数指针,从而实现“谁
调用、实现谁”从而实现多态。而静态多态则是通过函数重载(函数
名相同,参数不同,两个函数在同一作用域),运算符重载,和重定
义(又叫隐藏,指的是在继承关系中,子类实现了一个和父类名字一
样的函数,只关注函数名,和参数与返回值无关这样的话子类的
函数就把父类的同名函数隐藏了。隐藏只与函数名有关,与参数没有
关系.)来实现的。
优点:加强代码的可扩展性,可替换性,增强程序的灵活性,提
高使用效率,简化对应用代码的编写和修改过程。
final 标识符的作用
放在类的后面表示该类无法被继承,也就是阻止了从类的继承;
放在虚函数后面该虚函数无法被重写,表示阻止虚函数的重载。
虚函数的实现,存放,生成
在 C++中,虚函数的实现原理基于两个关键概念:虚函数表和虚函数指针。
虚函数表:每个包含虚函数的类都会生成一个虚函数表,其中存储着该类中所有虚函数的地址。虚函数表是一个由指针构成的数组,每个指针指向一个虚函数的实现代码。
虚函数指针:在对象的内存布局中,编译器会添加一个额外的指针,称为虚函数指针或虚表指针。这个指针指向该对象对应的虚函数表,从而让程序能够动态的调用虚函数。
当一个基类指针或引用调用虚函数时,编译器会使用虚表指针来查找该对象对应的虚函数表,并根据函数在虚函数表中的位置来调用正确的虚函数。
在编译阶段生成,虚函数和普通函数一样存放在代码段,只是它的指针又存放在了虚表之中。
智能指针的实现原理
智能指针本质是一个封装了一个原始 C++指针的类模板,为了确保动态内存的安全性而产生的。实现原理是通过一个对象 存储需要被自动释放的资源,然后依靠对象的析构函数来释放资源。
匿名函数的本质,优点
匿名函数本质上是一个对象,在其定义的过程中会创建出一个栈对象,内部通过重载()符号实现函数调用的外表。
优点:使用匿名函数,可以免去函数的声明和定义。这样匿名函数仅在调用函数的时候才会创建函数对象,而调用结束后立即释放,所以匿名函数比非匿名函数更节省空间。
右值引用
右值引用是为一个临时变量取别名,它只能绑定到一个临时变量或表达式(将亡值)上。实际开发中我们可能需要对右值进行修改(实现移动语义时就需要)而右值引用可以对右值进行修改。
1.为了支持移动语义,右值引用可以绑定到临时对象、表达式等右值上,这些右值在生命周期结束后就会被销毁,因此可以在右值引用中窃取其资源,从而避免昂贵的复制操作,实现高效的移动语义。
std::string a { "hello, world" };
std::string b = std::move(a);//a转换为了右值,并通过移动赋值运算符进行了移动语义的赋值操作
//执行std::move并没有发生任何移动。std::move的功能仅仅是强制类型转换的缩写形式(static_cast<std::string &&>(a);)

//移动构造
CDate(CDate &&date) noexcept;	// 声明
CDate::CDate(CDate&& date) noexcept // 实现 执行完此构造函数,date临时对象会走自己的析构销毁
{
	m_year = date.m_year;
	m_mon = date.m_mon;
	m_day = date.m_day;
	str = date.str;
	date.str = NULL;//原对象(date)的析构函数执行时,delete NULL是安全的(C++ 标准规定delete NULL无任何操作)
	cout << "Calling Move Constructor" << ", this=" << this <<endl;
}

// 拷贝构造函数定义
CDate::CDate(const CDate& date)
{
	m_year = date.m_year;
	m_mon = date.m_mon;
	m_day = date.m_day;
	str = new char[MAX_NEW_MEM];
	memcpy(str, date.str, MAX_NEW_MEM);
	cout << "Calling Copy Constructor" << ", this=" << this << ", Copy Data" <<endl;
}
//https://blog.csdn.net/wkd_007/article/details/139633287
2.完美转发:右值引用可以绑定到任何类型的右值上,可以将其作为参数传递给函数,并在函数内部将其“转发”到其他函数中,从而实现完美转发。
3.拓展可变参数模板,实现更加灵活的模板编程。
左值引用和指针的区别
是否初始化:指针可以不用初始化,引用必须初始化
性质不同:指针是一个变量,引用是对被引用的对象取一个别名
占用内存单元不同:指针有自己的空间地址,引用和被引用对象占同一个空间。
指针
指针全名为指针变量,计算机在存储数据是有序存放的,为了能够使用存放的地址,就需要一个地址来区别每个数据的位置,指针变量就是用来存放这些地址的变量。
weak_ptr
计数,控制块中有强弱引用计数,如果是使用 make_shared 初始化的函数,则它所在的控制块空间是在所引用的 shared_ptr 中同一块的空间,若是 new, 则控制器所分配的内存与 shared_ptr 本身所在的
空间不在同一块内存。
std::weak_ptr 是 C++ 标 准 库 中 用 于 解决 std::shared_ptr 循环引用问题的智能指针。它本身并不参与对象的引用计数,也就是说,std::weak_ptr 的创建、销毁或者赋值操作不会改变所指向对象的引用计数。
std::shared_ptr 对对象的 生 命 周 期 负 责 , 其 引 用 计 数 记 录 了 有 多 少个std::shared_ptr 指向同一个对象,当引用计数降为 0 时,对象 会 被 自 动 销 毁 。 而 std::weak_ptr 只 是对 std::shared_ptr 所管理对象的一种弱引用,它不会阻止对象被销毁。
std::weak_ptr 可 以 通 过 std::shared_ptr 或 者 另 一个std::weak_ptr来构造,它会指向同一个控制块,从而共享弱引用计数信息。当所有的 std::shared_ptr 都被销毁,对象被释放后,控制块仍然会存在,直到所有的 std::weak_ptr 也被销毁,此时弱引用计数降为 0,控制块的内存才会被释放。
1.引用计数影响
shared_ptr:持有对象时会增加引用计数,释放时减少计数,当计数归零时自动释放对象。
weak_ptr:不影响引用计数,仅作为 shared_ptr 管理对象的 “观察者”。
2.对象所有权
shared_ptr:拥有对象的所有权,多个 shared_ptr 可共享同一对象的所有权。
weak_ptr:不拥有对象所有权,仅能观察对象是否存在,无法直接访问对象。
3.访问对象方式
shared_ptr:可直接通过 * 或 -> 运算符访问对象。
weak_ptr:必须先通过 lock() 方法转换为 shared_ptr 才能访问对象(若对象已释放,lock() 返回空 shared_ptr)。
4.循环引用问题
shared_ptr:可能导致循环引用(如两个对象互相持有对方的 shared_ptr),造成内存泄漏。
weak_ptr:可打破循环引用,通过持有对方的 weak_ptr 避免所有权循环。
参考:
删除器与控制块
template<typename _Ty>
class Mydeletor
{
public:
	Mydeletor() = default;
	void operator()(_Ty* p)const
	{
		if (p != NULL)
		{
			delete[]p;
		}
		p = NULL;
	}
};

template<typename _Ty>
class RefCnt
{

public:
	RefCnt(_Ty* p) :ptr(p), Uses(1), Weaks(0)
    {
        cout <<"RefCnt construct"<<endl;
    }
	~RefCnt() {}
	void IncUses()
	{
		Uses += 1;
	}
	void IncWeaks()
	{
		Weaks += 1;
	}

protected:

	_Ty* ptr;
	std::atomic_int Uses;
	std::atomic_int Weaks;
	friend class M_shared_ptr<_Ty>;
	friend class M_weak_ptr<_Ty>;
};
share_ptr
template<typename _Ty,typename _De>
class M_shared_ptr
{
private:
	_Ty* Ptr;
	RefCnt<_Ty>* Ref;
	_De mdeletor;
public:
	M_shared_ptr(_Ty* p = nullptr) :Ptr(nullptr),Ref(nullptr)
	{
		if (p != nullptr)
		{
			Ptr = p;
			Ref = new RefCnt<_Ty>(p);
		}
	}
	M_shared_ptr(const M_shared_ptr& other):Ptr(other.Ptr),Ref(other.Ref)//拷贝构造
	{
		if (Ptr != NULL)
		{
			Ref->IncUses();
		}
	}

	M_shared_ptr(const M_weak_ptr<_Ty>& other):Ptr(other.GetRef()->ptr),Ref(other.GetRef())//用weak_ptr拷贝构造
	{
		if (Ptr != NULL)
		{
			Ref->IncUses();
		}
	}


	M_shared_ptr(M_shared_ptr&& other) :Ptr(other.Ptr), Ref(other.Ref)//移动构造
	{
		other.Ptr = NULL;
		other.Ref = NULL;
	}

	M_shared_ptr& operator=(const M_shared_ptr& other)//赋值
	{
		if (this == &other || Ptr == other.Ptr)  return *this;//自赋值,直接返回本身

		if (Ptr != NULL && --Ref->Uses == 0)//被赋值的智能指针对象拥有资源,
		{                                   //且该对象仅被该智能指针拥有
			mdeletor(Ptr);//释放该对象
			if (--Ref->Weaks == 0)//当弱引用计数为零时
			{
				delete Ref;//析构引用计数对象
				Ref = NULL;
			}
		}

		Ptr = other.Ptr;
		Ref = other.Ref;
		if (Ptr != NULL)
		{
			Ref->IncUses();
		}
		return *this;
	}

	M_shared_ptr& operator=(M_shared_ptr&& other)//移动赋值
	{
		if (this == &other)  return *this;
		if (Ptr == other.Ptr && Ptr != NULL)//当两个智能指针使用同一个对象时,且该对象不为空
		{
			other.Ptr = NULL;//去掉other的使用权
			other.Ref = NULL;
			Ref->Uses -= 1;//强引用计数-1

			return *this;
		}

		if (Ptr != NULL && --Ref->Uses == 0)
		{
			mdeletor(Ptr);
			if (--Ref->Weaks == 0)
			{
				delete Ref;
				Ref = NULL;
			}
		}
		Ptr = other.Ptr;
		Ref = other.Ref;

		other.Ptr = NULL;
		other.Ref = NULL;

		return *this;
	}

	~M_shared_ptr()
	{
		if (Ptr != NULL && --Ref->Uses == 0)
		{
			mdeletor(Ptr);
			if (--Ref->Weaks == 0)
			{
				delete Ref;
			}
		}
		Ref = NULL;
	}

	_Ty* get()const
	{
		return Ptr;
	}

	_Ty& operator*()
	{
		return *get();
	}

	_Ty* operator->()
	{
		return get();
	}

	size_t use_count()const
	{
		if (Ref == NULL)  return 0;
		return Ref->Uses;
	}

	void swap(M_shared_ptr& other)
	{
		std::swap(Ptr, other.Ptr);
		std::swap(Ref, other.Ref);
	}

	operator bool()const
	{
		return Ptr != NULL;
	}
	 friend class M_weak_ptr<_Ty>;
};
weak_ptr
template<typename _Ty>
class M_weak_ptr
{
private:
	RefCnt<_Ty>* wRef;
public:

	size_t use_count()const
	{
		if (wRef == NULL)  return 0;
		return wRef->Uses;
	}

	size_t weak_count()const
	{
		if (wRef == NULL)  return 0;
		return wRef->Weaks;
	}

	RefCnt<_Ty>* GetRef() const
	{
		return wRef;
	}

	M_weak_ptr() :wRef(NULL) {}
	M_weak_ptr(const M_shared_ptr<_Ty>& other) :wRef(other.Ref)//共享指针构造
	{
		if (wRef!=NULL)
		{
			wRef->IncWeaks();
		}
	}

	M_weak_ptr(const M_weak_ptr& other) :wRef(other.wRef)//拷贝构造
	{
		if (wRef != NULL)
		{
			wRef->IncWeaks();
		}
	}

	M_weak_ptr(M_weak_ptr&& other) :wRef(other.wRef)//移动构造
	{
		other.wRef = NULL;
	}

	M_weak_ptr& operator=(const M_weak_ptr& other)
	{
		if (this == &other||wRef==other.wRef)  return *this;//自赋值或者是两个指针指向同一个对象

		if (this != NULL && --wRef->Weaks == 0)//是否自己独占对象
		{
			delete wRef;
		}

		wRef = other.wRef;
		if (wRef != NULL)
		{
			wRef->IncUses();
		}

		return *this;
	}
	M_weak_ptr& operator=(M_weak_ptr&& other)
	{
		//1 判断是否自赋值
		if (this == &other)  return *this;

		//2 判断是否是指向同一个对象的两个指针相互赋值
		if (wRef == other.wRef && wRef != NULL)//如果是
		{
			other.wRef = NULL;
			wRef->Weaks -= 1;
			return *this;
		}

		//3 两个指向不同对象的指针赋值
		if (this != NULL && --wRef->Weaks == 0)//是否自己独占对象
		{
			delete wRef;//如果独有
		}

		wRef = other.wRef;
		other.wRef = NULL;

		return *this;
	}
	M_weak_ptr& operator=(const M_shared_ptr<_Ty>& other)//共享智能指针给弱指针赋值
	{
		if (wRef == other.Ref)  return *this;

		if (wRef != NULL && --wRef->Uses == 0)
		{
			delete wRef;
		}
		wRef = other.Ref;

		if (wRef != NULL)
		{
			wRef->IncWeaks();
		}

		return *this;
	}
	M_weak_ptr& operator=( M_shared_ptr<_Ty>&& other) = delete;
	~M_weak_ptr()
	{
		if (wRef != NULL && --wRef->Weaks == 0)
		{
			delete wRef;

		}
		wRef = NULL;
	}
	bool expired()const//判断被引用的对象是否删除,若删除则返回真
	{
		return wRef->Uses == 0;
	}
	M_shared_ptr<_Ty> lock()const
	{
		M_shared_ptr<_Ty> tmp;
		tmp.Ptr = wRef->ptr;
		tmp.Ref = wRef;
		tmp.Ref->IncUses();
		return tmp;

	}
};
malloc
内存分配的方式与缺点
malloc 并不是系统调用,而是 C 库中的函数,用于动态内存分配,在使用 malloc 分配内存的时候会有两种方式向操作系统申请堆内存:
方式 1:当用户分配的内存小于 128KB 时通过 brk()系统调用从堆分配内存,实现方式:将堆顶指针向高地址移动,获取内存空间,如果使用 free 释放空间,并不会将内存归还给操作系统,而是会缓存在 malloc 的内存池中,待下次使用
方式 2:当用户分配的内存大于 128KB 时通过 mmap()系统调用在文件映射区域分配内存,实现方式为:使用私有匿名映射的方式,在文件映射区分配一块内存,也就是从文件映射区拿了一块内存,free释放内存的时候,会把内存归还给操作系统,内存得到真正释放
缺点:容易造成内存泄漏和过多的内存碎片,影响系统正常运行,还得注意判断内存是否分配成功,而且内存释放后使用 free 函数之后指针变量 p 本身保存的地址并没有改变,需要将 p 的赋值为NULL 拴住野指针。
不全部使用mmap来分配内存的原因
因为向操作系统申请内存的时候,是要通过系统调用的,执行系统调用要进入内核态,然后再回到用户态,状态的切换会耗费不少时间,所以申请内存的操作应该避免频繁的系统调用,如果都使用mmap来分配内存,等于每次都要执行系统调用。另外,因为 mmap 分配的内存每次释放的时候都会归还给操作系统,于是每次 mmap 分配的虚拟地址都是缺页状态,然后在第一次访问该虚拟地址的时候就会触发缺页中断。
mmap需要在虚拟地址空间中创建新的映射,涉及页表修改等复杂操作,开销较大,更适合大块内存分配(通常阈值在 128KB 左右)。
不全部都用 brk的原因
如果全部使用 brk 申请内存那么随着程序频繁的调用 malloc 和free,尤其是小块内存,堆内将产生越来越多的不可用的内存碎片。
brk通过调整数据段末尾指针实现内存分配,操作简单高效,适合小块内存分配。连续的brk调用可以形成连续的内存块,减少内存碎片。
指针如何确定具体要清理多少空间
我们在申请内存的时候,会多分配 16 字节的内存,里面保存了内存块的详细信息,free 会对传入的内存地址向左偏移 16 字节,然后分析出当前内存块的大小,就知道要释放多大的内存空间了。
define 和 const 的区别
编译阶段:define 是在编译预处理阶段进行简单的文本替换,const 是在编译阶段确定其值
安全性:define 定义的宏常量没有数据类型,只是进行简单的替换,不会进行类型安全检查;const 定义的常量是有类型的,是要进行类型判断的
内存占用:define 定义的宏常量,在程序中使用多少次就会进行多少次替换,内存中有多个备份,占用的是代码段的内存;const定义常量占用静态存储区域的空间,程序运行过程中只有一份
调试:define 定义的宏常量不能调试,因为在预编译阶段就已经进行替换了;const 定义的常量是可以进行调试的。
程序运行的步骤
预编译:将头文件编译,进行宏替换,输出.i 文件
编译:将其转化为汇编语言文件,主要做词法分析,语义分析以及检查错误,检查无误后将代码翻译成汇编语言,生成.s 文件
汇编:汇编器将汇编语言文件翻译成机器语言,生成.o 文件
链接:将目标文件和库链接到一起,生成可执行文件.exe
锁的底层原理
锁的底层是通过 CAS,atomic 机制实现。
CAS 机制:全称为 Compare And Swap(比较相同再交换)可以将比较和交换操作转换为原子操作,CAS 操作依赖于三个值:内存中的值 V,旧的预估值 X,要修改的新值 B,如果旧的预估值 X 等于内存中的值 V,就将新的值 B 保存在内存之中。(就是每一个线程从主内存复制一个变量副本后,进行操作,然后对其进行修改,修改完后,再刷新回主内存前。再取一次主内存的值,看拿到的主内存的新值与当初保存的快照值,是否一样,如果不一样,说明有其他线程修改,本次修改放弃,重试。)
原子操作
原子操作是指不会被线程调度机制打断的操作,这种操作一旦开始,就一直运行到结束,中间不会有任何切换到另一个线程。
原理是:在 X86 的平台下,CPU 提供了在指令执行期间对总线加锁的手段,CPU 中有一根引线#HLOCK pin 连接到北桥,如果汇编语言的程序在程序中的一条指令前面加上了前缀“LOCK”,经过汇编之后的机器码就使 CPU 在执行这条指令的时候把#HLOCKpin 的电平拉低持续到这条指令结束的时候放开,从而把总线锁住,这样别的 CPU 就暂时不能够通过总线访问内存了,保证了多处理器环境中的原子性。
class 与 struct 的区别
默认继承权限不同:class 默认继承的是 private 继承,struct默认是 public 继承。
Class 还可用于定义模板参数,但是关键字 struct 不能同于定义模板参数,C++保留 struct 关键字,原因是保证与 C 语言的向下兼容性,为了保证百分百的与 C 语言中的 struct 向下兼容,,C++
把最基本的对象单元规定为 class 而不是 struct,就是为了避免各种兼容性的限制。
内存对齐
内存对齐是处理器为了提高处理性能而对存取数据的起始地址所提出的一种要求。
有些 CPU 可以访问任意地址上的任意数据,而有些 CPU 只能在特定的地址访问数据,因此不同硬件平台具有差异性,这样的代码就不具有移植性,如果在编译时将进行对齐,这就具有平台的移植性。
CPU每次寻址有时需要消耗时间的,并且 CPU 访问内存的时候并不是逐个字节访问,而是以字长为单位访问,所以数据结构应该尽可能地在自然边界上对齐,如果访问未对齐内存,处理器需要做多次内存访问,而对齐的内存访问可以减少访问次数,提升性能。
优:提高程序的运行效率,增强程序的可移植性。
进程之间的通信方式
管道:管道分为匿名管道和命名管道,管道本质上是一个内核中的一个缓存,当进程创建管道后会返回两个文件描述符,一个写入端,一个输出端。
缺点:半双工通信,一个管道只能一个进程写,一个进程读。不适合进程间频繁的交换数据
消息队列:可以边发边收,但是每个消息体都有最大长度限制,队列所包含的消息体的总数量也有上限并且在通信过程中存在用户态和内核态之间的数据拷贝问题
共享内存:解决了消息队列存在的内核态和用户态之间的数据拷贝问题。
信号量:本质上是一个计数器,当使用共享内存的通信方式时,如果有多个进程同时往共享内存中写入数据,有可能先写的进程的内容被其他进程覆盖了,信号量就用于实现进程间的互斥和同步
PV 操作不限于信号量±1,而且可以任意加减正整数
线程之间的通信方式
信号量(pv操作,可同时多个访问资源)
条件变量(生产-消费模型中多用到,会通知阻塞线程)
互斥量
socket 中的多路复用
select、poll、epoll 都是 IO 多路复用的一种机制,可以监视多个文件描述符,一旦某个文件描述符进入读或写就绪状态,就能够通知系统进行相应的读写操作。
Select 优点:可移植性好,因为在某些 Unix 系统中并不支持 poll和 epoll 对于超时时间提供了更好的精度:微妙,而 poll 和 epoll都是毫秒级
Select 缺点:支持监听的文件描述符 fd 的数量有限制,最大数量默认是 1024 个。Select 需要维护一个用来存放文件描述符的数据结构,每次调用select 都需要把 fd 集合从用户区拷贝到内核区,而 select 系统调用后有需要把 fd 集合从内核区拷贝到用户区,这个系统开销在 fd 数量很多的时候会很大。
Poll 优点(相对于 select 而言):没有最大文件描述符数量的限制,poll 基于链表存储主要解决了这个最大文件描述符数量的限制(当然,他还是有限制的,上限为操作系统能支持的能开启的最大文件描述符数量),优化了编程接口,减少了函数调用参数,并且,每次调用 select 函数时,都必须重置该函数的三个 fd_set 类型的参数值,而 poll 不需要重置。
Poll 缺点:poll 和 select 一样同样都需要维护一个用来存放文件描述符的数据结构,当注册的文件描述符无限多时,会使得用户态和内核区之间传递该数据结构的复制开销很大。每次 poll 系统调用时,需要把文件描述符 fd 从用户态拷贝到内核区,然后 poll 系统调用返回前,又需要把文件描述符 fd 集合从内核区拷贝到用户区,这个内存拷贝的系统开销在 fd 数量很多的时候会很大。
Epoll 优点:和 poll 一样没有最大文件描述符数量的限制,epoll虽然也需要维护用来存放文件描述符的数据结构(epoll_event),但是它只需要将该数据结构拷贝一次,不需要重复拷贝,并且它只在调用 epoll_ctl 系统调用时拷贝一次要监听的文件描述符数据结构到内核区,在调用 epoll_wait 的时候不需要再把所有的要监听的文件描述符重复拷贝进内核区,这就解决了 select 和 poll 种内存复制开销的问题。
Epoll 缺点:目前只有 Linux 操作系统支持 epoll,不支持跨平台使用,而 Unix 操作系统上是使用 kqueue
Epoll 水平触发(LT):对于读操作,只要缓冲区内容不为空,LT 模式返回读就绪。
Epoll 边缘触发(ET):对于读操作,当缓冲区由不可读变为可读的时候,有新数据到达时,进程修改了 EPOLL_CTL_MOD 修改 EPOLLIN事件时在 ET 模式下,缓冲区从不可读变成可读,会唤醒应用进程,缓冲区数据变少的情况,则不会再唤醒应用进程。当被监控的文件描述符上有可读写事件发生时,epoll_wait()会通知处理程序去读写。如果这次没有把数据全部读写完(如读写缓冲区太小),那么下次调用epoll_wait()时,它不会通知你,也就是它只会通知你一次,直到该文件描述符上出现第二次可读写事件才会通知你。通常配合将文件描述符设置为非阻塞状态一起使用,这种模式比水平触发效率高,系统不会充斥大量你不关心的就绪文件描述符。
类的生命周期
类从被加载到内存中开始,到卸载出内存为止,它的整个生命周期包括:加载、验证、准备、解析、初始化、使用和卸载七个阶段。
其中验证,准备,解析三个部分统称为连接
全局对象在 main 开始前被创建,main 退出后被销毁。
静态对象在第一次进入作用域时被创建,在 main 退出后被销毁。
局部对象在进入作用域时被创建,在退出作用域时被销毁。
New 创建的对象直到内存被释放的时候都存在。
父类的构造函数和析构函数是否能为虚函数
构造函数不能为虚函数,虚函数的调用是通过虚函数表来查找的,而虚函数表由类的实例化对象的 vptr 指针指向,该指针存放在对象的内部空间之中,需要调用构造函数完成初始化,如果构造函数为虚函数,那么调用构造函数就需要去寻找 vptr,但此时 vptr 还没有完成初始化,导致无法构造对象。
析构函数可以且经常为虚函数:当使用基类指针或引用指向派生类对象,并且通过该指针或引用删除对象时,虚析构函数会保证先调用派生类的析构函数,再调用基类的析构函数,以此来确保资源的正确释放。
多线程死锁
死锁产生的条件,如何解决死锁:
因为在多线程中易发生多线程对资源进行竞争,如果一个进程集合里面的每一个线程都在等待这个集合中的其他一个线程才能继续往下执行,若无外力他们将无法推进,这种情况就是死锁。
产生死锁的四个条件:互斥条件、请求和保持条件、不可剥夺条件、环路等待条件。(比如互锁)
解决死锁的方法就是破坏上述任意一种条件。
向过程和面向对象
面向对象:就是将问题分解为各个对象,建立对象的目的不是为了完成一个步骤,而是为了描述某个事物在整个解决问题的步骤中的行为,相比面向过程,代码更易维护和复用。但是代码效率相对较低。
面向过程:就是将问题分析出解决问题的步骤,然后将这些步骤一步一步的实现,使用的时候一个一个调用就好。代码效率更高但是代码复用率低,不易维护。
C++中左值和右值 ++i与i++
左值是指可以出现在赋值运算符左边的表达式,它代表一个具有确定存储地址的对象,能够被取地址。
右值是指只能出现在赋值运算符右边的表达式,它不代表一个具有确定存储地址的对象,通常是临时的、即将被销毁的值。右值可以分为纯右值(prvalue)和将亡值(xvalue)。
因为++i 返回的是一个左值没有发生拷贝,所以效率更高。
++i 是左值效率高,i++是右值。因为++i 返回 i 本身,而 i++返回 i 的值。
可以理解为下面这种
++i
{
	i = i+1;
	return i;
}

i++
{
	int tmp=i;
	i+=1;
	return tmp;
}
++i 返回的是 i 本身的引用。
vector、list 的底层实现原理和优缺点
Vector
优点:可使用下标随机访问,尾插尾删效率高。
缺点:前面部分的插入删除效率低,扩容有消耗,可能存在一定的空间浪费。
底层是由一块连续的内存空间组成,动态数组,由三个指针实现的分别是头指针(表示目前使用空间的头),尾指针(表示目前使用空间的尾)和可用空间尾指针实现
List
优点:按需申请内存,不需要扩容,不会造成内存空间浪费。在任意位置的插入删除效率高。
缺点:不支持下标随机访问
底层是由双向链表实现的
静态变量初始化
静态变量,全局变量,常量都在编译阶段完成初始化和内存分配。
其他变量都是在编译阶段进行初始化,运行阶段内存分配.。
静态变量和全局变量存储在数据区;
BSS 段
存放内容:未初始化的全局变量和静态变量(包括全局静态变量和局部静态变量)。
特点:在程序开始执行前,BSS 段的所有数据会被操作系统自动初始化为零(0 或 NULL)。这保证了未初始化的全局/静态变量都有一个确定的初始值。
数据段
存放内容:已初始化的全局变量和静态变量(包括全局静态变量和局部静态变量)。
特点:这些变量在编译时就被赋予了明确的初始值
堆区/栈区/全局区(数据区,已初始化的全局变量和静态变量,BSS
段,未初始化的全局变量和静态变量)
实现多进程
在 Linux 中 C++使用 fork 函数来创建进程
#include <stdio.h>
#include <unistd.h>
#include <sys/wait.h>

int main() {
    pid_t pid = fork();  // 创建子进程

    if (pid == -1) {
        perror("fork failed");
        return 1;
    }

    if (pid == 0) {
        // 子进程逻辑
        printf("子进程:PID=%d,父进程PID=%d\n", getpid(), getppid());
    } else {
        // 父进程逻辑
        printf("父进程:PID=%d,子进程PID=%d\n", getpid(), pid);
        wait(NULL);  // 等待子进程结束,避免僵尸进程
    }

    return 0;
}
/*
它通过复制当前进程(父进程)来生成一个新进程(子进程),两个进程几乎完全相同,但拥有独立的地址空间.
父子进程执行顺序不确定,取决于操作系统调度
若父进程未调用 wait() 或 waitpid() 等待子进程结束,子进程会成为僵尸进程(资源未完全释放)
若父进程先退出,子进程会被 init 进程(PID=1)或 systemd 收养
*/

/*
进程退出的资源释放流程当子进程执行结束(如调用 exit() 或被信号终止),操作系统会:
释放子进程的大部分资源:包括内存、打开的文件描述符、CPU 上下文等。
保留一小部分关键信息:如进程 ID(PID)、退出状态(退出码或终止信号)、资源使用统计(如 CPU 时间、内存峰值)等。
这些保留的信息是给父进程的 “通知”,用于父进程通过 wait() 或 waitpid() 查询子进程的结束原因和状态。
父进程的 “回收责任”操作系统设计中,父进程被赋予回收子进程的责任:
父进程必须通过 wait() 或 waitpid() 主动读取子进程的退出状态。
一旦父进程读取了这些信息,操作系统才会彻底释放子进程的剩余资源(包括 PID)。
若父进程未执行这个操作,子进程的退出状态信息会一直保留在系统的 “进程表” 中,导致子进程成为僵尸进程。
僵尸进程的本质僵尸进程并非 “正在运行的进程”,它已经终止,没有代码执行,也不占用内存等活跃资源。但它在进程表中仍有一条记录(包含 PID 和退出状态),这意味着:
PID 被占用(系统 PID 是有限资源,大量僵尸进程会耗尽 PID)。
进程表项本身占用少量内存(通常几字节到几十字节,但累积会有影响)。
*/
而 windows 中 C++使用 createprocess 来创建进程
与 Unix/Linux 中的 fork() 不同,它不仅创建进程,还可以直接加载并执行新的程序(类似 fork() + exec() 的组合功能)
BOOL CreateProcessA(
  LPCSTR                lpApplicationName,//可执行文件路径(如 C:\\app.exe),若为 NULL,则从 lpCommandLine 提取
  LPSTR                 lpCommandLine,//命令行参数(字符串形式,如 "app.exe -arg1 value")。
  LPSECURITY_ATTRIBUTES lpProcessAttributes,//进程安全属性(如是否允许子进程继承句柄),通常为 NULL 使用默认值。
  LPSECURITY_ATTRIBUTES lpThreadAttributes,//主线程安全属性,同上,通常为 NULL。
  BOOL                  bInheritHandles,//是否允许子进程继承父进程的句柄(如文件句柄),TRUE 表示继承。
  DWORD                 dwCreationFlags,//进程创建标志(如 CREATE_NEW_CONSOLE 新建控制台,CREATE_NO_WINDOW 无窗口)
  LPVOID                lpEnvironment,//子进程的环境变量,NULL 表示继承父进程环境变量。
  LPCSTR                lpCurrentDirectory,//子进程的当前工作目录,NULL 表示使用父进程当前目录。
  LPSTARTUPINFOA        lpStartupInfo,//启动信息(如窗口位置、标准输入输出重定向等),需初始化 cb 成员
  LPPROCESS_INFORMATION lpProcessInformation//输出参数,返回新进程的 ID、句柄,主线程的 ID、句柄。
);


#include <windows.h>
#include <stdio.h>

int main() {
    STARTUPINFO si;
    PROCESS_INFORMATION pi;

    // 初始化 STARTUPINFO 结构体(必须设置 cb 大小)
    ZeroMemory(&si, sizeof(si));
    si.cb = sizeof(si);
    ZeroMemory(&pi, sizeof(pi));

    // 创建进程:执行 notepad.exe
    BOOL success = CreateProcessA(
        "C:\\Windows\\notepad.exe",  // 可执行文件路径
        NULL,                        // 命令行参数(此处无额外参数)
        NULL,                        // 进程安全属性
        NULL,                        // 线程安全属性
        FALSE,                       // 不继承句柄
        0,                           // 无特殊创建标志
        NULL,                        // 继承父进程环境变量
        NULL,                        // 使用父进程当前目录
        &si,                         // 启动信息
        &pi                          // 输出进程信息
    );

    if (!success) {
        printf("创建进程失败!错误码:%d\n", GetLastError());
        return 1;
    }

    // 输出新进程信息
    printf("新进程 PID: %d\n", pi.dwProcessId);
    printf("新进程句柄: %p\n", pi.hProcess);
    printf("主线程 TID: %d\n", pi.dwThreadId);

    // 关闭句柄(不再需要时释放资源)
    CloseHandle(pi.hProcess);
    CloseHandle(pi.hThread);

    return 0;
}
空对象指针调用函数
在类的初始化的时候,编译器会将它的函数分配到类的外部,这也包括静态成员函数,这样做主要是为了节省内存,如果我们在调用类中的的成员函数时没有使用类中的任何成员变量,它不会使用到
this 指针所以可以正常调用这个函数。
shared_ptr 线程安全
智能指针中的引用计数是线程安全的,但是智能指针所指向的对象的线程不安全,智能指针没有做任何保障,线程不安全。
也就是说它所管理的资源可以线程安全的释放,只保证线程安全的管理资源的生命期,不保证其资源可以线程安全地被访问。
但它指向的对象本身的操作并不是线程安全的。多个线程同时访问和修改 std::shared_ptr 指向的对象可能会导致数据竞争和未定义行为。
push_back()左值和右值的区别
如果 push_back()的参数是左值,则使用它拷贝构造新对象,
如果是右值,则使用它移动构造新对象.。
move 底层实现
Move 的功能是将一个左值引用强制转化为右值引用,继而可以通过右值引用使用该值,以用于移动语义,从实现原理上讲基本等同一个强制类型转换。
优点:可以将左值变成右值而避免拷贝构造,将对象的状态所有权从一个对象转移到另一个对象,只是转移,没有内存搬迁或者内存拷贝。
完美转发的原理
完美转发是指函数模板可以将自己的参数完美的转发给内部调用的其他函数,完美是指不仅能够准确的转发参数的值,还能保证被转发参数的左、右值属性不变,使用引用折叠的规则,将传递进来的左值以左值传递出来,将传递进来的右值以右值的方式传出。
// 完美转发函数模板
template<typename T>
void forwarder(T&& arg) {
    process(std::forward<T>(arg));  // 完美转发
}
空类中的函数
默认构造函数
默认拷贝构造函数
默认析构函数
默认赋值运算符、取值运算符(应该是 地址运算符(operator&))、const 取值运算应该是 const 限定的地址运算符 const (operator&)符。
explicit 作用
只能用于修饰只有一个参数的类构造函数(有一个例外就是,当除了第一个参数以外的其他参数都有默认值的时候此关键字依然有效),它的作用是表明该构造函数是显示的,而非隐式的;作用是防止类构造函数的隐式自动转换。
class ExplicitString {
public:
    // 显式构造函数 - 禁止隐式转换
    explicit ExplicitString(const char* str) {
        std::cout << "显式构造函数被调用\n";
    }
};

void printExplicitString(ExplicitString str) {
    std::cout << "打印显式字符串\n";
}

int main() {
    // printExplicitString("Hello");  // 错误!不能隐式转换

    ExplicitString str1("Hello");     // 正确 - 直接构造
    printExplicitString(str1);        // 正确 - 传递已有对象
    printExplicitString(ExplicitString("World"));  // 正确 - 显式转换

    return 0;
}
跟它对应的另一个关键字是 implicit,意思是隐藏的,类构造函数默认情况下声明为 implicit。
class MyString {
public:
    // 隐式构造函数 - 可以从const char*隐式转换
    MyString(const char* str) {
        std::cout << "隐式构造函数被调用\n";
    }
};

void printString(MyString str) {
    std::cout << "打印字符串\n";
}

int main() {
    printString("Hello");  // 隐式转换:const char* → MyString
    return 0;
}
成员变量初始化的顺序
成员变量在使用初始化列表初始化时,与构造函数中初始化成员列表的顺序无关,只与定义成员变量的顺序有关。
如果不使用初始化列表初始化,在构造函数内初始化时,此时与成员变量在构造函数中的位置有关。
类中 const 成员常量必须在构造函数初始化列表中初始化。
类中 static 成员变量,只能在类外初始化。
顺序:基类的静态变量或全局变量,派生类的静态变量或者全局变量,基类的成员变量,派生类的成员变量。
指针占用的大小
64 位电脑上占 8 字节,32 位的占 4 字节,
我们平时所说的计算机多少位是指计算机 CPU 中通用寄存器一次性处理、传输、暂时保存的信息的最大长度。即 CPU 在单位时间内能一次处理的二进制的位数,因此 CPU 所能访问的内存所有地址由多少位组成,而 8 比特位表示 1字节,就可以得出在不同位数的机器中指针的大小。
野指针和内存泄漏
内存泄漏:是指程序中以动态分配的堆内存由于某种原因程序未释放或无法释放,造成系统内存的浪费,导致程序运行速度减慢甚至系统崩溃等严重后果。
避免:使用智能指针管理资源,在释放对象数组时使用 delete[],尽量避免在堆上分配内存。
野指针:指向一个已删除的对象或未申请访问受限内存区域的指针。
避免:对指针进行初始化,用已合法的可访问内存地址对指针初始化,指针用完释放内存,将指针赋值 nullptr。
malloc 和 new 的区别
Malloc/free 是标准库函数,new/delete 是 C++运算符
Malloc 分配内存失败返回空,new 失败抛异常
New/delete 会调用构造析构函数,malloc/free 不会,所以他们无法满足动态对象的要求。
New 返回有类型的指针,malloc 返回无类型的指针
分配内存的位置:malloc 从堆上动态分配内存,new 是从自由存储区为对象动态分配内存(取决于 operator new 的实现,比较类可以重写操作符函数,具体分配就看函数实现了,可以为堆还可以是静态存储区)
New 申请内存的步骤:调用 operator new 函数,分配一块足够大,且原始的,未命名的内存空间来存储特定类型的对象。运行相应的构造函数来构造对象,并为其传入初值,返回一个指向该对象的指针。
Delete:先调用对象的析构函数,再调用 operator delete 函数释放内存空间
多线程问题,线程同步
影响:会引发资源竞争的问题,频繁上锁会导致程序运行效率低下,甚至会导致发生死锁。
线程同步手段:使用 atomic 原子变量,使用互斥量也就是上锁,使用条件变量或信号量制约对共享资源的并发访问。
STL
它是 C++标准库的重要组成部分,不仅是一个可复用的组件库也是一个包含了数据结构与算法的软件架构,它拥有六大组件分别是:仿函数,算法,迭代器,空间配置器,容器,配接器
仿函数:重载了函数调用运算符operator()的类或结构体。这样的对象可以像函数一样被调用。
#include <iostream>

// 定义一个仿函数类
struct Square {
    int operator()(int x) const {
        return x * x;
    }
};

int main() {
    Square square;  // 创建仿函数对象
    std::cout << square(5) << std::endl;  // 像函数一样调用,输出 25
    return 0;
}
标准库中:
#include <functional>
#include <iostream>

int main() {
//算术运算仿函数
    std::plus<int> add;
    std::minus<int> subtract;
    std::multiplies<int> multiply;
    std::divides<int> divide;
    std::modulus<int> mod;

    std::cout << add(10, 5) << std::endl;      // 15
    std::cout << subtract(10, 5) << std::endl; // 5
    std::cout << multiply(10, 5) << std::endl; // 50
    std::cout << divide(10, 5) << std::endl;   // 2
    std::cout << mod(10, 3) << std::endl;      // 1
//关系运算仿函数
    std::equal_to<int> equal;
    std::not_equal_to<int> not_equal;
    std::greater<int> greater;
    std::less<int> less;
    std::greater_equal<int> greater_equal;
    std::less_equal<int> less_equal;

    std::cout << std::boolalpha;
    std::cout << equal(5, 5) << std::endl;        // true
    std::cout << greater(5, 3) << std::endl;      // true
    std::cout << less(5, 3) << std::endl;         // false
//逻辑运算仿函数
    std::logical_and<bool> and_op;
    std::logical_or<bool> or_op;
    std::logical_not<bool> not_op;

    std::cout << std::boolalpha;
    std::cout << and_op(true, false) << std::endl; // false
    std::cout << or_op(true, false) << std::endl;  // true
    std::cout << not_op(true) << std::endl;        // false
//与算法配合使用
 	std::vector<int> numbers = {1, 2, 3, 4, 5, 6, 7, 8, 9, 10};

    // 使用 greater 仿函数进行降序排序
    std::sort(numbers.begin(), numbers.end(), std::greater<int>());
    // 使用 bind2nd 和 less 仿函数(C++17 之前)
    // 统计大于 5 的元素个数
    auto count = std::count_if(numbers.begin(), numbers.end(), [](int x) { return x > 5; });

    std::cout << "大于5的元素个数: " << count << std::endl;

    return 0;
}
算法:
主要定义在 <algorithm> 头文件中。以下是主要的分类和常用算法:

//1. 非修改序列操作
for_each()         // 对每个元素执行操作
all_of()           // 所有元素满足条件返回true
any_of()           // 任一元素满足条件返回true
none_of()          // 没有元素满足条件返回true
count()            // 统计等于特定值的元素个数
count_if()         // 统计满足条件的元素个数
find()             // 查找特定值
find_if()          // 查找满足条件的元素
find_if_not()      // 查找不满足条件的元素
search()           // 查找子序列
find_end()         // 查找最后一个匹配的子序列
adjacent_find()    // 查找相邻的重复元素
mismatch()         // 查找两个序列第一个不同的位置
equal()            // 判断两个序列是否相等
//2. 修改序列操作
copy()             // 复制序列
copy_if()          // 复制满足条件的元素
copy_n()           // 复制前n个元素
copy_backward()    // 从后往前复制
move()             // 移动元素
move_backward()    // 从后往前移动
transform()        // 对元素进行变换
replace()          // 替换特定值
replace_if()       // 替换满足条件的元素
replace_copy()     // 替换并复制到新序列
fill()             // 用特定值填充
fill_n()           // 填充前n个元素
generate()         // 用生成器函数填充
generate_n()       // 用生成器填充前n个元素
remove()           // 移除特定值
remove_if()        // 移除满足条件的元素
remove_copy()      // 移除并复制到新序列
unique()           // 去除相邻重复元素
unique_copy()      // 去重并复制到新序列
reverse()          // 反转序列
reverse_copy()     // 反转并复制到新序列
rotate()           // 旋转序列
rotate_copy()      // 旋转并复制到新序列
random_shuffle()   // 随机重排(C++17弃用)
shuffle()          // 随机重排(使用随机数引擎)
//3. 排序和相关操作
sort()             // 排序
stable_sort()      // 稳定排序
partial_sort()     // 部分排序
partial_sort_copy()// 部分排序并复制
nth_element()      // 使第n个元素就位
is_sorted()        // 检查是否已排序
is_sorted_until()  // 查找第一个破坏排序的元素
merge()            // 合并两个有序序列
inplace_merge()    // 原地合并
//4. 二分查找(要求序列已排序)
lower_bound()      // 返回第一个不小于给定值的元素
upper_bound()      // 返回第一个大于给定值的元素
equal_range()      // 返回等于给定值的范围
binary_search()    // 判断是否存在特定值
//5. 划分操作
partition()        // 根据条件划分序列
stable_partition() // 稳定划分
partition_copy()   // 划分并复制到两个序列
is_partitioned()   // 检查是否已划分
partition_point()  // 返回划分点
//6. 堆操作
make_heap()        // 构建堆
push_heap()        // 向堆添加元素
pop_heap()         // 从堆移除元素
sort_heap()        // 堆排序
is_heap()          // 检查是否为堆
is_heap_until()    // 检查直到哪个位置还是堆
//7. 最小/最大操作
min()              // 返回较小值
max()              // 返回较大值
minmax()           // 返回最小和最大值
min_element()      // 返回最小元素位置
max_element()      // 返回最大元素位置
minmax_element()   // 返回最小和最大元素位置
clamp()            // 将值限制在范围内(C++17)
//8. 比较操作
equal()            // 判断是否相等
lexicographical_compare() // 字典序比较
//9. 排列操作
next_permutation() // 下一个排列
prev_permutation() // 上一个排列
is_permutation()   // 判断是否为排列
//10. 数值算法(在 <numeric> 中)
iota()             // 用递增序列填充
accumulate()       // 累加
inner_product()    // 内积
partial_sum()      // 部分和
adjacent_difference() // 相邻差
gcd()              // 最大公约数(C++17)
lcm()              // 最小公倍数(C++17)
//使用示例
#include <algorithm>
#include <vector>
#include <iostream>

int main() {
    std::vector<int> vec = {3, 1, 4, 1, 5, 9, 2, 6};

    // 排序
    std::sort(vec.begin(), vec.end());//1 1 2 3 4 5 6 9

    // 查找
    auto it = std::find(vec.begin(), vec.end(), 5);//*it=5

    // 计数
    int count = std::count(vec.begin(), vec.end(), 1);//2

    // 变换
    std::transform(vec.begin(), vec.end(), vec.begin(),
                   [](int x) { return x * 2; });//2 2 4 6 8 10 12 18

    return 0;
}
空间配置器:
STL 容器的内存管理员。当你使用 vector.push_back() 插入一个元素时,vector 自己并不直接调用 new 或 malloc,而是通过其内置的空间配置器对象来申请内存并构造对象。
配接器
配接器是一种设计模式,它用于将一个类的接口转换成另一个客户期望的接口。在 STL 中,配接器通过包装已有的组件,改变其接口,使其适应不同的使用场景。
迭代器和指针的区别
迭代器不是指针,是一个模板类,通过重载了指针的一些操作符模拟了指针的一些功能,迭代器返回的是对象引用而不是对象的值。
指针能够指向函数而迭代器不行,迭代器只能指向容器。
线程的状态 与 线程锁
五种状态:创建,就绪,运行,阻塞,死亡
线程锁的种类:
互斥锁:
条件锁:
调用 cv.wait(lock, predicate) 时:
自动释放锁:wait() 方法会自动释放传入的互斥锁
进入等待:线程进入等待状态,不占用CPU
被唤醒时重新获取锁:当被 notify 唤醒后,在返回前会重新获取互斥锁
void consumer() {
    std::unique_lock<std::mutex> lock(mtx);  // 1. 消费者获取锁
    cv.wait(lock, []{ return ready; });      // 2. wait()内部释放锁,进入等待
                                              // 5. 被唤醒后重新获取锁,继续执行
    std::cout << "Consumer: Data is ready!" << std::endl;
} // 6. lock析构,自动释放锁

void producer() {
    std::this_thread::sleep_for(std::chrono::seconds(1));

    {
        std::lock_guard<std::mutex> lock(mtx); // 3. 生产者可以获取锁(消费者已释放)
        ready = true;                          // 4. 修改条件
    } // 自动释放锁

    cv.notify_one(); // 通知等待的消费者
}
自旋锁:
#include <atomic>

class Spinlock {
private:
    std::atomic_flag flag = ATOMIC_FLAG_INIT;

public:
    void lock() {
        while (flag.test_and_set(std::memory_order_acquire)) {
            // 自旋等待
        }
    }

    void unlock() {
        flag.clear(std::memory_order_release);
    }
};

Spinlock spinlock;
int spinlock_data = 0;

void spinlock_increment() {
    for (int i = 0; i < 100000; ++i) {
        spinlock.lock();
        ++spinlock_data;
        spinlock.unlock();
    }
}
读写锁:
#include <shared_mutex>

std::shared_mutex rw_mutex;
int rw_data = 0;

void reader(int id) {
    for (int i = 0; i < 5; ++i) {
        std::shared_lock<std::shared_mutex> lock(rw_mutex); // 共享锁
        std::cout << "Reader " << id << " reads: " << rw_data << std::endl;
        std::this_thread::sleep_for(std::chrono::milliseconds(100));
    }
}

void writer(int id) {
    for (int i = 0; i < 3; ++i) {
        std::unique_lock<std::shared_mutex> lock(rw_mutex); // 独占锁
        ++rw_data;
        std::cout << "Writer " << id << " writes: " << rw_data << std::endl;
        std::this_thread::sleep_for(std::chrono::milliseconds(200));
    }
}

int main() {
    std::thread readers[3];
    std::thread writers[2];

    for (int i = 0; i < 3; ++i) {
        readers[i] = std::thread(reader, i);
    }

    for (int i = 0; i < 2; ++i) {
        writers[i] = std::thread(writer, i);
    }

    for (auto& t : readers) t.join();
    for (auto& t : writers) t.join();

    return 0;
}
递归锁:
#include <mutex>

std::recursive_mutex rec_mtx;

void recursive_function(int count) {
    std::lock_guard<std::recursive_mutex> lock(rec_mtx);

    if (count > 0) {
        std::cout << "Count: " << count << std::endl;
        recursive_function(count - 1); // 可以重复获取同一个锁
    }
}

class RecursiveExample {
private:
    std::recursive_mutex mtx;
    int data = 0;

public:
    void method1() {
        std::lock_guard<std::recursive_mutex> lock(mtx);
        data++;
        method2(); // 调用另一个也需要锁的方法
    }

    void method2() {
        std::lock_guard<std::recursive_mutex> lock(mtx); // 可以重复获取
        data *= 2;
    }
};
| 锁类型 | 特点 | 适用场景 | 性能考虑 |
|---|---|---|---|
| 互斥锁 | 基本的互斥操作,不可重入 | 一般临界区保护 | 线程阻塞,上下文切换开销 |
| 条件变量 | 用于线程间通信和同步 | 生产者-消费者模式,等待特定条件 | 需要配合互斥锁使用 |
| 自旋锁 | 忙等待,不放弃CPU | 锁持有时间很短的场景 | 避免上下文切换,但消耗CPU |
| 读写锁 | 读共享,写互斥 | 读多写少的场景 | 提高读操作的并发性 |
| 递归锁 | 同一线程可重复获取 | 递归调用或复杂对象方法 | 比普通互斥锁稍慢 |
map 和 unordered_map
Map 内部实现是一个红黑树,内部所有的元素都是有序的,而hashmap 则是内部实现了一个哈希表,内部存储元素是无序的
Map 优点:有序性,其次是内部实现的是一个红黑树,使得很多操作都可以在 logn 的复杂度下可以实现效率较高。
Map 缺点:空间占用率高
Unorderedmap 优点:查找效率非常高。缺点:哈希表的建立比较费时间
vector中的push_back()和emplace_back()
当使用 Push_back 时会先调用类的有参构造函数创建一个临时变量,再将这个元素拷贝或者移动到容器之中,而 emplace_back 则是直接在容器尾部进行构造比 push_back 少进行一次构造函数调用。
在大部分场景中 emplace_back 可以替换 push_back,但是 push_back
会比 emplace_back 更加安全,emplace_back 只能用于直接在容器中构造新元素的情况,如果要将现有的对象添加到容器中则需要使用push_back。
如何实现线程安全
除了锁之外还可以使用互斥量(防止多个线程来同时访问共享资源,从而避免数据竞争的问题,互斥量是底层同步机制,锁是用于安全管理互斥量的RAII包装器。在实际编程中,应该优先使用锁来管理互斥量。)
原子操作(原子操作是不可分割的,使用原子操作可以确保在多线程环境中操作是安全的)
条件变量(协调线程之间的协作,用来在线程之间传递信号,从而控制线程的执行流程)等方式
vector 扩容,resize 和 reserve 的区别
使用 resize 改变的是 vector 的大小(size),可能会添加或删除元素。
使用 reserve 改变的是 vector 的容量(capacity),不会改变当前元素的数量,仅仅是为了优化内存使用和性能(多次修改大小可能会自行调用很多次reserve,一次reserve会提升性能)。
vector 扩容
当 vector 内存不够时本身内存会以 1.5 或者 2 倍的增长,以减少扩容次数,引入了 reserve,自定义 vector 最大容量。
C++中空类的大小是1个字节
除非是位域,否则大多数派生对象应具有非零大小,并应占用一个或多个字节的存储空间。
占用一个字节,那么地址就不会全是0.
weak_ptr 的实现
实现依赖于计数器和寄存器实现的,计数器用来记录弱引用的数量,寄存器用来存储 shared_ptr。
虚函数的底层原理
虚函数表和虚表指针
跳转到weak_ptr例子
一个函数 f(int a,int b),其中 a 和 b 的地址是相邻的。
移动构造和拷贝构造的区别
移动构造函数本质上是基于指针的拷贝,实现对堆区内存所有权的移交,在一些特定场景下,可以减少不必要的拷贝。比如用一个临时对象或者右值对象初始化类实例时。我们可以使用 move()函数,将一个左值对象转变为右值对象。
而拷贝构造则是将传入的对象复制一份然后放进新的内存中
lamda 表达式捕获列表捕获的方式,引用捕获注意点
分为按值捕获和引用捕获,默认的引用捕获可能会导致悬挂引用,引用捕获会导致闭包包含一个局部变量的引用或者形参的引用,如果一个由lambda 创建的闭包的生命周期超过了局部变量或者形参的生命期,那么闭包的引用将会空悬(未定义行为或者访问非法内存)。解决方法是对个别参数使用值捕获
哈希碰撞的处理方法
哈希碰撞也就是两个或更多不同的输入值,经过同一个哈希函数计算后,得到了相同的哈希值。
开放寻址法:当遇到哈希冲突时,去寻找一个新的空闲的哈希地址。(线性探测)
再哈希法:同时构造多个哈希函数,等发生哈希冲突时就使用其他哈希函数直到不发生冲突为止,虽然不易发生聚集,但是增加了计算时间。
链地址法:将所有的哈希地址相同的记录都链接在同一链表中建立公共溢出区:将哈希表分为基本表和溢出表,将发生冲突的都存放在溢出表中。(查找时,先通过哈希函数找到对应的桶,然后遍历这个桶里的链表,直到找到匹配的键)
unordered_map 的扩容过程
当 unordered_map 中的元素数量达到桶的负载因子(0.75)时,会重新分配桶的数量(通常会按照原有桶的数量*2 的方式进行扩容,但是具体的增长策略也可以通过修改容器中的 max_load_factor 成员变量来进行调整),并将所有的元素重新哈希到新的桶中。
哈希表 (数组)
↓
[桶0] → 元素1 → 元素2 → … // 链表
[桶1] → 元素3
[桶2] → 空
[桶3] → 元素4 → 元素5
…
vector 如 何 判断 应 该 扩容 ( size 和capacity)
由当前容器内元素数量的大小和容器最大大小进行比较如果二者相等就会进行扩容,一般是 1.5 倍,部分的有2倍
构造函数不能声明为虚函数
构造函数不能为虚函数,虚函数的调用是通过虚函数表来查找的,而虚函数表由类的实例化对象的 vptr 指针指向,该指针存放在对象的内部空间之中,需要调用构造函数完成初始化,如果构造函数为虚函数,那么调用构造函数就需要去寻找 vptr,但此时 vptr 还没有完成初始化,导致无法构造对象。
类中 static 函数不能声明为虚函数
因为类中的 static 函数是所有类实例化对象所共有的,没有 this 指针,而虚函数依靠 vptr 和 vtable 来处理,vptr 是一个指针,在类中的构造函数中生成,并且只能通过 this 指针访问,对于静态成员函数来说,他没有 this 指针,无法访问 vptr,因此 static函数无法声明为虚函数。
哪些函数不能被声明为虚函数
构造函数,内联函数(内联函数有实体,在编译时展开,没有 this指针),静态成员函数,友元函数(C++不支持友元函数的继承),非类成员函数。
如何保证类的对象只能被开辟在堆上?
(将构造函数声明为私有、单例)
将析构函数设为私有,当析构函数为私有成员时,在栈上创建对象会导致编译错误,因为栈上对象在生命周期结束时会自动调用析构函数,而私有析构函数在类外部无法访问。但在堆上通过 new 操作符创建对象时,可以在类的成员函数或友元函数中显式地调用 delete 来释放对象,从而调用私有析构函数。
只能开辟到栈上
将 operator new 和 operator delete 设为私有或删除。
虚基类
虚基类是 C++ 中一种特殊的类,用于解决多继承所带来的“菱形继承”问题。如果一个派生类同时从两个基类派生,而这两个基类又共同继承自同一个虚基类,就会形成一个“菱形”继承结构,导致派生类中存在两份共同继承的虚基类的实例,从而引发一系列的问题。
为了解决这个问题,我们可以将虚基类作为共同基类,并在派生类中采用虚继承的方式。
虚继承会使得派生类中只存在一份共同继承的虚基类的实例,从而避免了多个实例之间的冲突。
虚基类是可以被实例化的。
C++不能被重载的运算符
成员访问操作符(.)
域解析操作符(:😃
条件运算符(:?)
其中并不推荐对逗号运算符,逻辑或逻辑与之类运算符进行重载,容易造成歧义。
动态链接和静态链接的区别,原理
区别:他们的最大区别就是在于链接的时机不同,静态链接是在形成可执行程序前,而动态链接的进行则是程序执行时。
静态库:就是将库中的代码包含到自己的程序之中,每个程序链接静态库后,都会包含一份独立的代码,当程序运行起来时,所有这些重复的代码都需要占用独立的存储空间,显然很浪费计算机资源。
动态库:不会将代码直接复制到自己程序中,只会留下调用接口,程序运行时再去将动态库加载到内存中,所有程序只会共享这一份动态库,因此动态库也被称为共享库。
动态链接原理:是把程序按照模块拆分成各个相对独立部分,在程序运行时才将它们链接在一起形成一个完整的程序,而不是像静态链接一样把所有程序模块都链接成一个单独的可执行文件。
C++中编译 C 语言代码
使用 extern"C"让 C++代码按照 C 语言的方式去编译。在 C++ 代码里调用 C 函数时,要使用 extern “C” 声明,这样可以避免 C++的命名修饰,保证链接时能正确找到 C 函数的符号。
未初始化的全局变量和初始化的全局变量存放
初始化的全局变量存放在数据段,数据段数据静态分配。
未初始化的全局变量存放在 BSS(Block Started By Symbol)段, 属于静态内存分配
内存布局:
+------------------+
|     .text        |  // 代码段
+------------------+
|     .rodata      |  // 只读数据(如 initialized_global=42)
+------------------+
|     .data        |  // 已初始化的全局/静态变量
+------------------+
|     .bss         |  // 未初始化的全局/静态变量(全部初始化为0)
+------------------+
|     heap         |  // 堆
+------------------+
|     stack        |  // 栈
+------------------+
不会转移:BSS段的变量在整个程序生命周期都保持在BSS段
编译时确定:变量的段归属在编译链接阶段就确定了
启动时初始化:BSS段在程序启动时被系统初始化为0
原地操作:后续对BSS段变量的赋值操作都是在原内存位置进行的
内联函数及其优缺点
内联函数是在编译期将函数体内嵌到程序之中,以此来节省函数调用的开销。
优点:是节省了函数调用的开销,让程序运行更加快速。
缺点:是如果函数体过长,频繁使用内联函数会导致代码编译膨胀问题,不能递归执行。
C++11 中的 auto 的实现,模板转化成不同类型
auto 仅仅只是一个占位符,在编译期间它会被真正的类型替代,或者说 C++中变量必须要有明确类型的,只是这个类型是由编译器自己推导出来的。
函数模板是一个蓝图,它本身并不是函数,是编译器用使用方式具体类型函数的模具(函数模板是一个模具,编译器会根据我们使用模板时提供的具体类型,用这个模具来生成具体的函数。),所以模板其实就是将原本应该我们做重复的事情交给了编译器。
本身不是函数: 编译器在编译初期看到模板定义时,并不会立即为其生成机器代码。因为它不完整,不知道具体的类型(比如是处理 int 还是 string),所以无法创建出一个具体的函数。
编译器用使用方式: 当你在代码中使用这个模板时(即调用它),你必须以某种方式提供这些“空白”的具体内容。编译器会根据你调用时提供的具体类型来动手“施工”。
生成具体函数: 编译器拿到具体类型后,会将模板中的“空白”(类型参数)替换成你提供的实际类型(如 int),从而生成一个完整的、可以执行的函数。这个过程叫做模板实例化。
map 和 set 的区别和底层实现
底层都是红黑树。
map 取值的 find,[],at 方法的区别
- find 查找需要判断返回的结果才知道有没有查询成功。
- []不管有没有就是 0,如果原先不存在该 key,则插入,如果存在则覆盖插入
- at 方法则会进行越界检查,这会损失性能,如果存在则返回它的值,如果不存在则抛出异常。
fcntl 的作用
作用:用于控制打开的文件描述符的一些属性和行为。
有五个功能:
1.复制一个现有的描述符(cmd=F_DUPFD)
2.获得/设置文件描述符标记(cmd=F_GETFD 或 F_SETFD)
3.获取/设置文件状态标记(cmd=F_GETFL 或 F_SETFL)
4.获取设置异步 IO 所有权(cmd=F_GETOWN 或 F_SETFL)
5.获取设置记录锁(cmd=F_GETLK 或 F_SET)
C++的面向对象主要体现的方面
体现在 C++引入了面向对象的一些特征,例如加入了封装继承多态的特点。
extern C 关键字
是用来实现在 C++代码段中用 C 语言的方式来编译代码,是 C++为了兼容 C 语言所加入的关键字
迭代器失效及其解决方法
序列式容器迭代器失效:当当前元素的迭代器被删除后,后面所有元素的迭代器都会失效,他们都是一块连续存储的空间,所以当使用 erase 函数操作时,其后的每一个元素都会向前移动一个位置,此时可以使用 erase 函数操作可以返回下一个有效的迭代器。
Vector 迭代器失效问题总结:
- 当执行了 erase 方法时,指向删除节点的迭代器全部失效,指向删除节点之后的全部迭代器也失效。
- 当进行 push_back 方法时,end 操作返回的迭代器肯定失效。
- 当插入一个元素后,capacity 返回值与没有插入元素之前相比有改变,则需要重新加载整个容器,此时 first 和 end 操作返回的迭代器失效。
- 当插入一个元素后,如果空间未重新分配,指向插入位置之前
元素的迭代器依然有效,但指向插入元素之后元素的迭代器全部失效。
Deque 迭代器失效总结:
- 对于 deque,插入到除首尾位置之外的任何位置都会导致迭代器、指针和引用都会失效,如果在首尾位置添加元素,迭代器会失效,但是指针和引用不会失效。
- 如果在首尾之外的任何位置删除元素,那么指向被删除元素外其他元素的迭代器都会失效。
- 如果在其首部和尾部删除元素则只会使指向被删除元素的迭代器失效。
deque的实现
deque 通常采用分段的连续空间实现,由多个固定大小的数组块(buffer)组成,通过一个中央控制器(map)来管理这些数组块。也就是元素指针的指针进行管理,提前分配多个块,占用中间位置,头尾扩充。
中央控制器 (map)
┌─────┬─────┬─────┬─────┬─────┐
│ * │ * │ * │ * │ * │
└─────┴─────┴─────┴─────┴─────┘
│ │ │ │ │
▼ ▼ ▼ ▼ ▼
┌───┐ ┌───┐ ┌───┐ ┌───┐ ┌───┐
│ │ │ │ │ │ │ │ │ │ ← 缓冲区
│ │ │ │ │ │ │ │ │ │ (固定大小数组)
└───┘ └───┘ └───┘ └───┘ └───┘
template<typename T>
class SimpleDeque {
private:
    static const size_t BUFFER_SIZE = 512;  // 每个缓冲区的大小

    T** map;              // 中央控制器:指向缓冲区的指针数组
    size_t map_capacity;  // map 的容量
    size_t map_size;      // map 中实际使用的缓冲区数量

    // 第一个和最后一个元素的位置
    size_t start_map_index;  // 在 map 中的索引
    size_t start_elem_index; // 在缓冲区中的索引
    size_t end_map_index;    // 在 map 中的索引
    size_t end_elem_index;   // 在缓冲区中的索引

    // 分配新的缓冲区
    T* allocate_buffer() {
        return new T[BUFFER_SIZE];
    }

    // 扩展中央控制器
    void expand_map() {
        size_t new_capacity = map_capacity * 2 + 1;
        T** new_map = new T*[new_capacity];

        // 复制原有指针到新 map 的中间位置
        size_t start_index = (new_capacity - map_size) / 2;
        for (size_t i = 0; i < map_size; ++i) {
            new_map[start_index + i] = map[i];
        }

        delete[] map;
        map = new_map;
        map_capacity = new_capacity;
        start_map_index = start_index;
        end_map_index = start_index + map_size - 1;
    }

public:
    SimpleDeque() : map_capacity(8), map_size(0) {
        map = new T*[map_capacity];
        start_map_index = end_map_index = map_capacity / 2;
        start_elem_index = end_elem_index = 0;

        // 分配第一个缓冲区
        map[start_map_index] = allocate_buffer();
        map_size = 1;
    }

    // 在头部插入
    void push_front(const T& value) {
        if (start_elem_index == 0) {
            // 需要新的缓冲区
            if (start_map_index == 0) {
                expand_map();
            }
            start_map_index--;
            map[start_map_index] = allocate_buffer();
            map_size++;
            start_elem_index = BUFFER_SIZE;
        }
        start_elem_index--;
        map[start_map_index][start_elem_index] = value;
    }

    // 在尾部插入
    void push_back(const T& value) {
        map[end_map_index][end_elem_index] = value;
        end_elem_index++;

        if (end_elem_index == BUFFER_SIZE) {
            // 需要新的缓冲区
            if (end_map_index == map_capacity - 1) {
                expand_map();
            }
            end_map_index++;
            map[end_map_index] = allocate_buffer();
            map_size++;
            end_elem_index = 0;
        }
    }

    // 访问元素
    T& operator[](size_t index) {
        size_t buffer_offset = start_elem_index + index;
        size_t map_index = start_map_index + buffer_offset / BUFFER_SIZE;
        size_t elem_index = buffer_offset % BUFFER_SIZE;
        return map[map_index][elem_index];
    }

    // 获取大小
    size_t size() const {
        if (start_map_index == end_map_index) {
            return end_elem_index - start_elem_index;
        }
        return (BUFFER_SIZE - start_elem_index) +
               (end_map_index - start_map_index - 1) * BUFFER_SIZE +
               end_elem_index;
    }
};
关联型容器迭代器失效:
删除当前的迭代器,仅仅会使当前的迭代器失效,只要 erase 时,递增当前迭代器即可。
编译器实现重载
在编译时,编译器如果遇到了函数,就会在符号表里面命名一个符号来存放函数的地址,如果函数的使用在定义之前编译,无法在符号表中找到对应函数地址,则先标记为“?”(暂时未知),在全部编译结束后的链接过程将“?”在符号表里找到并替代为相应的函数地址,如果函数的定义在使用之前编译,则可以直接在符号表里找到对应函数地址直接使用
而在 C 语言中的符号表是以函数名为符号来存储函数地址,函数名相同的重载函数的地址应该不同,于是符号表中存在两个同符号的函数地址,在查找使用时会存在歧义和冲突。所以c语言不存在函数重载。
而C++符号表中的符号不是以函数名命名的,称为函数名修饰规则,虽然函数名相同,但是函数参数等其他属性不同,取的符号也不同,所以不会产生查询歧义的问题,使得函数可以重载。
函数调用约定
函数调用约定就是对函数调用的一个约束和规定,描述了函数参数是怎么传递和由谁清除堆栈的。它决定了,函数参数传递的方式(是否采用寄存器传递参数,采用哪个寄存器传递参数,参数压栈的顺序等),函数调用结束后栈指针由谁恢复(被调用的函数恢复还是调用者恢复),函数修饰名的产生方法。
__stdcall:
是 standardcall 的缩写,是 C++的标准调用方式
规则如下:所有参数从右到左依次入栈,如果是调用类成员的话,最后一个入栈的是 this 指针。被调用函数自动清理堆栈,返回值在 EAX。
函数修饰名约定:VC 将函数编译后会在函数名前面加上下划线前缀,在函数名后加上“@”和参数的字节数。
__cdecl
是 C DECLaration 的缩写(declaration,声明),表示 C 语言的默认函数调用方法
规定如下:所有参数从右往左依次入栈,所有参数由调用者清除,称为手动清栈。返回值在 EAX 中。
函数修饰名约定:VC 将函数编译后会在函数名前面加上下划线前缀,由
于由调用者清理栈,所以允许可变参数函数存在。
__fastcall
是快速调用约定,通过寄存器来传送参数
规则如下:用 ECX 和 EDX 传送前两个双字(DWORD)或更小的参数,剩下的参数仍然自右向左压栈传送。被调用函数在返回前清理传送参数的内存栈,返回值在 EAX 中
函数修饰名约定:VC 将函数编译后会在函数名前面加上“@”前缀,在函数名后加上“@”和参数的字节数。
__thiscall
是唯一一个不能明确指明的函数修饰符,thiscall只能用于处理 C++类成员函数的调用,同时 thiscall 也是 C++成员函数缺省的调用约定,由于成员函数调用还有一个 this 指针,因此必须特殊处理
规定如下:采用栈传递参数,参数从右向左入栈,如果参数个数确定,this 指针通过 TCX 传递给被调用者,如果参数个数不确定,this 指针在所有参数压栈后被压入堆栈。对参数个数不确定的,调用者清理堆栈,否则由被调函数清理堆栈,__thiscal 不是关键字
程序员不能使用__pascal:与__stdcall 一样,在 VC 中已经被废弃。
条件变量
条件变量举例
当 signal 先于 wait 时,该信号会丢失,不会被后续的 wait 捕获条件变量 wait 。(信号丢失是正常的:条件变量的设计就是如此,不是 bug)
条件的判断和 wait 操作需要锁来保证原子性,要保证这一点,需要生产者在生产资源、cond signal 时加和 cond wait相同的锁,这样就会保证 cond wait 和 cond signal 先后顺序不会有问题,无论是谁先执行,都不会存在任何问题。
避免信号丢失和保证原子性
信号丢失问题:由于使用了谓词和锁,即使 notify 操作先于 wait 操作,在 wait 操作时会重新检查谓词,确保条件满足才会继续执行,避免了信号丢失的问题。
原子性:wait 操作会自动释放锁并进入等待状态,当被唤醒时会重新获取锁,保证了条件判断和 wait 操作的原子性。生产者和消费者在操作共享资源和调用 notify 时都使用了相同的锁,确保了操作的先后顺序不会出现问题。
总结:
总是使用谓词:cv.wait(lock, predicate) 是避免信号丢失的标准做法,谓词(一个返回bool的函数)来检查条件是否已经满足。实际上,wait的内部实现会检查谓词,如果谓词为true,则不会阻塞,直接继续执行
// 条件变量的 wait 方法内部逻辑大致如下:
template<typename Predicate>
void wait(std::unique_lock<std::mutex>& lock, Predicate pred) {
    while (!pred()) {  // ⚠️ 关键:在等待前和每次唤醒后都会检查谓词
        wait(lock);
    }
    // 只有当 pred() 返回 true 时,才会继续执行,且此时已经重新获取了锁
}
谓词检查条件状态:确保即使信号丢失,只要条件满足就能继续执行
条件变量不存储状态:它只负责通知,不记录是否发生过通知
共享状态是必须的:需要一个共享变量来记录真正的条件状态
std::condition_variable cv;
std::mutex mtx;
bool ready = false;

void sender() {
    std::this_thread::sleep_for(std::chrono::milliseconds(100));
    {
        std::lock_guard<std::mutex> lock(mtx);
        ready = true;
        std::cout << "Sender: 条件已满足,发送通知" << std::endl;
    }
    cv.notify_one();
}

void receiver() {
    std::this_thread::sleep_for(std::chrono::milliseconds(200));
    std::unique_lock<std::mutex> lock(mtx);
    std::cout << "Receiver: 开始等待通知" << std::endl;

    // ✅ 使用谓词检查:如果条件已经满足,就不会进入等待
    cv.wait(lock, []{
        std::cout << "检查条件: ready = " << ready << std::endl;
        return ready;
    });

    std::cout << "Receiver: 收到通知,继续执行" << std::endl;
}
类内普通成员函数、类内静态变量、类内静态成员函数、类内普通变量
类内普通成员函数可以调用类内静态变量,因为类内静态变量在编译时就已经完成了初始化和内存分配,类内普通函数调用类内静态变量说明类已经完成实例化,所以可以调用。
静态函数可以直接访问静态变量,静态函数不能直接访问非静态变量,但是可以通过将类实例化对象后,静态函数去访问对象的非静态成员变量。
强制类型转换类型,特点,原理
Static_cast
用于数据类型的强制转换,强制将一种数据类型转化为另一种数据类型。
主要用法:
- 用于类层次结构中基类和派生类之间指针或引用的转换,进行上行切换(把派生类的指针或引用转换成基类表示)是安全的,进行下行转换(把基类的指针或引用转换为派生类表示),由于没有动态类型检查,所以是不安全的。
- 用于基本类型之间的转换,如把 int 转换成 char,这种类型的转换也需要开发人员来保证
- 把空指针转换成目标类型的空指针。
- 把任意类型的表达式转换成 void 类型
- 涉及到类时,只能在有相互联系的类型中进行相互转换,不一定包含虚函数
注意:不能转换掉表达式中的 const,volitale,__unaligned 属性
Const_cast
用于强制去除类似于 const 这种不能被修改的常数特性。
用法:
- 用来修改类型的const或者volatile属性,除了const或volatile修饰之外,type_id 和 expression 的类型是一样的。
- 常量指针被转化为非常量指针,并且仍然指向原来的对象
- 常量引用被转换为非常量引用,并且仍指向原来的对象,常量对象被转换成非常量对象。
注意:const_cast 不适用于去除变量的常量性,而是去除指向常数对象的指针或引用的常量性,即去除常量性的对象必须为指针或者引用。
Reinterpret_cast
用于改变指针或引用的类型,将指针或引用类型转换成一个足够长的整形,将整形转换为指针或引用。
用法:
- 传入类型必须是一个指针,引用,算术类型,函数指针,成员函数或成员指针
- 它可以把一个指针转换成一个整数,也可以把一个整数转换成一个指针。
注意:在强制转换的过程中只是比特位的拷贝,使用中必须特别谨慎。
Dynamic_cast
其他三种都是在编译时完成的,它是在运行时处理的,运行时要进行类型检查。
用法:
- 不能用于内置的基本数据类型的强制转换。
- 如果转换成功会返回一个指向类的指针或者引用,转换失败会返回NULL。
- 进行转换的时候基类中一定要有虚函数,否则编译不通过(因为类中存在虚函数就说明它有想让基类指针或引用指向派生类对象的情
况,此时转换才有意义)。 - 在类的转换时,在类层次间进行上行转换时,与 static_cast 的转
换效果是一样的,在下行转换时,它具有类型检查功能,比
static_cast 更安全。
注意:向下转换的成功与否还与将要转换的类型有关,即要转换的指
针指向的对象的实际类型与转换以后的对象类型一定要相同,否则转
换失败。如果转换目标是指针类型转换失败,则结果返回 0,如果是
引用类型则抛出 std::bad_cast 异常
原理:改变了其内存二进制的存储形式。
回调函数优缺点,本质
回调函数是指使用者自己定义一个函数,实现这个函数的程序内容,然后别人把这个函数(入口地址)作为参数传入别人的函数中,由别人的函数在运行时来调用的函数,简单说就是放发生某种事件时,系统或其他函数将会自动调用你定义的一段函数。
可以把调用者和被调用者分开。调用者不关心谁是被调用者,所以它只需要知道的,只是一个存在某种特定类型原型,某些限制条件的被调用数。
优点:
- 可以让实现方根据回调方的多种形态进行不同的处理和操作可以让实现方,根据自己的需要定制回调方的不同形态
- 可以将耗时的操作隐藏在回调方,不影响实现方其他信息的展示。让代码的逻辑更加集中,更加易读。
缺点:
- 回调函数过多会导致代码难以维护
- 回调函数容易造成资源竞争:如果回调函数中有共享资源访问,容易出现资源争抢,导致程序出错
- 代码可读性差,可能会破坏代码的结构和可读性
本质:是将函数当作参数使用,目的是为了使程序更加普适。
Linux 中的信号
SIGINT
终端中断符,默认动作:终止。当用户按中断键(Ctrl+C)时,终端驱动程序产生此信号并发送至前台进程组中的每一个进程,当一个进程在运行时失控,特别是在终端输出大量信息时,常用此信号终止它。
SIGQUIT
终端退出符,默认动作:终止+core。当用户在终端按退出键(Ctrl+\)时,终端驱动程序产生此信号,并发送给前台进程中所有进程,此信号不仅终止前台进程组,同时产生一个 core 文件。
SIGILL
非法硬件指令,默认动作:终止+core。此信号表示进程已执行一条非法硬件指令
SIGTRAP
硬件故障,默认动作:终止+core。指示一个实现定义的硬件故障(断点陷阱)
SIGBUS
硬件故障,默认动作:终止+core。指示一个实现定义的硬件故障,当出现某些类型的内存故障时,常产生此信号。(总线错误 非对齐访问)
SIGKILL
终止,默认动作:终止。这是两个不能被捕捉或忽略的信号之一,它向系统管理员提供一个可以杀死任一进程的可靠方法
SIGSEGV
无效的内存引用,默认动作:终止+core。指示进程进行了一次无效的内存引用,通常说明程序有错,比如 访问了一个未经初始化的指针。
SIGALRM
定时器超时,默认动作:终止。如果在管道的读进程终止时写管道,则产生此信号,当类型为 SOCK_STREAM 的套接字已不再连接时,进程写该套接字也产生此信号。
SIGTERM
终止,默认动作:终止。这是由 kill 命令发出的系统默认终止信号,由于该信号是由应用程序捕获的,所以使用 SIGTERM也让程序有机会在退出之前做好清理工作,与 SIGKILL 不同的是,SIGKILL 不能捕捉。
SIGCONT
使暂停进程继续,默认动作:忽略。此进程发送给需要运行但是目前状态是暂停的进程,如果接收到此信号的进程处于暂停状态则继续运行,否则忽略。
SIGURG
紧急情况,默认动作:忽略。通知进程发生一个紧急情况,在网络上遇到带外的数据时,可以选择产生此信号
SIGPOLL
可轮询事件,默认动作:终止。产生条件当一个可轮询设备上发生一个特定事件时产生
SIGIO
异步 IO,默认动作:终止。产生异步 IO 时产生还有很多就不全部放进来了
尾递归
尾递归是递归的一种特殊情形,尾递归是一种特殊的尾调用,即在尾部直接调用自身的递归函数。核心思想是边调用边产生结果。递归调用发生在函数的最后一步操作,且返回值直接是该递归调用的结果,没有额外的计算。
原理:当编译器检测到一个函数调用是尾递归的时候,它会覆盖当前的活动记录而不是在栈中创建一个新的。
编译器可以做到这一点,因为递归调用是当前活跃期内最后一条待执行的语句,于是当这个调用返回时栈帧中并没有其他事情可以做,因此也就没有保存栈帧的必要了,通过覆盖当前的栈帧而不是在其之上重新添加一个,这样所使用的栈空间就大大缩减了,这使得实际的运行效率会变得更高。
特点:在尾部调用的是函数自身,可通过优化使得计算仅占用常量栈
空间,优化使得递归函数可以处理非常大的输入而不会导致栈溢出,同时保持了递归代码的简洁性
斐波那契数列:
普通递归(效率低下):
int fibonacci(int n) {
    if (n <= 1) return n;
    return fibonacci(n - 1) + fibonacci(n - 2);  // 两个递归调用,不是尾递归
}
尾递归版本:
int fibonacci_tail(int n, int a = 0, int b = 1) {
    if (n == 0) return a;
    if (n == 1) return b;
    return fibonacci_tail(n - 1, b, a + b);  // 尾递归
}

// 使用示例
int fibonacci(int n) {
    return fibonacci_tail(n, 0, 1);
}
为什么会有栈溢出,为什么栈会设置容量?
栈空间是预设的,它通常用于存放临时变量,如果你在函数内部定义一个局部变量,空间超出了设置的栈空间大小,就会溢出。不仅如此,如果函数嵌套太多,也会发生栈溢出,因为函数没有结束前,函数占用的变量也不被释放,占用了栈空间。
原因:是栈的地址空间必须连续,如果任其任意成长,会给内存管理带来困难。对于多线程程序来说,每个线程都必须分配一个栈,因此没办法让默认值太大。(栈需要连续地址空间–>多线程需要多个独立栈–>虚拟地址空间有限且可能碎片化–>因此每个栈不能太大–>导致栈溢出风险)
虚拟地址空间布局:
0xFFFFFFFF ±----------------+
| 内核空间 |
±----------------+
| 栈 (主线程) | ← 向下增长
±----------------+
| … |
±----------------+
| 栈 (线程2) | ← 每个线程栈需要连续空间
±----------------+
| 栈 (线程1) |
±----------------+
| 堆 | ← 向上增长
±----------------+
| BSS/数据段 |
±----------------+
| 代码段 |
0x00000000 ±----------------+
二叉树和平衡二叉树的区别
二叉树没有平衡因子的限制,而平衡二叉树有。
二叉树可能退化为链表,而平衡二叉树不会。
二叉树举例
平衡二叉树的优缺点
优点:避免了二叉排序树可能出现最极端情况(退化为链表),其平
均查找的时间复杂度为 logN
缺点:对 AVL 树做一些结构修改的操作,性能非常低下,比如:插入
时要维护其绝对平衡,旋转的次数比较多,更差的是在删除时,有可
能一直要让旋转持续到根的位置。
二叉树 (Binary Tree)
特征
基本结构:每个节点最多有两个子节点(左子节点和右子节点)
无序性:没有特定的排序规则
灵活性:结构简单,容易实现
可能不平衡:最坏情况下可能退化成链表
#include <iostream>
#include <memory>

template<typename T>
struct BinaryTreeNode {
    T data;
    std::unique_ptr<BinaryTreeNode<T>> left;
    std::unique_ptr<BinaryTreeNode<T>> right;

    BinaryTreeNode(T value) : data(value), left(nullptr), right(nullptr) {}
};

template<typename T>
class BinaryTree {
private:
    std::unique_ptr<BinaryTreeNode<T>> root;

public:
    BinaryTree() : root(nullptr) {}

    // 插入节点(无序,简单实现)
    void insert(T value) {
        if (!root) {
            root = std::make_unique<BinaryTreeNode<T>>(value);
            return;
        }

        // 简单实现:按层次插入
        auto current = root.get();
        while (true) {
            if (!current->left) {
                current->left = std::make_unique<BinaryTreeNode<T>>(value);
                break;
            } else if (!current->right) {
                current->right = std::make_unique<BinaryTreeNode<T>>(value);
                break;
            } else {
                // 简单策略:交替选择左右
                current = current->left.get();
            }
        }
    }

    // 前序遍历
    void preOrder() const {
        preOrder(root.get());
        std::cout << std::endl;
    }

private:
    void preOrder(BinaryTreeNode<T>* node) const {
        if (!node) return;
        std::cout << node->data << " ";
        preOrder(node->left.get());
        preOrder(node->right.get());
    }
};

// 使用示例
void demoBinaryTree() {
    BinaryTree<int> tree;
    tree.insert(5);
    tree.insert(3);
    tree.insert(7);
    tree.insert(1);
    tree.insert(9);

    std::cout << "二叉树前序遍历: ";
    tree.preOrder();  // 输出可能: 5 3 1 7 9
}
平衡二叉树 (Balanced Binary Tree)
特征
平衡性:任意节点的左右子树高度差不超过1
有序性:通常是二叉搜索树(BST)
高效操作:查找、插入、删除时间复杂度 O(log n)
自平衡:通过旋转操作维持平衡
二叉搜索树的特征:
- 有序性:对于任意节点
左子树所有节点的值 < 当前节点的值
右子树所有节点的值 > 当前节点的值 - 中序遍历有序:中序遍历BST会得到升序序列
- 递归定义:左右子树也都是二叉搜索树
- 无重复值:通常不允许重复的键值(可扩展为允许重复)
- 动态集合:支持高效的查找、插入、删除操作
AVL树是最早发明的自平衡二叉搜索树,在BST的基础上增加了平衡条件,对于AVL树中的每个节点,其左右子树的高度差(平衡因子)的绝对值不超过1。
AVL树的特点
- 严格平衡:保证树的高度始终为 O(log n)
- 平衡因子:每个节点存储高度信息
- 旋转操作:通过旋转维持平衡
- 查找高效:最坏情况下也是 O(log n)
AVL树的实现:
template<typename T>
struct AVLNode {
    T data;
    std::unique_ptr<AVLNode<T>> left;
    std::unique_ptr<AVLNode<T>> right;
    int height;

    AVLNode(T value) : data(value), left(nullptr), right(nullptr), height(1) {}
};

template<typename T>
class AVLTree {
private:
    std::unique_ptr<AVLNode<T>> root;

    // 获取节点高度
    int height(const std::unique_ptr<AVLNode<T>>& node) const {
        return node ? node->height : 0;
    }

    // 获取平衡因子
    int getBalance(const std::unique_ptr<AVLNode<T>>& node) const {
        return node ? height(node->left) - height(node->right) : 0;
    }

    // 右旋转 树左侧高度高,将左节点向上提,原节点移到右节点的右子树
    std::unique_ptr<AVLNode<T>> rightRotate(std::unique_ptr<AVLNode<T>> y) {
        auto x = std::move(y->left);
        auto T2 = std::move(x->right);

        x->right = std::move(y);
        x->right->left = std::move(T2);

        // 更新高度
        x->right->height = std::max(height(x->right->left), height(x->right->right)) + 1;
        x->height = std::max(height(x->left), height(x->right)) + 1;

        return x;
    }

    // 左旋转
    std::unique_ptr<AVLNode<T>> leftRotate(std::unique_ptr<AVLNode<T>> x) {
        auto y = std::move(x->right);
        auto T2 = std::move(y->left);

        y->left = std::move(x);
        y->left->right = std::move(T2);

        // 更新高度
        y->left->height = std::max(height(y->left->left), height(y->left->right)) + 1;
        y->height = std::max(height(y->left), height(y->right)) + 1;

        return y;
    }

    // 插入节点
    std::unique_ptr<AVLNode<T>> insert(std::unique_ptr<AVLNode<T>> node, T value) {
        // 1. 标准BST插入
        if (!node) {
            return std::make_unique<AVLNode<T>>(value);
        }

        if (value < node->data) {
            node->left = insert(std::move(node->left), value);
        } else if (value > node->data) {
            node->right = insert(std::move(node->right), value);
        } else {
            return node; // 不允许重复值
        }

        // 2. 更新高度
        node->height = 1 + std::max(height(node->left), height(node->right));

        // 3. 获取平衡因子
        int balance = getBalance(node);

        // 4. 如果不平衡,有4种情况

        // 左左情况
        if (balance > 1 && value < node->left->data) {
            return rightRotate(std::move(node));
        }

        // 右右情况
        if (balance < -1 && value > node->right->data) {
            return leftRotate(std::move(node));
        }

        // 左右情况
        if (balance > 1 && value > node->left->data) {
            node->left = leftRotate(std::move(node->left));
            return rightRotate(std::move(node));
        }

        // 右左情况
        if (balance < -1 && value < node->right->data) {
            node->right = rightRotate(std::move(node->right));
            return leftRotate(std::move(node));
        }

        return node;
    }

public:
    void insert(T value) {
        root = insert(std::move(root), value);
    }

    void inOrder() const {
        inOrder(root.get());
        std::cout << std::endl;
    }

private:
    void inOrder(AVLNode<T>* node) const {
        if (!node) return;
        inOrder(node->left.get());
        std::cout << node->data << " ";
        inOrder(node->right.get());
    }
};

// 使用示例
void demoAVLTree() {
    AVLTree<int> avl;
    avl.insert(10);
    avl.insert(20);
    avl.insert(30);
    avl.insert(40);
    avl.insert(50);
    avl.insert(25);

    std::cout << "AVL树中序遍历: ";
    avl.inOrder();  // 输出: 10 20 25 30 40 50
}
可以参考:https://blog.csdn.net/m0_66363962/article/details/130458502
右旋转:
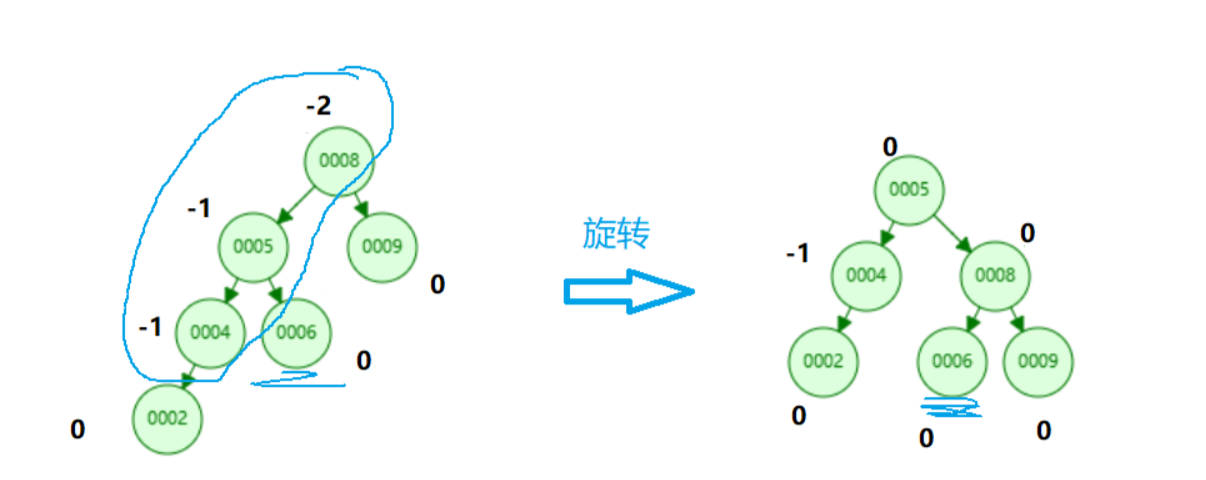
旋转操作的根本目的是维持树的平衡,防止BST退化成链表,保证操作的高效性。
- 右旋转 (Right Rotation)
适用情况:左左情况 (LL),当某个节点的左子树比右子树高,且左子树的左子树更高时:
旋转前结构:
        y (不平衡)
       / \
      x   C
     / \
    A   B
旋转后结构:
        x
       / \
      A   y
         / \
        B   C
- 左旋转 (Left Rotation)
适用情况:右右情况 (RR),当某个节点的右子树比左子树高,且右子树的右子树更高时:
旋转前结构:
    x (不平衡)
   / \
  A   y
     / \
    B   C
旋转后结构:
        y
       / \
      x   C
     / \
    A   B
- 左右旋转 (Left-Right Rotation)
适用情况:左右情况 (LR),先对左孩子左旋转,再对根节点右旋转:
Node* leftRightRotate(Node* z) {
    z->left = leftRotate(z->left);  // 先左旋转左孩子
    return rightRotate(z);          // 再右旋转根节点
}
- 右左旋转 (Right-Left Rotation)
适用情况:右左情况 (RL),先对右孩子右旋转,再对根节点左旋转:
Node* rightLeftRotate(Node* z) {
    z->right = rightRotate(z->right);  // 先右旋转右孩子
    return leftRotate(z);              // 再左旋转根节点
}
红黑树 (Red-Black Tree)
特征
近似平衡:不像AVL那样严格平衡,但能保证最长路径不超过最短路径的2倍
五个性质:
- 每个节点是红色或黑色
- 根节点是黑色
- 所有叶子节点(NIL)是黑色
- 红色节点的子节点必须是黑色(不能有连续的红色节点)
- 从任一节点到其每个叶子的所有路径包含相同数量的黑色节点
红色节点:红色节点表示"灵活"的节点;它们可以相对自由地移动和调整;但受到"不能有两个连续红色节点"的限制。
黑色节点:黑色节点表示"稳定"的节点;它们在树结构调整时相对固定; 负责维护黑色高度的平衡
高效操作:插入、删除最多需要3次旋转
enum class Color { RED, BLACK };

template<typename T>
struct RBNode {
    T data;
    Color color;
    std::unique_ptr<RBNode<T>> left;
    std::unique_ptr<RBNode<T>> right;
    RBNode<T>* parent;

    RBNode(T value, Color c = Color::RED)
        : data(value), color(c), left(nullptr), right(nullptr), parent(nullptr) {}
};

template<typename T>
class RedBlackTree {
private:
    std::unique_ptr<RBNode<T>> root;

    // 左旋
    void leftRotate(std::unique_ptr<RBNode<T>>&& x) {
        auto y = std::move(x->right);
        x->right = std::move(y->left);

        if (x->right) {
            x->right->parent = x.get();
        }

        y->parent = x->parent;

        if (!x->parent) {
            root = std::move(y);
        } else if (x.get() == x->parent->left.get()) {
            x->parent->left = std::move(y);
        } else {
            x->parent->right = std::move(y);
        }

        y->left = std::move(x);
        y->left->parent = y.get();
    }

    // 修复插入
    void fixInsert(RBNode<T>* node) {
        while (node != root.get() && node->parent->color == Color::RED) {
            if (node->parent == node->parent->parent->left.get()) {
                auto uncle = node->parent->parent->right.get();

                // Case 1: 叔叔是红色
                if (uncle && uncle->color == Color::RED) {
                    node->parent->color = Color::BLACK;
                    uncle->color = Color::BLACK;
                    node->parent->parent->color = Color::RED;
                    node = node->parent->parent;
                } else {
                    // Case 2: 节点是右孩子
                    if (node == node->parent->right.get()) {
                        node = node->parent;
                        leftRotate(std::move(node->parent->left));
                    }

                    // Case 3: 节点是左孩子
                    node->parent->color = Color::BLACK;
                    node->parent->parent->color = Color::RED;
                    // 这里需要实现右旋,类似左旋
                }
            } else {
                // 对称情况
                auto uncle = node->parent->parent->left.get();

                if (uncle && uncle->color == Color::RED) {
                    node->parent->color = Color::BLACK;
                    uncle->color = Color::BLACK;
                    node->parent->parent->color = Color::RED;
                    node = node->parent->parent;
                } else {
                    if (node == node->parent->left.get()) {
                        node = node->parent;
                        // 需要实现右旋
                    }

                    node->parent->color = Color::BLACK;
                    node->parent->parent->color = Color::RED;
                    leftRotate(std::move(node->parent->parent->right));
                }
            }
        }

        root->color = Color::BLACK;
    }

public:
    void insert(T value) {
        auto newNode = std::make_unique<RBNode<T>>(value);

        if (!root) {
            root = std::move(newNode);
            root->color = Color::BLACK;
            return;
        }

        RBNode<T>* current = root.get();
        RBNode<T>* parent = nullptr;

        // 标准BST插入
        while (current) {
            parent = current;
            if (value < current->data) {
                current = current->left.get();
            } else {
                current = current->right.get();
            }
        }

        newNode->parent = parent;
        if (value < parent->data) {
            parent->left = std::move(newNode);
            fixInsert(parent->left.get());
        } else {
            parent->right = std::move(newNode);
            fixInsert(parent->right.get());
        }
    }
};

// 使用示例
void demoRedBlackTree() {
    RedBlackTree<int> rbTree;
    rbTree.insert(10);
    rbTree.insert(20);
    rbTree.insert(30);
    rbTree.insert(15);
    rbTree.insert(25);

    // 红黑树的中序遍历也是有序的
}
普通二叉树:简单但不可靠,可能性能极差
AVL树:查找性能最优,适合读多写少的场景
红黑树:综合性能好,适合频繁插入删除的场景
this 指针
类和对象中的成员函数存储在公共的代码段,不同的对象调用成员函数时编译器为了知道具体操作的是哪一个对象给每个“非静态的成员函数”增加了一个隐藏的指针参数,让该指针指向当前对象,在函数体中所有成员变量的操作,都是通过这个指针来完成的,由编译器自动完成。
重载、重写、隐藏
**重载:**函数名相同,函数参数不同,两个函数在同一作用域
**重写:**两个函数分别在子类和父类中,函数名,返回值,参数均相同,函数必须为虚函数
**隐藏:**在继承关系中,子类实现了一个和父类名字名字一样的函数。这样子类的函数就把父类的同名函数隐藏了。隐藏只与函数名有关。
静态成员函数不可以是虚函数
静态成员函数不属于类中的任何一个对象或示例,属于类共有的一个函数,不依赖于对象调用,静态成员函数没有 this 指针,无法放进虚函数表。
构造函数不可以为虚函数
虚表指针是存储在 对象 的内存空间,当调虚函数时,是通过虚表指针指向的虚表里的函数地址进行调用的。如果将构造函数定义为虚函数,就要通过虚表指针指向的虚表的构造函数地址来调用。而构造函数是实例化对象,定义为虚函数后,对象空间还没有实例化,那就没有虚表指针,自然无法调用构造函数,那构造函数就失去意义,所以不能将构造函数定义为虚函数。
make_shared 函数的优点,缺点
优点:减少了内存分配的次数,降低了系统开销,提高了效率,使用new 构造的话至少会进行两次内存分配,(一次为智能指针本身,一次为共享指针的控制块)
缺点:当构造函数是保护或者私有的时候无法使用 make_shared 函数。
会导致 weak_ptr 保持控制块的生命周期,连带着保持了对象分配的内存,只有当最后一个 weak_ptr 离开作用域时,内存才会被释放,对于内存要求高的场景来说,是一个需要注意的问题。
93.函数调用进行的操作:
1.将参数压栈:按照参数顺序的逆序进行,如果参数中有对象则先进行拷贝构造
2.保存返回地址:即函数调用结束返回后接着执行的语句的地址
3.保护维护函数栈帧信息的寄存器内容如,SP(堆栈指针),FP(栈帧指针)等。
4.保存一些通用寄存器的内容:应为有些通用寄存器会被所有函数用到,所以在函数调用之前,这些寄存器就可能已经放置了对函数有用的信息。
5.调用函数,函数执行完毕
6.恢复通用寄存器的值7.恢复保存函数栈帧信息的那些寄存器的值
8.通过移动栈指针,销毁函数的栈帧
9.将保存的返回地址出栈,并赋给寄存器。
10.通过移动栈指针,回收传给函数的参数所占用的空间

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐


 21
 0
- 0


 已为社区贡献1条内容

所有评论(0)