Python 爬虫实战:58 同城商铺信息批量爬取(附完整代码 + 可视化解析)
·
引言
网络爬虫就像一个自动的小机器人,它可以根据我们给它的规则,自动地从互联网上抓取网页、图片、视频等内容。它的基本流程如下:
首先,它会像浏览器一样,发送一个请求给指定的网站服务器,请求服务器给它返回网页的数据。

目标与工具准备
- 爬取目标:获取58同城成都商铺出租转让第4页的基础信息(标题、区域、面积、租金)和详情页信息(转让费、联系人、二维码链接)。
- 依赖工具:
- Python库:
requests(发送HTTP请求)、BeautifulSoup(解析HTML)、pandas(数据存储)。 - 安装命令:
pip install requests beautifulsoup4 pandas openpyxl
- Python库:
分析网页
请求头构造
模拟浏览器访问需设置请求头,关键字段包括:
- User-Agent:标识浏览器类型(如Chrome)。
- Cookie:从浏览器开发者工具的Network标签中复制(需登录状态)。
import requests
from bs4 import BeautifulSoup

URL = 'https://cd.58.com/shangpucz/0/pn4/?skuInserted=0&FGTID=109397958221330411064287535&maxInserted=27&gposLastIndex=88&zzvipInserted=0'
headers = {
    'user-agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/114.0.0.0 Safari/537.36 Edg/114.0.1823.67',
    'cookie': 'f=n; id58=CkwANGkoWfBebjKeCu4AAg==; wmda_uuid=46fcd9de7a42c1345c1c26763b2d9dc1; wmda_new_uuid=1; wmda_session_id_29317198571852=1764252144048-fe9da707-b2fb-48ad-befb-9c41593d4e8b; wmda_visited_projects=%3B29317198571852; wmda_session_id=1764252144130-5b68f4ab-d1e1-4565-8b26-ccee502f4d78; 58tj_uuid=380c661c-2aa7-43cc-8a86-83ddb6ecf9e1; new_uv=1; xxzlclientid=08c8d85b-4f4a-47fa-ac5c-1764252144462; als=0; xxzlxxid=pfmxiw0B2t+gimcGgzt4n/oWWVSAG6aKjfXw/wBnNbIJTuFSIPg7ioW+g38hUABHbEIC; utm_source=zhaopin_B; www58com="UserID=116429460129353&UserName=ambu4hugh"; 58cooper="userid=116429460129353&username=ambu4hugh"; 58uname=ambu4hugh; passportAccount="atype=0&bstate=0"; new_session=0; wmda_report_times=40; spm=u-2gn98rpfn988mb62t1.2gn99heh13vhwqfjjkg; 58home=nc; f=n; commontopbar_new_city_info=669%7C%E5%8D%97%E6%98%8C%7Cnc; city=nc; commontopbar_ipcity=nc%7C%E5%8D%97%E6%98%8C%7C0; init_refer=https%253A%252F%252Fwww.so.com%252Flink%253Fm%253DeOmptoAMqVCMapI8fmIxrYPH%25252BH89dOrTmgBYBzQkYG9Wh4AwymZD1uxCKbvBFj5VjHPw0J93oBsT6cyLck%25252FKOUUMOWgkf8lXl0nCb1WKx6p%25252BaAwGgkXhJ%25252Fw%25253D%25253D; PPU=UID=116429460129353&UN=ambu4hugh&TT=0607959b2a1610a211b47a872eaa4729&PBODY=Ett-_jvIXly5Oi0Aif1CQiBpLeaKUCUXm8RfBBrq_bpq1kWUQ-8u7vA_xVzYPA0pXFzNPseUK9tSHsHn9nMG706LGcFknesfg5PVbvl1XHRGyi7i4GV1DCSMys-SVMz8YzwqW0_2Oj-fk6-bRYL5sOEFCOavBeKJMxEbdi-eZew&VER=1&CUID=Rai0Bv0vso1BsNZPMtzPww; fzq_h=30a4c67081e204b3bab466b5c1e857bc_1764252215942_a052a03fe3144d2fa748436a589c13c2_1867122615; JSESSIONID=918AD181FC8A99E665D3577E42C4D604; xxzlbbid=pfmbM3wxMDI5OXwxLjExLjB8MTc2NDI1MjIyMDI4NDY0MDk4MHx0OEorT3VOSzRncWN6ekViS3JJdXVUQU9NT1pacGlxVFZzaDlVN05kMVhrPXx8'
}

发送请求与解析HTML
发送GET请求并解析返回的HTML内容:
res = requests.get(URL, headers=headers)
html = BeautifulSoup(res.content, 'html.parser')
print(html)  # 验证是否成功获取

提取基础信息
打开 58 同城商铺页面 → F12 打开开发者工具 → 点击 “元素选择器”(左上角箭头),
点击任意商铺标题 → 右侧会高亮对应的 HTML 标签:可看到标题在span标签中,class="title_des"
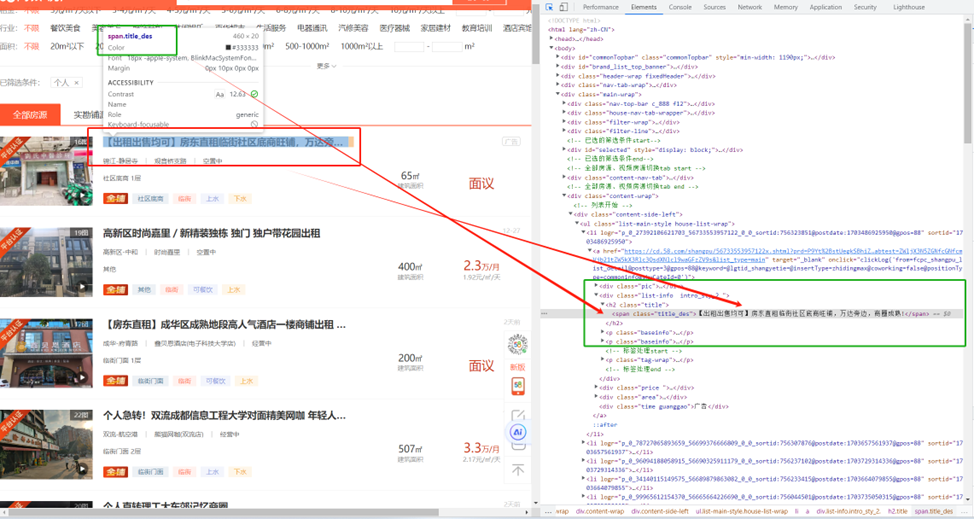
通过开发者工具定位元素标签和类名,提取数据:
- 商铺标题:
<span class="title_des"> - 区域/地址:
<span class="withi"> - 面积:
<p class="num"> - 租金:
<span class="num">

title_des = html.find_all('span', class_="title_des")
withi = html.find_all('span', class_="withi")
squa = html.find_all('p', class_='num')
price = html.find_all('span', class_='num')

titles = [ti.text for ti in title_des]
area_address = [wi.text for wi in withi]
areas = [item for index, item in enumerate(area_address) if index%2==0]
addresses = [item for index, item in enumerate(area_address) if index%2!=0]
square = [sq.text.replace('\n','') for sq in squa]

import re
rent = []
for pr in price:
    pri = pr.text.replace('\n','')
    match = re.search(r'(\d+(\.\d+)?)', pri)
    if match:
        pri = pri.replace(match.group(), f'{match.group()}万/月')
    rent.append(pri)
提取详情页信息
-
获取详情页链接:
商铺条目通常包裹在li标签中,详情页入口是li内的a标签(href属性为链接)links = [] li_list = html.find_all('li') for li in li_list: a_tag = li.find('a') if a_tag: links.append(a_tag['href']) links = [link for link in links if len(link)>=200] # 过滤无效链接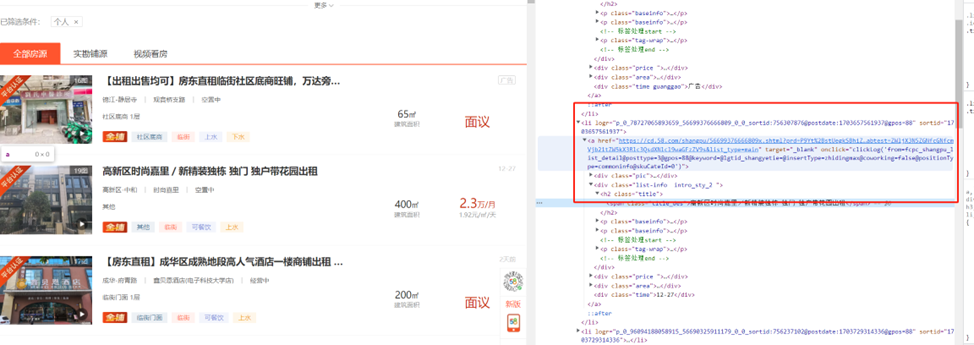
-
爬取详情页数据:
遍历链接,请求详情页并提取转让费、联系人、二维码链接:fee, names, tels = [], [], [] for lin in links[:3]: # 测试前3个链接 resp = requests.get(lin, headers=headers) detail_html = BeautifulSoup(resp.content, 'html.parser') transfer_fee = detail_html.find('span', class_="house_basic_title_money_num_second") contact_name = detail_html.find_all('span', class_="name-text") qr_code = detail_html.find('img', class_="qr") names.extend([na.text for na in contact_name][1::2]) # 去重取奇数位 tels.append(qr_code.get('src') if qr_code else None) fee_text = transfer_fee.text.replace('\n','').replace(' ','') if transfer_fee else '-' fee.append(fee_text.replace('转让费:','') if '转让费' in fee_text else '-')
数据清洗与存储
- 转让费格式化:处理“面议”或缺失值。
- 存储为Excel(需
pandas):import pandas as pd data = { '标题': titles, '区域': areas, '面积': square, '租金': rent, '转让费': fee[:len(titles)], # 对齐数据长度 '联系人': names[:len(titles)], '联系方式': tels[:len(titles)] } df = pd.DataFrame(data) df.to_excel('58同城商铺数据.xlsx', index=False)
完整代码
# -*- coding: utf-8 -*-  # 设置Python文件编码为UTF-8,支持中文显示
import requests  # 用于发送HTTP请求,获取网页内容
from bs4 import BeautifulSoup  # 用于解析HTML网页结构,提取目标数据
import pandas as pd  # (预留:可用于后续将数据整理为表格)
import re  # 用于正则表达式匹配,处理租金等文本格式
import openpyxl  # (预留:可用于后续将数据写入Excel)

# 目标爬取链接:58同城成都商铺出租转让第4页的页面地址
URL = 'https://cd.58.com/shangpucz/0/pn4/?skuInserted=0&FGTID=109397958221330411064287535&maxInserted=27&gposLastIndex=88&zzvipInserted=0'

# 构造请求头:模拟浏览器访问,避免被网站反爬
# User-Agent:标识浏览器类型;Cookie:模拟用户登录状态(从浏览器开发者工具中复制)
headers = {
    'user-agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/114.0.0.0 Safari/537.36 Edg/114.0.1823.67',
    'cookie': 'f=n; id58=CkwANGkoWfBebjKeCu4AAg==; wmda_uuid=46fcd9de7a42c1345c1c26763b2d9dc1; wmda_new_uuid=1; wmda_session_id_29317198571852=1764252144048-fe9da707-b2fb-48ad-befb-9c41593d4e8b; wmda_visited_projects=%3B29317198571852; wmda_session_id=1764252144130-5b68f4ab-d1e1-4565-8b26-ccee502f4d78; 58tj_uuid=380c661c-2aa7-43cc-8a86-83ddb6ecf9e1; new_uv=1; xxzlclientid=08c8d85b-4f4a-47fa-ac5c-1764252144462; als=0; xxzlxxid=pfmxiw0B2t+gimcGgzt4n/oWWVSAG6aKjfXw/wBnNbIJTuFSIPg7ioW+g38hUABHbEIC; utm_source=zhaopin_B; www58com="UserID=116429460129353&UserName=ambu4hugh"; 58cooper="userid=116429460129353&username=ambu4hugh"; 58uname=ambu4hugh; passportAccount="atype=0&bstate=0"; new_session=0; wmda_report_times=40; spm=u-2gn98rpfn988mb62t1.2gn99heh13vhwqfjjkg; 58home=nc; f=n; commontopbar_new_city_info=669%7C%E5%8D%97%E6%98%8C%7Cnc; city=nc; commontopbar_ipcity=nc%7C%E5%8D%97%E6%98%8C%7C0; init_refer=https%253A%252F%252Fwww.so.com%252Flink%253Fm%253DeOmptoAMqVCMapI8fmIxrYPH%25252BH89dOrTmgBYBzQkYG9Wh4AwymZD1uxCKbvBFj5VjHPw0J93oBsT6cyLck%25252FKOUUMOWgkf8lXl0nCb1WKx6p%25252BaAwGgkXhJ%25252Fw%25253D%25253D; PPU=UID=116429460129353&UN=ambu4hugh&TT=0607959b2a1610a211b47a872eaa4729&PBODY=Ett-_jvIXly5Oi0Aif1CQiBpLeaKUCUXm8RfBBrq_bpq1kWUQ-8u7vA_xVzYPA0pXFzNPseUK9tSHsHn9nMG706LGcFknesfg5PVbvl1XHRGyi7i4GV1DCSMys-SVMz8YzwqW0_2Oj-fk6-bRYL5sOEFCOavBeKJMxEbdi-eZew&VER=1&CUID=Rai0Bv0vso1BsNZPMtzPww; fzq_h=30a4c67081e204b3bab466b5c1e857bc_1764252215942_a052a03fe3144d2fa748436a589c13c2_1867122615; JSESSIONID=918AD181FC8A99E665D3577E42C4D604; xxzlbbid=pfmbM3wxMDI5OXwxLjExLjB8MTc2NDI1MjIyMDI4NDY0MDk4MHx0OEorT3VOSzRncWN6ekViS3JJdXVUQU9NT1pacGlxVFZzaDlVN05kMVhrPXx8',
}
# 发送GET请求,获取目标页面的响应内容
res = requests.get(URL, headers=headers)
# 使用BeautifulSoup解析HTML内容(解析器为html.parser)
html = BeautifulSoup(res.content, 'html.parser')

# 定位页面元素(对应图片中的解析步骤)
title_des = html.find_all('span', class_="title_des")  # 商铺标题元素(class="title_des"的span标签)
withi = html.find_all('span', class_="withi")  # 区域/地址元素(class="withi"的span标签)
squa = html.find_all('p', class_='num')  # 商铺面积元素(class="num"的p标签)
price = html.find_all('span', class_='num')  # 租金元素(class="num"的span标签)

# 初始化列表,用于存储爬取到的数据
titles = []  # 存储商铺标题
area_address_list = []  # 临时存储区域+地址(后续拆分)
square = []  # 存储商铺面积
rent = []  # 存储租金
links = []  # 存储商铺详情页链接

# 提取商铺标题:遍历title_des元素,将文本存入titles列表
for ti in title_des:
    title = ti.text  # 获取标签内的纯文本
    titles.append(title)

# 提取区域/地址:遍历withi元素,将文本存入area_address_list列表
for wi in withi:
    addr = wi.text  # 获取区域/地址文本
    area_address_list.append(addr)

# 提取商铺面积:遍历squa元素,去除换行符后存入square列表
for sq in squa:
    squar = sq.text.replace('\n', '')  # 去除文本中的换行符
    square.append(squar)

# 提取租金并格式化:遍历price元素,添加"万/月"单位
for pr in price:
    pri = pr.text.replace('\n', '')  # 去除换行符
    # 正则匹配租金中的数字部分
    match = re.search(r'(\d+(\.\d+)?)', pri)
    if match:
        number = match.group() + '万/月'  # 给数字添加单位
        pri = pri.replace(match.group(), number)
    rent.append(pri)

# 打印基础数据,验证爬取结果
print(titles)
print(len(titles))
print(area_address_list)
# 将area_address_list拆分为areas(区域,索引为偶数)和addresses(地址,索引为奇数)
areas = [item for index, item in enumerate(area_address_list) if index % 2 == 0]
addresses = [item for index, item in enumerate(area_address_list) if index % 2 != 0]
print(areas)
print(len(areas))
print(addresses)
print(len(addresses))
print(square)
print(len(square))
print(rent)
print(len(rent))

# 提取商铺详情页链接(对应图片中的链接提取步骤)
li_list = html.find_all('li')  # 查找所有li标签(商铺条目容器)
for li in li_list:
    a_tag = li.find('a')  # 在li标签内查找a标签(详情页入口)
    if a_tag:
        link = a_tag['href']  # 获取a标签的href属性(详情页链接)
        links.append(link)
# 过滤链接:只保留长度≥200的有效详情页链接(排除无效短链接)
links = [link for link in links if len(link) >= 200]
print(links)
print(len(links))

# 初始化详情页数据存储列表
fee = []  # 存储转让费
names = []  # 存储联系人
tels = []  # 存储联系方式(二维码链接)

# 构造详情页的请求头(模拟浏览器访问详情页)
header = {
    'user-agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/114.0.0.0 Safari/537.36 Edg/114.0.1823.67',
    'cookie': 'f=n; id58=CkwANGkoWfBebjKeCu4AAg==; wmda_uuid=46fcd9de7a42c1345c1c26763b2d9dc1; wmda_new_uuid=1; wmda_session_id_29317198571852=1764252144048-fe9da707-b2fb-48ad-befb-9c41593d4e8b; wmda_visited_projects=%3B29317198571852; wmda_session_id=1764252144130-5b68f4ab-d1e1-4565-8b26-ccee502f4d78; 58tj_uuid=380c661c-2aa7-43cc-8a86-83ddb6ecf9e1; new_uv=1; xxzlclientid=08c8d85b-4f4a-47fa-ac5c-1764252144462; als=0; xxzlxxid=pfmxiw0B2t+gimcGgzt4n/oWWVSAG6aKjfXw/wBnNbIJTuFSIPg7ioW+g38hUABHbEIC; utm_source=zhaopin_B; www58com="UserID=116429460129353&UserName=ambu4hugh"; 58cooper="userid=116429460129353&username=ambu4hugh"; 58uname=ambu4hugh; passportAccount="atype=0&bstate=0"; new_session=0; wmda_report_times=40; spm=u-2gn98rpfn988mb62t1.2gn99heh13vhwqfjjkg; 58home=nc; f=n; commontopbar_new_city_info=669%7C%E5%8D%97%E6%98%8C%7Cnc; city=nc; commontopbar_ipcity=nc%7C%E5%8D%97%E6%98%8C%7C0; init_refer=https%253A%252F%252Fwww.so.com%252Flink%253Fm%253DeOmptoAMqVCMapI8fmIxrYPH%25252BH89dOrTmgBYBzQkYG9Wh4AwymZD1uxCKbvBFj5VjHPw0J93oBsT6cyLck%25252FKOUUMOWgkf8lXl0nCb1WKx6p%25252BaAwGgkXhJ%25252Fw%25253D%25253D; PPU=UID=116429460129353&UN=ambu4hugh&TT=0607959b2a1610a211b47a872eaa4729&PBODY=Ett-_jvIXly5Oi0Aif1CQiBpLeaKUCUXm8RfBBrq_bpq1kWUQ-8u7vA_xVzYPA0pXFzNPseUK9tSHsHn9nMG706LGcFknesfg5PVbvl1XHRGyi7i4GV1DCSMys-SVMz8YzwqW0_2Oj-fk6-bRYL5sOEFCOavBeKJMxEbdi-eZew&VER=1&CUID=Rai0Bv0vso1BsNZPMtzPww; fzq_h=30a4c67081e204b3bab466b5c1e857bc_1764252215942_a052a03fe3144d2fa748436a589c13c2_1867122615; JSESSIONID=918AD181FC8A99E665D3577E42C4D604; xxzlbbid=pfmbM3wxMDI5OXwxLjExLjB8MTc2NDI1MjIyMDI4NDY0MDk4MHx0OEorT3VOSzRncWN6ekViS3JJdXVUQU9NT1pacGlxVFZzaDlVN05kMVhrPXx8'
}
# 遍历详情页链接,爬取转让费、联系人、联系方式
for lin in links:
    resp = requests.get(lin, headers=header)  # 发送请求获取详情页内容
    HTML = BeautifulSoup(resp.content, 'html.parser')  # 解析详情页HTML

    # 定位详情页元素
    house_basic = HTML.find_all('span', class_="house_basic_title_money_num_second")  # 转让费元素
    nam = HTML.find_all('span', class_="name-text")  # 联系人元素
    contact = HTML.find_all('img', class_="qr")  # 联系方式(二维码)元素

    # 提取联系人信息
    for na in nam:
        name = na.text
        names.append(name)
    new_names = names[1::2]  # 过滤重复联系人(取奇数位元素)

    # 提取二维码链接(联系方式)
    for con in contact:
        tel = con.get('src')  # 获取img标签的src属性(二维码图片链接)
        tels.append(tel)

    # 处理转让费信息(编码转换避免乱码)
    encoded_basic = house_basic[0].text.encode('utf-8')
    fe = []
    fe.append(encoded_basic.decode('utf-8').replace('\n', '').replace('\xa0', '').replace(' ', ''))
    fee.append(str(fe).encode('gbk', errors='ignore').decode('gbk'))
    print(str(fe).encode('gbk', errors='ignore').decode('gbk'))

# 清洗转让费数据:格式化显示
output = [elem.strip("['']").strip('"') for elem in fee]
out = []
for ele in output:
    if '转让费' in ele:
        if ele == '转让费:面议(转让费可面议)' or ele == '转让费:面议(费用可面议)':
            out.append('面议')
        else:
            ele = ele.replace('转让费:', '')
            ele = ele.replace('转让费:', '')
            out.append(ele)
    else:
        out.append('-')

# 打印详情页数据,验证结果
print(fee)
print(output)
print(out)
print(len(out))
print(new_names)  # 去重后的联系人列表
print(len(new_names))
print(tels)  # 联系方式(二维码链接)列表
print(len(tels))


#华丽转身的程序喵
#https://m.tb.cn/h.SxeNlci?tk=ubC5fNmxP5x
总结
本文通过 “请求→解析→提取→深入爬取” 的流程,实现了 58 同城商铺信息的批量获取。核心是用开发者工具定位元素 + BeautifulSoup 解析 HTML,掌握这个逻辑后,可轻松扩展到其他网站的爬虫开发~
如果对你有帮助,欢迎点赞 + 收藏!有问题可以在评论区交流~
注意事项
- 反爬机制:频繁请求可能触发验证码,建议设置请求间隔(如
time.sleep(2))。 - 动态内容:若数据为动态加载(如JavaScript渲染),需改用
Selenium或分析API接口。 - 合法性:遵守网站
robots.txt规则,避免高频访问。
通过以上步骤,可完整实现58同城商铺数据的批量爬取与存储。

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐

 33
 0
- 0


 已为社区贡献2条内容

所有评论(0)