【DeepSeek-模型解读】MLA原理
作者:昇腾实战派
DeepSeek知识地图:https://blog.csdn.net/weixin_45216014/article/details/156450562?spm=1011.2415.3001.5331
1. 传统的多头注意力机制
首先回顾一下标准的多头注意力机制(Multi-Head Attention,MHA),在标准的多头注意力机制下,首先需要根据隐状态 h t h_t ht分别计算计算 q t q_t qt、 k t k_t kt、 v t v_t vt(注意这里都是列向量):
q t = W Q h t q_t=W^Qh_t qt=WQht
k t = W K h t k_t=W^Kh_t kt=WKht
v t = W V h t v_t=W^Vh_t vt=WVht
其中,
h
t
∈
R
d
h_t\in\R^d
ht∈Rd是attention层第t个token对应的输入,
d
d
d是embedding的维度;
q
t
,
k
t
,
v
t
∈
R
d
h
n
h
q_t, k_t, v_t \in\R^{d_hn_h}
qt,kt,vt∈Rdhnh,
d
h
d_h
dh和
n
h
n_h
nh分别表示每个头的维度(head dim)和头数(head num);
𝑊
𝑄
,
𝑊
𝐾
,
𝑊
𝑉
∈
R
𝑑
h
𝑛
h
×
d
𝑊^𝑄 ,𝑊^𝐾 ,𝑊^𝑉 \in R^{𝑑_ℎ𝑛_ℎ\times d}
WQ,WK,WV∈Rdhnh×d。
然后
q
t
,
k
t
,
v
t
q_t, k_t, v_t
qt,kt,vt会被切分成
n
h
n_h
nh个头来进行多头注意力的计算:
[ q t , 1 ; q t , 2 ; . . . ; q t , n h ] = q t , [q_{t, 1}; q_{t, 2}; ... ; q_{t, n_h}] = q_t , [qt,1;qt,2;...;qt,nh]=qt,
[ k t , 1 ; k t , 2 ; . . . ; k t , n h ] = k t , [k_{t, 1}; k_{t, 2}; ... ; k_{t, n_h}] = k_t , [kt,1;kt,2;...;kt,nh]=kt,
[ v t , 1 ; v t , 2 ; . . . ; v t , n h ] = v t , [v_{t, 1}; v_{t, 2}; ... ; v_{t, n_h}] = v_t , [vt,1;vt,2;...;vt,nh]=vt,
o t , i = ∑ j = 1 t S o f t m a x j ( q t , i T k j , i d h ) v j , i , o_{t, i}=\sum_{j=1}^{t} Softmax_j(\frac{q_{t, i}^Tk_{j, i}}{\sqrt{d_h}})v_{j, i}, ot,i=j=1∑tSoftmaxj(dhqt,iTkj,i)vj,i,
u t = W O [ o t , 1 ; o t , 2 ; . . . ; o t , n h ] , u_t=W^O[o_{t, 1}; o_{t, 2}; ... ;o_{t, n_h}], ut=WO[ot,1;ot,2;...;ot,nh],
其中, q t , i , k t , i , v t , i ∈ R d h q_{t,i}, k_{t,i}, v_{t,i} \in\R^{d_h} qt,i,kt,i,vt,i∈Rdh表示第i个attention头的query、key和value, W O ∈ R d × d h n h W^O\in\R^{d\times d_hn_h} WO∈Rd×dhnh表示输出的映射矩阵。
在推理的时候由于存在KVCache,所有的key和value都需要被缓存,所以传统的多头注意力机制对于每一个token都需要缓存 2 n h d h l 2n_hd_hl 2nhdhl个元素, l l l表示模型的层数。在模型的部署阶段KV cache带来的显存压力是一个限制序列长度和batchsize的巨大瓶颈。
2. 推理时的KV cache
这一节简单介绍KV cache的原理。在推理阶段,最朴素的方法是每次推理把输出的最后一个token拼接到prompt的末尾作为下次推理的输入。然后用拼接之后的句子再次调用前向推理,我们可以循环调用多次推理直至结束。图2.1给出了这个过程的示意。
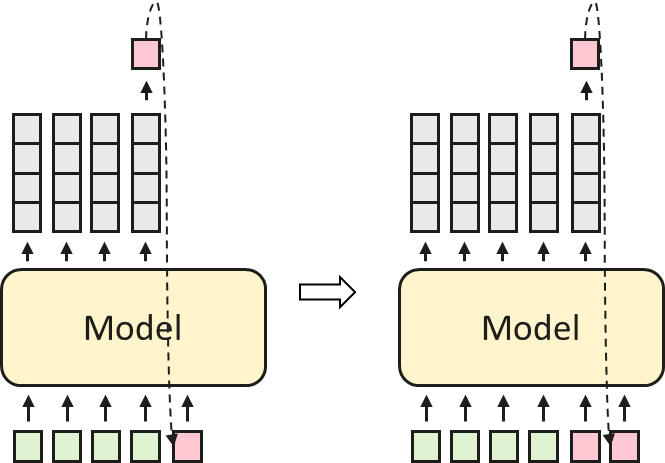
- 第一步:
对于起始输入的prompt X = { x 0 } X=\{x_0\} X={x0},分别经过 W Q W^Q WQ、 W K W^K WK和 W V W^V WV的矩阵运算,获得 Q = { W Q x 0 } = { q 0 } Q=\{W^Qx_0\}=\{q_0\} Q={WQx0}={q0}, K = { W K x 0 } = { k 0 } K=\{W^Kx_0\}=\{k_0\} K={WKx0}={k0}, V = { W V x 0 } = { v 0 } V=\{W^Vx_0\}=\{v_0\} V={WVx0}={v0},接着进行attention计算, o 0 = s o f t m a x ( q 0 T k 0 D ) v 0 o_0=softmax(\frac{q_0^Tk_0}{\sqrt{D}})v_0 o0=softmax(Dq0Tk0)v0,然后计算输出, u t = W O o 0 u_t=W_Oo_0 ut=WOo0,最后对 u t u_t ut进行采样我们就获得了 x 1 x_1 x1。 - 第二步:
我们把 x 1 x_1 x1拼接在prompt最后面,prompt变成了 X = { x 0 , x 1 } X=\{x_0 , x_1\} X={x0,x1},分别经过 W Q W^Q WQ、 W K W^K WK和 W V W^V WV的矩阵运算,获得 Q = { W Q x 0 , W Q x 1 } = { q 0 , q 1 } Q=\{W^Qx_0, W^Qx_1\}=\{q_0, q_1\} Q={WQx0,WQx1}={q0,q1}, K = { W K x 0 , W K x 1 } = { k 0 , k 1 } K=\{W^Kx_0, W^Kx_1\}=\{k_0, k_1\} K={WKx0,WKx1}={k0,k1}, V = { W V x 0 , W V x 1 } = { v 0 , v 1 } V=\{W^Vx_0, W^Vx_1\}=\{v_0, v_1\} V={WVx0,WVx1}={v0,v1},接着进行attention计算, o 0 o_0 o0的计算和前一步一模一样, o 1 = s o f t m a x ( [ q 1 T k 0 D ; q 1 T k 1 D ] ) [ v 0 v 1 ] o_1=softmax(\begin{bmatrix} \frac{q_1^Tk_0}{\sqrt{D}}; \frac{q_1^Tk_1}{\sqrt{D}} \end{bmatrix}) \begin{bmatrix}v_0\\ v_1 \end{bmatrix} o1=softmax([Dq1Tk0;Dq1Tk1])[v0v1]。
图2.2给出了两步的简单示意图,忽略了一些计算细节。
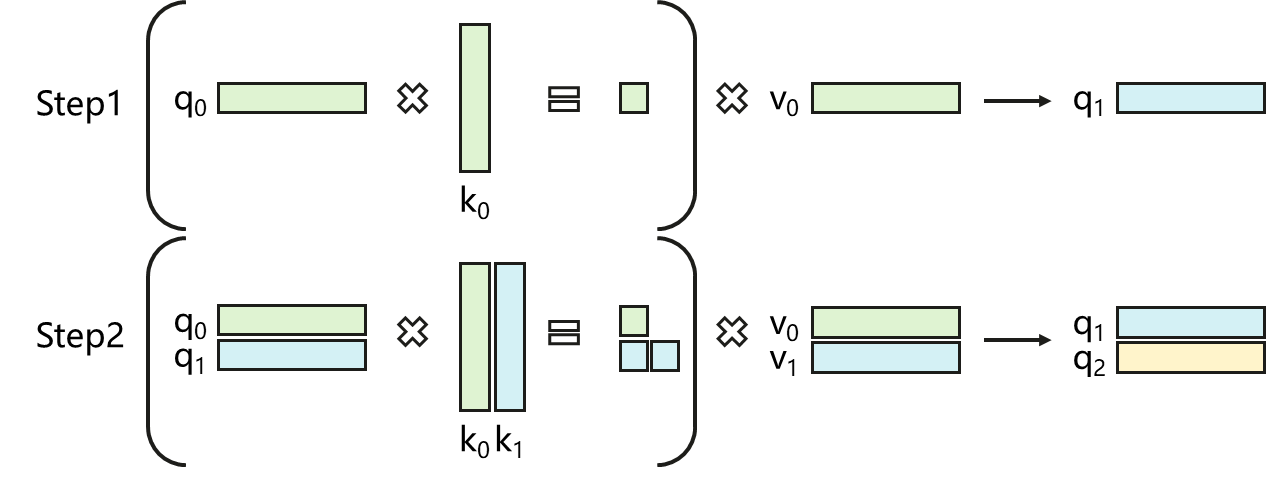
到这里我们可以发现在第二步计算 o 1 o_1 o1的时候与 o 0 o_0 o0完全没有关系,而且只依赖于 k 0 k_0 k0、 k 1 k_1 k1、 q 0 q_0 q0、 q 1 q_1 q1,而 k 0 k_0 k0和 q 0 q_0 q0的结果在第一步已经计算过,没有必要重复计算。因此,KV cache的思想就是把每一步计算得到的 k t k_t kt和 v t v_t vt缓存下来,供下一步使用,避免重复计算。有了KV cache之后,我们的计算步骤就变成了图2.3这样,其中虚线表示缓存的KV cache。
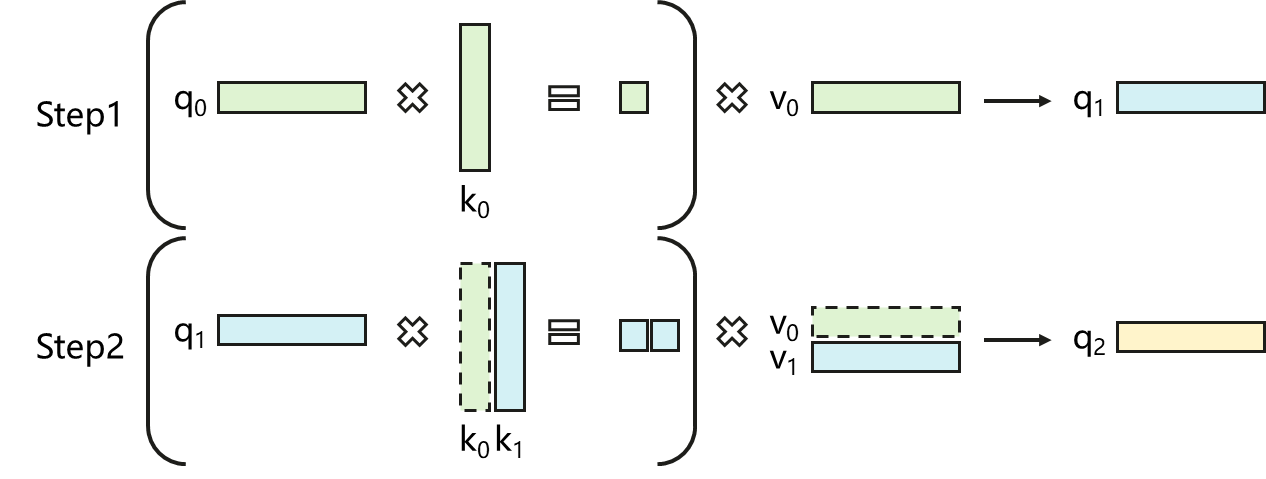
最后每个token的 k t k_t kt和 v t v_t vt的维度都是 n h d h n_hd_h nhdh,模型总共有 l l l层,因此每个token都需要缓存 2 n h d h l 2n_hd_hl 2nhdhl个元素。这会造成缓存的压力,所以引出了MLA这个方法。
3. 低秩的key-value联合压缩
3.1 QKV的低秩压缩
Multi-head Latent Attention(MLA)的核心是对Key和Value进行低秩联合压缩以减少KV cache:
c t K V = W D K V h t , c_t^{KV}=W^{DKV}h_t , ctKV=WDKVht,
k t C = W U K c t K V , k_t^C=W^{UK}c_t^{KV} , ktC=WUKctKV,
v t C = W U V c t K V , v_t^C=W^{UV}c_t^{KV} , vtC=WUVctKV,
其中 c t K V ∈ R d c c_t^{KV}\in\R^{d_c} ctKV∈Rdc表示key和value压缩之后的隐向量; d c ( ≪ d h n h ) d_c(\ll d_hn_h) dc(≪dhnh)表示KV压缩之后的维度; W D K V ∈ R d c × d W^{DKV}\in\R^{d_c\times d} WDKV∈Rdc×d表示下采样压缩矩阵,即将 h t h_t ht的维度从 d d d压缩到 d c d_c dc; W U K , W U V ∈ R d h n h × d c W^{UK}, W^{UV}\in\R^{d_hn_h\times d_c} WUK,WUV∈Rdhnh×dc是key和value的上采样矩阵,它们将 c t K V c_t^{KV} ctKV的维度从 d c d_c dc恢复到 d h n h d_hn_h dhnh,即恢复成多头注意力中相同的key和value。恢复之后的key和value可以继续进行attention计算。这么做的目的可以使MLA在推理的时候只需要缓存 c t K V c_t^{KV} ctKV,因此它的KV cache只有 d c l d_cl dcl个元素,大大少于MHA。
此外,在推理时,由于 W U K W^UK WUK可以吸收到 W Q W^Q WQ中, W U V W^UV WUV可以吸收到 W O W^O WO中,我们在计算attention时甚至不需要单独计算出key和value。
除了压缩key和value,为了减少训练时的激活量,MLA对query也做了低秩压缩,即便它无法减少KV cache:
c t Q = W D Q h t , c_t^{Q}=W^{DQ}h_t , ctQ=WDQht,
q t C = W U Q c t Q , q_t^C=W^{UQ}c_t^{Q} , qtC=WUQctQ,
其中 c t Q ∈ R d c ′ c_t^Q\in\R^{d_c'} ctQ∈Rdc′是query压缩后的向量; d c ′ ( ≪ d h n h ) d_c'(\ll d_hn_h) dc′(≪dhnh)表示query压缩之后的维度; W D Q ∈ R d c ′ × d W^{DQ}\in\R^{d_c'\times d} WDQ∈Rdc′×d和 W U Q ∈ R d h n h × d c ′ W^{UQ}\in\R^{d_hn_h \times d_c'} WUQ∈Rdhnh×dc′表示下采样和上采样矩阵,和KV是类似的。
3.2 无位置编码的Attention计算推导
在引入了低秩压缩之后,attention的计算也随之改变,接下来我们先在不考虑位置编码的条件下对新的attention计算进行推导。
首先由 h t h_t ht获得query的压缩向量 c t Q c_t^{Q} ctQ
c t Q = W D Q h t , c_t^{Q}=W^{DQ}h_t , ctQ=WDQht,
然后由 c t Q c_t^{Q} ctQ上采样获得真正的query q t C q_t^C qtC,里面包含了所有的query头
[ q t , 1 C ; q t , 2 C ; . . . ; q t , n h C ] = q t C = W U Q c t Q , [q_{t, 1}^C; q_{t, 2}^C; ... ; q_{t, n_h}^C] = q_t^C=W^{UQ}c_t^{Q} , [qt,1C;qt,2C;...;qt,nhC]=qtC=WUQctQ,
以同样的方式获得key和value,需要注意的是,k和v共用一个压缩向量 c t K V c_t^{KV} ctKV,但使用不同的上采样矩阵
c t K V = W D K V h t , c_t^{KV}=W^{DKV}h_t , ctKV=WDKVht,
[ k t , 1 C ; k t , 2 C ; . . . ; k t , n h C ] = k t C = W U K c t K V , [k_{t, 1}^C; k_{t, 2}^C; ... ; k_{t, n_h}^C] =k_t^C=W^{UK}c_t^{KV} , [kt,1C;kt,2C;...;kt,nhC]=ktC=WUKctKV,
[ v t , 1 C ; v t , 2 C ; . . . ; v t , n h C ] = v t C = W U V c t K V , [v_{t, 1}^C; v_{t, 2}^C; ... ; v_{t, n_h}^C] =v_t^C=W^{UV}c_t^{KV} , [vt,1C;vt,2C;...;vt,nhC]=vtC=WUVctKV,
接下来,计算q和k相关性,即attention分数,我们以 q i C q_i^C qiC和 k j C k_j^C kjC为例:
( q i C ) T k j C = ( W U Q c i Q ) T W U K c j K V = ( c i Q ) T ( W U Q ) T W U K c j K V (q_i^C)^T k_j^C=(W^{UQ}c_i^Q)^T W^{UK}c_j^{KV}=(c_i^Q)^T (W^{UQ})^TW^{UK}c_j^{KV} (qiC)TkjC=(WUQciQ)TWUKcjKV=(ciQ)T(WUQ)TWUKcjKV
到这一步我们可以发现,如果推理阶段,计算 q i C q_i^C qiC和 k j C k_j^C kjC的相关性时甚至不需要提前计算出并存储 k j C k_j^C kjC,只需要有 c j K V c_j^{KV} cjKV就可以了。因为推理时 ( W U Q ) T (W^{UQ})^T (WUQ)T和 W U K W^{UK} WUK是已知的,我们只需要按照上面的式子从左往右计算,就可以避免计算出key本身,减少激活显存。在DeepSeek-V2原文中提到了矩阵的“吸收”,即 W U K W^{UK} WUK不再是先用来和 c j K V c_j^{KV} cjKV计算出key,而是和 ( W U Q ) T (W^{UQ})^T (WUQ)T先计算,它被 ( W U Q ) T (W^{UQ})^T (WUQ)T“吸收”了,此外还有一种方式是直接把两个矩阵合并为一个,因为推理的时候权重是已知的。这就是为什么MLA可以只缓存 c t K V c_t^{KV} ctKV的原因。
最后我们来推导输出 u t u_t ut:
u t = W O o t , = W O ∑ j = 1 t S o f t m a x j ( q t T k j d h ) W U V c j K V , = W O ( a t 1 W U V c 1 K V + a t 2 W U V c 2 K V + , . . . , + a t t W U V c t K V ) , = W O W U V ( a t 1 c 1 K V + a t 2 c 2 K V + , . . . , + a t t c t K V ) = W O W U V ∑ j = 1 t S o f t m a x j ( q t T k j d h ) c j K V , = W O U V ∑ j = 1 t S o f t m a x j ( q t T k j d h ) c j K V u_t=W^Oo_t ,\\ =W^O\sum _{j=1}^t Softmax_j(\frac{q_{t}^Tk_{j}}{\sqrt{d_h}})W^{UV}c_j^{KV},\\ =W^O(a_{t1}W^{UV}c_1^{KV}+a_{t2}W^{UV}c_2^{KV}+, ... , +a_{tt}W^{UV}c_t^{KV}), \\ =W^OW^{UV}(a_{t1}c_1^{KV}+a_{t2}c_2^{KV}+, ... , +a_{tt}c_t^{KV}) \\ =W^OW^{UV}\sum _{j=1}^t Softmax_j(\frac{q_{t}^Tk_{j}}{\sqrt{d_h}})c_j^{KV}, \\ =W^{OUV}\sum _{j=1}^t Softmax_j(\frac{q_{t}^Tk_{j}}{\sqrt{d_h}})c_j^{KV} ut=WOot,=WOj=1∑tSoftmaxj(dhqtTkj)WUVcjKV,=WO(at1WUVc1KV+at2WUVc2KV+,...,+attWUVctKV),=WOWUV(at1c1KV+at2c2KV+,...,+attctKV)=WOWUVj=1∑tSoftmaxj(dhqtTkj)cjKV,=WOUVj=1∑tSoftmaxj(dhqtTkj)cjKV
这里 a t j a_{tj} atj表示 q t q_{t} qt和 k j k_{j} kj的注意力分数,方便起见这里我们保持 q t T k j q_{t}^T k_{j} qtTkj为原样不做展开,注意 o t o_t ot中包含了多个头。我们可以发现在计算输出的时候同样不需要计算出并存储 v j v_j vj,只需要 c j K V c_j^{KV} cjKV就够了,因为 W U V W^{UV} WUV也可以被 W O W^O WO吸收。
至此,基本解释了为什么推理时可以只存储 c j K V c_j^{KV} cjKV。
4. 解耦位置编码
目前的推导还没有引入位置编码,因此我们先尝试加入位置编码看看。位置编码同样可以表示成矩阵乘法,我们用 R t k t C R_tk_t^C RtktC表示对 k t C k_t^C ktC应用位置编码,然后我们来尝试计算query和key的相关性。
( q i C ) T R j k j C = ( W U Q c i Q ) T R j W U K c j K V = ( c i Q ) T ( W U Q ) T R j W U K c j K V (q_i^C)^T R_j k_j^C=(W^{UQ}c_i^Q)^T R_j W^{UK}c_j^{KV}=(c_i^Q)^T (W^{UQ})^TR_jW^{UK}c_j^{KV} (qiC)TRjkjC=(WUQciQ)TRjWUKcjKV=(ciQ)T(WUQ)TRjWUKcjKV
从公式中可以看出如果我们对 k j C k_j^C kjC应用位置编码,则公式中 W U K W^{UK} WUK将与位置敏感的RoPE矩阵耦合。由于当前生成token相关的RoPE矩阵将位于 W U Q W^{UQ} WUQ和 W U K W^{UK} WUK之间,而RoPE矩阵是位置敏感的,即不同的序列位置t拥有不同的RoPE矩阵,又因为矩阵乘法不服从交换律,因此, W U K W^{UK} WUK在推理时无法再被吸收到 W U Q W^{UQ} WUQ中,就是说 W U K W^{UK} WUK、RoPE矩阵和 W U Q W^{UQ} WUQ无法合并成一个矩阵。这意味着导致在推理过程中,我们必须对所有前缀token重新计算key,这将极大地影响推理效率。
为此,MLA解耦了位置编码,用额外的query头 q t , i R ∈ R d h R q_{t, i}^R\in\R^{d_h^R} qt,iR∈RdhR和共享的key头 k t R ∈ R d h R k_t^R\in\R^{d_h^R} ktR∈RdhR来携带位置编码(其实可以理解成向量中的一部分维度携带位置编码),这里 d h R d_h^R dhR表示query和key中携带位置编码的每个头的维度。
解耦了位置编码之后,MLA的计算就变成了下面的过程:
首先通过 W Q R c t Q W^{QR}c_t^{Q} WQRctQ生成出query中携带位置编码的部分,并计算位置编码
[ q t , 1 R ; q t , 2 R ; . . . ; q t , n h R ] = q t R = R o P E ( W Q R c t Q ) , [q_{t, 1}^R; q_{t, 2}^R; ... ; q_{t, n_h}^R] = q_t^R=RoPE(W^{QR}c_t^{Q}) , [qt,1R;qt,2R;...;qt,nhR]=qtR=RoPE(WQRctQ),
同样计算出key携带位置编码的部分
k t R = R o P E ( W K R h t ) , k_t^R=RoPE(W^{KR}h_t), ktR=RoPE(WKRht),
与不带位置编码的部分进行拼接,获得真正的query和key
q t , i = [ q t , i C ; q t , i R ] , q_{t, i}=[q_{t, i}^C; q_{t, i}^R], qt,i=[qt,iC;qt,iR],
k t , i = [ k t , i C ; k t R ] , k_{t, i}=[k_{t, i}^C; k_t^R], kt,i=[kt,iC;ktR],
进行attention计算和输出的计算
o t , i = ∑ j = 1 t S o f t m a x j ( q t , i T k j , i d h + d h R ) v j , i C , o_{t, i}=\sum _{j=1}^t Softmax_j(\frac{q_{t, i}^Tk_{j, i}}{\sqrt{d_h+d_h^R}})v_{j, i}^{C}, ot,i=j=1∑tSoftmaxj(dh+dhRqt,iTkj,i)vj,iC,
u t = W O [ o t , 1 ; o t , 2 ; . . . ; o t , n h ] u_t=W^O[o_{t, 1}; o_{t, 2}; ... ; o_{t, n_h}] ut=WO[ot,1;ot,2;...;ot,nh]
这里 W Q R ∈ R d h R n h × d c ′ W^{QR}\in\R^{d_h^Rn_h \times d_c'} WQR∈RdhRnh×dc′, W K R ∈ R d h R × d W^{KR}\in\R^{d_h^R \times d} WKR∈RdhR×d,这两个矩阵分别用来生成query和key中携带位置编码的部分。 W Q R W^{QR} WQR将 c t Q c_t^{Q} ctQ的维度从 d c ′ d_c' dc′映射到 d h R n h d_h^Rn_h dhRnh,而 W K R W^{KR} WKR直接从 h t h_t ht生成key携带旋转位置编码的部分。RoPE(.)表示使用位置编码,即乘上矩阵 R R R;[. ; .]表示拼接。**所以所谓的解耦其实就单独生成一块带位置编码的部分,然后拼接到不带位置编码的部分上。**可以发现query是每个头 q t , i q_{t, i} qt,i都会有不同的携带位置编码的向量 q t , i R q_{t, i}^R qt,iR,而key的所有头 k t , i k_{t, i} kt,i共用同一个向量 k t R k_t^R ktR。在推理时,携带位置编码的这部分 k t R k_t^R ktR也需要被缓存。
这里我们再解释一下为什么解耦了位置编码,就不再影响矩阵的吸收了。有了位置编码以后 q t , i T k j , i q_{t, i}^Tk_{j, i} qt,iTkj,i的计算变成了 [ q t , i C ; q t , i R ] [q_{t, i}^C; q_{t, i}^R] [qt,iC;qt,iR]和 [ k t , i C ; k t R ] [k_{t, i}^C; k_t^R] [kt,iC;ktR]的相乘,其结果等价于 q t , i C k t , i C + q t , i R k t R q_{t, i}^Ck_{t, i}^C+q_{t, i}^Rk_t^R qt,iCkt,iC+qt,iRktR,而 q t , i C k t , i C q_{t, i}^Ck_{t, i}^C qt,iCkt,iC就是前文分析的不带位置编码的相关性计算。
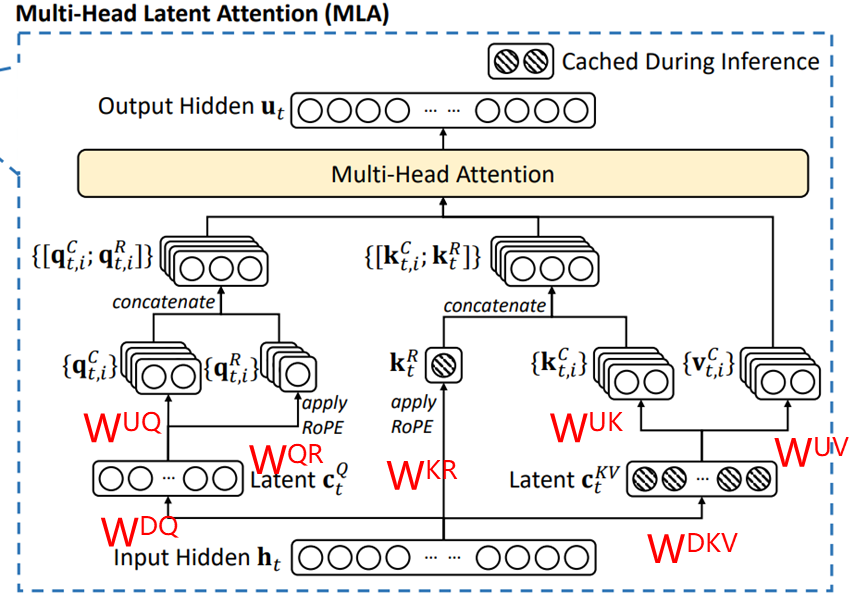
到此我们就可以引出完整的计算过程了,图中蓝色的部分是推理时需要被缓存的
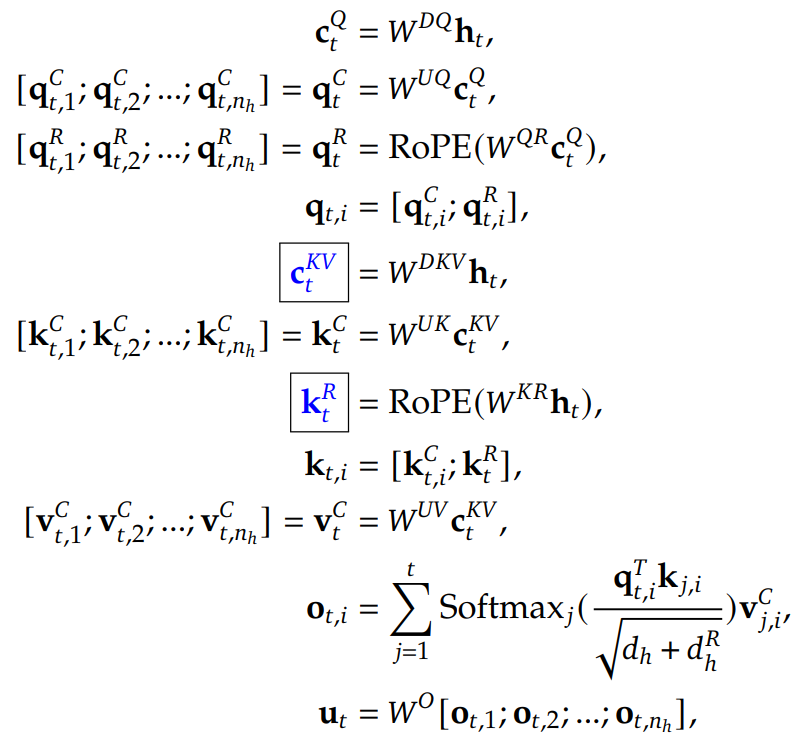
最后,结合论文中的图可以更直观的理解其过程,图中标出了公式中各个矩阵乘法的位置。
Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐
 12
 0
- 0


 已为社区贡献3条内容

所有评论(0)