ADK LLMAgent 中 ReAct 循环的实现
1. Agent 接口设计
在深入代码之前,我们先来思考一个哲学问题:智能体的本质是什么?在 ADK 中,智能体不是一个神秘的黑盒子。它的本质非常简单:智能体是一个能够接收上下文、执行逻辑、并产生事件序列的组件。
这个定义包含三个关键要素。第一,智能体需要接收上下文,这意味着它必须知道当前的状态、用户输入、可用工具等信息。第二,智能体需要执行逻辑,它根据上下文做出决策并执行相应的操作。第三,智能体需要产生事件,它将执行结果以事件的形式输出给调用方。
这三个要素在 ADK 中对应三个核心概念。InvocationContext 作为调用上下文负责传递状态信息,Run() 方法承载执行逻辑,而 iter.Seq2[*session.Event, error] 则作为事件序列的载体。
理解这个本质,是理解 ADK 智能体实现的关键。
1.1 Agent 接口定义
让我们从 Agent 接口开始。这是所有智能体的基础:
// Agent 接口定义了所有智能体必须实现的方法
type Agent interface {
    // Name 返回智能体的名称,用于唯一标识
    Name() string
    // Description 返回智能体的描述,LLM 用它来决定是否委托任务
    Description() string
    // Run 执行智能体逻辑,返回一个事件序列的迭代器
    Run(InvocationContext) iter.Seq2[*session.Event, error]
    // SubAgents 返回所有子智能体的列表
    SubAgents() []Agent
    // FindAgent 在智能体树中递归查找指定名称的智能体
    FindAgent(name string) Agent
    // FindSubAgent 仅查找直接子节点中的智能体
    FindSubAgent(name string) Agent
    // internal 返回内部实现,供框架内部使用,不暴露给用户
    internal() *agent
}
1.2 接口方法解析
Agent 接口的每个方法都承担着特定的设计意图。Name() 方法返回智能体的唯一标识名称,这个名称用于智能体之间的路由、日志记录以及跨智能体转移时的目标指定。Description() 方法返回智能体的功能描述,这个描述非常关键——LLM 在决定是否将控制权转移给某个智能体时,会参考这个描述来判断该智能体是否适合处理当前任务。
Run() 方法是智能体的核心执行逻辑,它接收一个 InvocationContext 并返回一个事件迭代器。Go 1.22 引入的 iter.Seq2 模式使得智能体可以按需产生事件,而不是一次性返回所有结果。这种惰性求值的设计非常适合流式响应场景。SubAgents() 方法返回当前智能体的所有子智能体列表,这支持了多智能体架构中的层次化设计。FindAgent() 和 FindSubAgent() 方法则提供了在智能体树中查找的能力,前者进行递归搜索,后者只在直接子节点中搜索。
internal() 方法是一个特殊的设计模式。它返回 *agent 指针,允许框架内部代码访问智能体的底层实现细节,而不需要将这些细节暴露给普通用户。这种封装技巧在 Go 的接口设计中很常见——用户通过接口与智能体交互,而框架代码可以通过未导出的内部方法获取额外的访问能力。
2. 上下文层次结构
ADK 定义了三层上下文接口,形成一个层次结构。通过三种上下文类型实现不同的访问权限。
2.1 ReadonlyContext:只读上下文
ReadonlyContext 是最基础的上下文接口,提供只读访问:
// ReadonlyContext 接口提供对会话信息的只读访问
type ReadonlyContext interface {
    // 嵌入标准 Go context,支持超时和取消
    context.Context
    // UserContent 返回用户输入的内容
    UserContent() *genai.Content
    // InvocationID 返回当前调用的唯一标识
    InvocationID() string
    // AgentName 返回当前智能体名称
    AgentName() string
    // ReadonlyState 返回只读的状态对象
    ReadonlyState() session.ReadonlyState
    // UserID 返回用户 ID
    UserID() string
    // AppName 返回应用名称
    AppName() string
    // SessionID 返回会话 ID
    SessionID() string
    // Branch 返回当前分支路径
    Branch() string
}
ReadonlyContext 的设计体现了最小权限原则——它只为调用者提供必要的读取能力,不允许修改任何状态。这在需要验证或检查会话信息但不应该修改状态的场景中非常有用。例如,工具的声明部分可能需要访问会话信息来生成文档,但不应该修改状态。
2.2 CallbackContext:回调上下文
CallbackContext 继承自 ReadonlyContext,增加了修改状态的能力:
// CallbackContext 接口继承只读上下文,增加状态修改能力
type CallbackContext interface {
    // 嵌入只读上下文
    ReadonlyContext
    // Artifacts 返回制品管理器,用于文件上传/下载
    Artifacts() Artifacts
    // State 返回可读写的会话状态
    State() session.State
}
回调函数使用这个上下文,可以读取和修改状态。其关键特性是 State() 方法返回的是一个代理对象,它优先读取本次变更(StateDelta),其次读取原始状态。
2.3 InvocationContext:调用上下文
InvocationContext 是最完整的上下文:
// InvocationContext 接口提供完整的访问权限,是最顶层的上下文
type InvocationContext interface {
    // 嵌入标准 Go context
    context.Context
    // Agent 返回当前执行的智能体
    Agent() Agent
    // Artifacts 返回制品管理器
    Artifacts() Artifacts
    // Memory 返回跨会话记忆检索器
    Memory() Memory
    // Session 返回当前会话对象
    Session() session.Session
    // InvocationID 返回当前调用的唯一标识
    InvocationID() string
    // Branch 返回当前分支路径
    Branch() string
    // UserContent 返回用户输入内容
    UserContent() *genai.Content
    // RunConfig 返回运行配置
    RunConfig() *RunConfig
    // EndInvocation 提前结束当前调用
    EndInvocation()
    // Ended 检查调用是否已结束
    Ended() bool
    // WithContext 创建一个新的 InvocationContext,替换底层 context.Context
    WithContext(ctx context.Context) InvocationContext
}
InvocationContext 之所以是最完整的上下文类型,是因为它需要支持智能体的各种操作需求。当智能体执行时,它可能需要访问当前正在运行的智能体实例(Agent()),也可能需要管理会话中的制品文件(Artifacts()),或者需要跨会话检索记忆(Memory())。Session() 方法提供了对当前会话的完整访问,包括会话的状态和事件历史。
InvocationID() 和 Branch() 方法支持多智能体场景下的调用追踪。InvocationID() 标识了一次完整的用户请求调用,而 Branch() 则用于并行智能体场景中的事件隔离。UserContent() 直接提供用户输入的内容,而不需要从会话事件中提取。RunConfig() 返回的运行配置可以控制流式模式等运行时行为。
EndInvocation() 和 Ended() 方法提供了对调用生命周期的控制。如果智能体需要提前终止整个调用流程(比如检测到某个条件时),可以调用 EndInvocation()。Ended() 方法则允许检查调用是否已经被结束,避免执行不必要的逻辑。
2.4 RunConfig:运行配置
RunConfig 控制智能体执行的运行时行为:
// RunConfig 控制智能体执行的运行时行为
type RunConfig struct {
    // StreamingMode 控制流式模式
    StreamingMode StreamingMode
    // SaveInputBlobsAsArtifacts 是否将用户输入中的二进制数据保存为制品
    SaveInputBlobsAsArtifacts bool
}

// StreamingMode 定义流式模式类型
type StreamingMode string

const (
    // StreamingModeNone 表示非流式模式
    StreamingModeNone StreamingMode = "none"
    // StreamingModeSSE 表示服务端事件流模式
    StreamingModeSSE  StreamingMode = "sse"
)
StreamingMode 控制流式输出模式,取值可以是 none(非流式)或 sse(Server-Sent Events 服务端事件流)。在非流式模式下,智能体等所有结果生成完毕后一次性返回;在 SSE 模式下,智能体会通过事件流逐个推送中间结果,客户端可以实时显示。SaveInputBlobsAsArtifacts 控制是否将用户输入中的二进制数据(如图像、文件)保存为制品。当这个选项为 true 时,用户上传的图片或文件会被自动保存到制品服务中,后续可以通过工具加载使用。
2.5 三层上下文继承关系
ADK 的三层上下文接口在 Go 语言层面形成了清晰的层次结构。ReadonlyContext 直接嵌入 context.Context,提供最基础的只读访问能力。CallbackContext 通过嵌入 ReadonlyContext 扩展了状态修改和制品管理的能力,这意味着所有实现 CallbackContext 的类型也自动满足 ReadonlyContext 接口。InvocationContext 则是独立的设计——它直接嵌入 context.Context 而非 CallbackContext,但它提供了最完整的访问权限,包括当前智能体实例、会话对象、记忆检索器以及调用生命周期控制方法。三种上下文在功能上形成递进关系,但在 Go 的类型系统中,只有 CallbackContext 和 ReadonlyContext 之间存在显式的嵌入关系。
2.6 上下文的使用场景
不同类型的上下文适用于不同的场景,选择正确的上下文类型可以提高代码的安全性和可维护性。InvocationContext 是最高级别的上下文,它提供完整的读写权限,主要用于 Runner 和 Agent.Run() 方法中——这些组件需要协调所有智能体的执行、管理会话状态、以及控制调用生命周期。
CallbackContext 适用于工具执行和回调函数。在这些场景中,代码需要能够修改会话状态(比如记录工具的执行结果),但不应该控制整个调用的生命周期。CallbackContext 的一个关键特性是 State() 方法返回的是一个代理对象,它优先读取本次变更(StateDelta),其次才读取原始状态。这种设计确保了多个回调之间的状态变更不会冲突。
ReadonlyContext 则适用于工具声明和只读操作的场景。工具的声明部分可能需要访问会话信息来生成更准确的描述,但不应该修改任何状态。使用 ReadonlyContext 可以通过编译时检查来确保这些代码不会意外修改状态。
3. 基础智能体实现
3.1 agent 结构体
agent 结构体是 Agent 接口的基础实现:
// agent 结构体是 Agent 接口的基础实现,是所有智能体类型的共同基类
type agent struct {
    // 嵌入内部状态,包含类型、配置等
    agentinternal.State
    // name 是智能体的唯一标识名称
    name, description string
    // subAgents 是子智能体列表
    subAgents         []Agent
    // beforeAgentCallbacks 是前置回调列表,在核心逻辑运行前执行
    beforeAgentCallbacks []BeforeAgentCallback
    // run 是核心执行函数,由具体智能体类型注入
    run                  func(InvocationContext) iter.Seq2[*session.Event, error]
    // afterAgentCallbacks 是后置回调列表,在核心逻辑运行后执行
    afterAgentCallbacks  []AfterAgentCallback
}
3.2 核心字段解析
agent 结构体的字段设计体现了组合优于继承的原则。State 字段组合了内部状态,包含智能体的类型信息和配置数据,这是所有智能体共享的基础设施。name 和 description 字段存储智能体的标识信息,用于路由、日志和 LLM 的转移决策。subAgents 字段是一个切片,存储当前智能体的所有子智能体,这支持了多智能体的层次化架构。
beforeAgentCallbacks 和 afterAgentCallbacks 字段分别存储前置回调和后置回调列表。回调机制是 ADK 扩展性的核心——通过在智能体执行的关键点插入自定义逻辑,开发者可以实现日志记录、性能监控、访问控制等功能。这种设计比继承更灵活,因为可以在运行时动态添加或移除回调。
run 字段是核心执行函数的函数指针,由具体的智能体类型(如 llmAgent)在创建时注入。这种设计使得 agent 结构体成为一个通用的容器,它负责处理回调机制和生命周期管理,而具体的执行逻辑由注入的函数提供。
3.3 Run 方法的实现
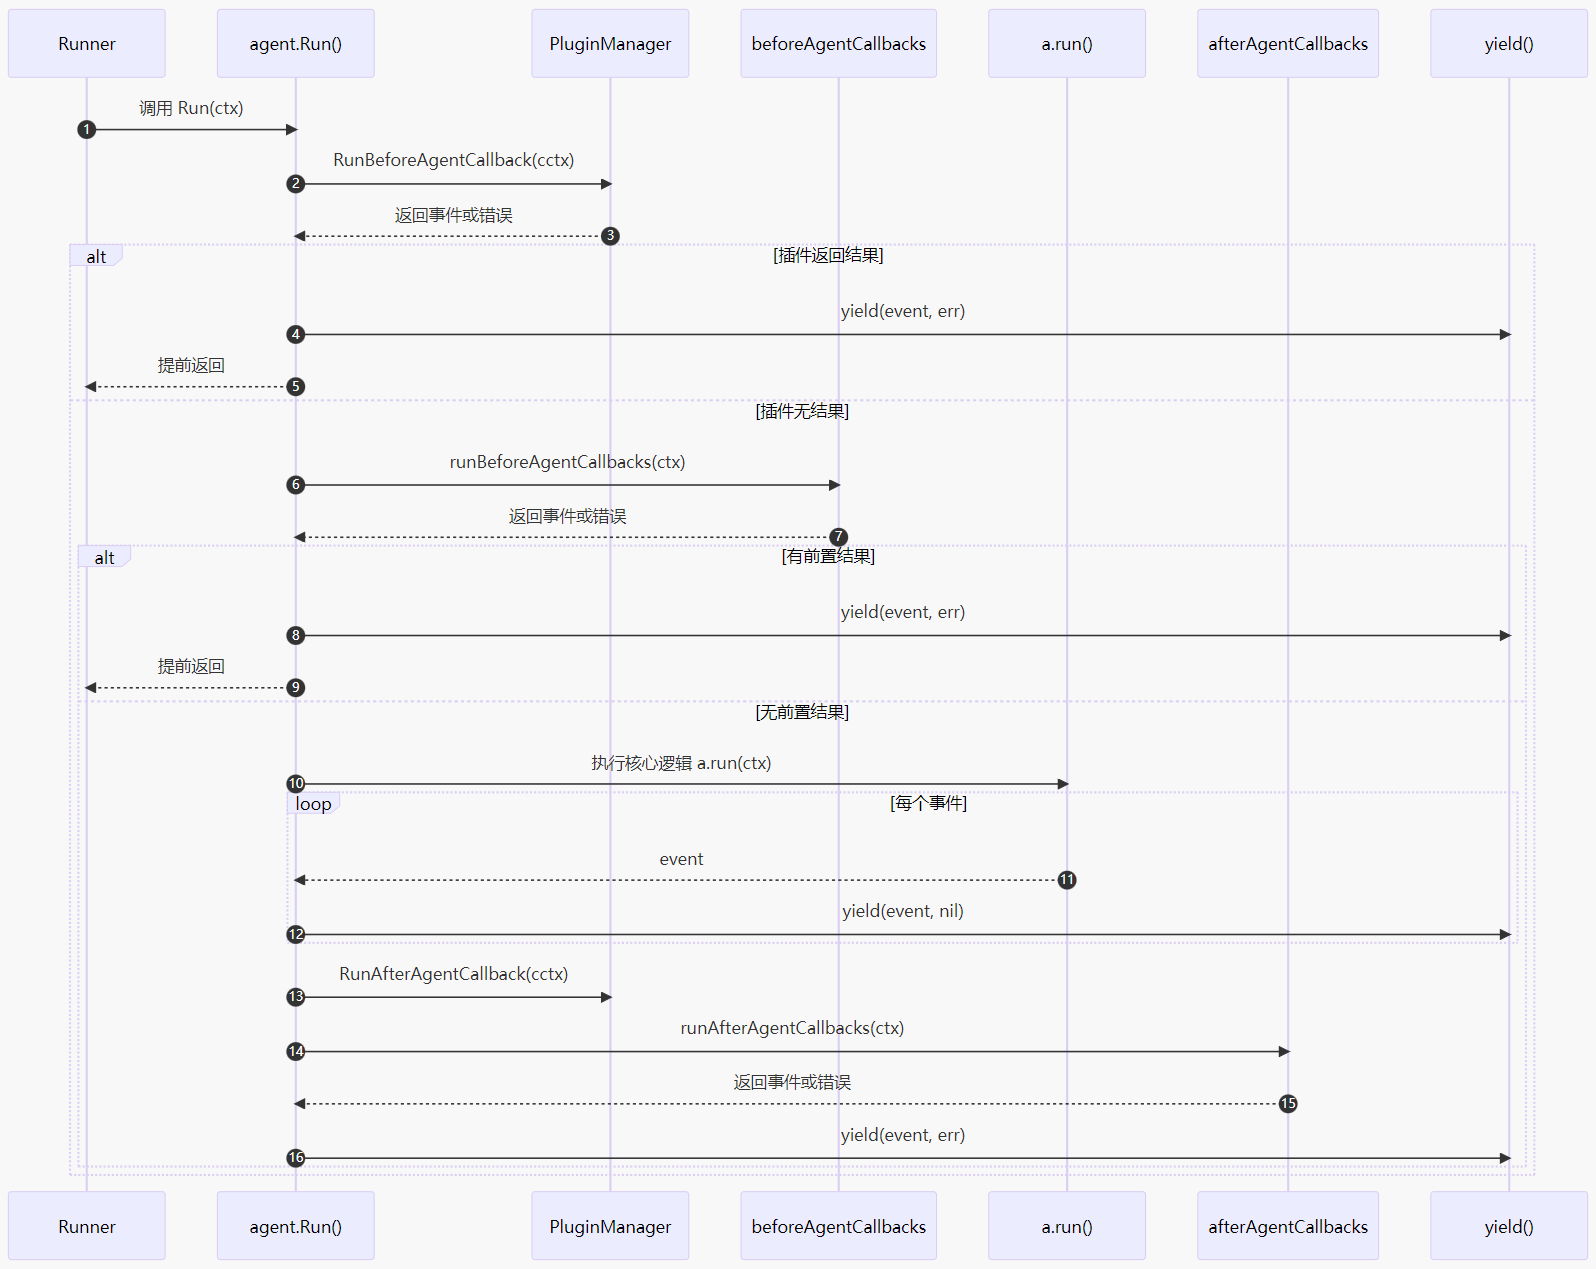
agent.Run() 方法的实现非常清晰:
// Run 方法执行智能体的完整生命周期:前置回调 -> 核心逻辑 -> 后置回调
func (a *agent) Run(ctx InvocationContext) iter.Seq2[*session.Event, error] {
    // 返回一个迭代器函数,由调用方通过 for-range 遍历事件
    return func(yield func(*session.Event, error) bool) {
        // 启动遥测 span,记录智能体调用
        spanCtx, span := telemetry.StartInvokeAgentSpan(ctx, a, ctx.Session().ID(), ctx.InvocationID())
        // 包装 yield 函数,添加遥测支持
        yield, endSpan := telemetry.WrapYield(span, yield, ...)
        // 确保 span 在函数结束时关闭
        defer endSpan()
        // 创建新的 invocationContext 副本
        ctx := &invocationContext{...}
        // 执行前置回调
        event, err := runBeforeAgentCallbacks(ctx)
        // 如果前置回调返回了事件或错误,直接产出并返回
        if event != nil || err != nil {
            yield(event, err)
            return
        }
        // 如果上下文未被结束,执行核心逻辑
        if !ctx.Ended() {
            // 遍历核心执行函数产生的事件
            for event, err := range a.run(ctx) {
                // 如果事件没有设置作者,自动填充
                if event.Author == "" {
                    event.Author = getAuthorForEvent(ctx, event)
                }
                // 产出事件,如果调用方停止接收则返回
                if !yield(event, err) {
                    return
                }
            }
        }
        // 如果上下文未被结束,执行后置回调
        if !ctx.Ended() {
            event, err = runAfterAgentCallbacks(ctx)
            // 如果后置回调返回了事件或错误,产出
            if event != nil || err != nil {
                yield(event, err)
            }
        }
    }
}
3.4 执行流程时序图
3.5 回调机制
回调机制是 ADK 的一个重要特性。它允许在智能体执行的前后注入逻辑。
// BeforeAgentCallback 是前置回调函数类型,在智能体执行前调用
type BeforeAgentCallback func(CallbackContext) (*genai.Content, error)
// AfterAgentCallback 是后置回调函数类型,在智能体执行后调用
type AfterAgentCallback func(CallbackContext) (*genai.Content, error)
回调的作用体现在两个方面。前置回调可以检查条件、修改上下文、甚至提前返回结果。如果任何一个前置回调返回非 nil 的结果,智能体的核心逻辑会被跳过,这是一种短路机制。这在需要验证前置条件、记录日志、或在特定条件下跳过执行时非常有用。后置回调则可以处理结果、清理资源、添加额外逻辑,比如在智能体完成后发送通知或更新外部状态。
4. LLMAgent 配置与创建
LLMAgent 是 ADK 中最常用的智能体类型。它基于大语言模型,实现了 ReAct 循环。
4.1 LLMAgent 的配置
创建 LLMAgent 需要丰富的配置:
// Config 是 LLMAgent 的配置结构体,包含所有可配置的选项
type Config struct {
    // Name 是智能体的唯一标识,不能为 "user"
    Name        string
    // Description 是智能体的功能描述,LLM 用它决定是否委托
    Description string
    // SubAgents 是子智能体列表
    SubAgents   []agent.Agent
    // BeforeAgentCallbacks 是前置回调列表
    BeforeAgentCallbacks []agent.BeforeAgentCallback
    // AfterAgentCallbacks 是后置回调列表
    AfterAgentCallbacks  []agent.AfterAgentCallback
    // Model 是底层的 LLM 模型实例
    Model                 model.LLM
    // GenerateContentConfig 是生成内容的配置
    GenerateContentConfig *genai.GenerateContentConfig
    // BeforeModelCallbacks 是调用模型前的回调列表
    BeforeModelCallbacks  []BeforeModelCallback
    // AfterModelCallbacks 是调用模型后的回调列表
    AfterModelCallbacks   []AfterModelCallback
    // OnModelErrorCallbacks 是模型调用出错时的回调列表
    OnModelErrorCallbacks []OnModelErrorCallback
    // Instruction 是指导智能体行为的静态指令,支持 {var} 模板变量
    Instruction                 string
    // InstructionProvider 是动态指令提供者函数
    InstructionProvider         InstructionProvider
    // GlobalInstruction 是全局静态指令,只在根智能体上生效
    GlobalInstruction           string
    // GlobalInstructionProvider 是全局动态指令提供者
    GlobalInstructionProvider   InstructionProvider
    // Tools 是智能体可以直接使用的工具列表
    Tools        []tool.Tool
    // Toolsets 是工具集列表,动态提供工具
    Toolsets     []tool.Toolset
    // BeforeToolCallbacks 是工具调用前的回调列表
    BeforeToolCallbacks []BeforeToolCallback
    // AfterToolCallbacks 是工具调用后的回调列表
    AfterToolCallbacks  []AfterToolCallback
    // OnToolErrorCallbacks 是工具调用出错时的回调列表
    OnToolErrorCallbacks []OnToolErrorCallback
    // DisallowTransferToParent 是否禁止转移到父智能体
    DisallowTransferToParent bool
    // DisallowTransferToPeers 是否禁止转移到同级智能体
    DisallowTransferToPeers  bool
    // IncludeContents 控制对话历史的包含方式
    IncludeContents          IncludeContents
    // InputSchema 是输入数据结构的 Schema 定义
    InputSchema              *genai.Schema
    // OutputSchema 是输出数据结构的 Schema 定义
    OutputSchema             *genai.Schema
    // OutputKey 指定保存智能体输出的状态键
    OutputKey                string
}
4.2 关键配置项详解
LLMAgent 的配置设计非常丰富,涵盖了智能体行为的各个方面。Name 和 Description 是智能体的身份标识,其中名称必须在智能体树中唯一,且不能是 "user" 这个保留值。描述信息对于 LLM 的转移决策至关重要——当 LLM 需要决定是否将任务委托给某个子智能体时,它会参考这个描述来判断该智能体是否具备处理当前任务的能力。
Model 配置指定了底层的 LLM 模型实例,这是智能体进行推理的核心组件。Instruction 是静态指令,用于指导智能体的行为,它支持 {var} 语法来引用会话状态中的变量。GlobalInstruction 是全局指令,只在根智能体上设置时生效,它会影响所有子智能体的行为,这为共享的系统级指令提供了一个统一的配置点。
Tools 和 Toolsets 配置定义了智能体可以使用的工具集合。Tools 是直接的工具列表,而 Toolsets 是工具集的列表,支持延迟加载和动态工具提供。IncludeContents 控制对话历史的包含方式,设为 "none" 时只包含当前轮次的内容,适用于不需要历史上下文的纯功能性智能体。
OutputKey 配置指定了一个状态键,智能体的最终输出会自动保存到这个键下,方便下游智能体通过状态引用获取结果。DisallowTransferToParent 和 DisallowTransferToPeers 提供对智能体转移范围的控制,在某些场景下可能需要限制智能体的转移能力以避免意外的行为。
4.3 LLMAgent 的创建
llmagent.New() 函数负责创建 LLMAgent:
// New 函数创建并返回一个新的 LLMAgent 实例
func New(cfg Config) (agent.Agent, error) {
    // 创建 BeforeModel 回调列表,预分配容量
    beforeModelCallbacks := make([]llminternal.BeforeModelCallback, 0, len(cfg.BeforeModelCallbacks))
    // 遍历配置中的回调,进行类型转换后追加
    for _, c := range cfg.BeforeModelCallbacks {
        beforeModelCallbacks = append(beforeModelCallbacks, llminternal.BeforeModelCallback(c))
    }
    // 创建 llmAgent 实例,填充所有配置字段
    a := &llmAgent{
        // 设置模型实例
        model:                 cfg.Model,
        // 设置模型调用前的回调
        beforeModelCallbacks:  beforeModelCallbacks,
        // 设置模型调用后的回调
        afterModelCallbacks:   afterModelCallbacks,
        // 设置模型错误回调
        onModelErrorCallbacks: onModelErrorCallbacks,
        // 设置工具调用前的回调
        beforeToolCallbacks:   beforeToolCallbacks,
        // 设置工具调用后的回调
        afterToolCallbacks:    afterToolCallbacks,
        // 设置工具错误回调
        onToolErrorCallbacks:  onToolErrorCallback,
        // 设置静态指令
        instruction:           cfg.Instruction,
        // 设置输入 Schema
        inputSchema:           cfg.InputSchema,
        // 设置输出 Schema
        outputSchema:          cfg.OutputSchema,
    }
    // 创建基础 agent,将 llmAgent.run 作为核心执行函数注入
    baseAgent, err := agent.New(agent.Config{
        // 设置智能体名称
        Name:                 cfg.Name,
        // 设置智能体描述
        Description:          cfg.Description,
        // 设置子智能体列表
        SubAgents:            cfg.SubAgents,
        // 设置前置回调
        BeforeAgentCallbacks: cfg.BeforeAgentCallbacks,
        // 注入核心执行函数
        Run:                  a.run,
        // 设置后置回调
        AfterAgentCallbacks:  cfg.AfterAgentCallbacks,
    })
    // 将 baseAgent 转换为内部接口,获取内部状态
    internalAgent, ok := baseAgent.(agentinternal.Agent)
    // 揭示内部状态
    state := agentinternal.Reveal(internalAgent)
    // 设置智能体类型为 LLMAgent
    state.AgentType = agentinternal.TypeLLMAgent
    // 保存配置到内部状态
    state.Config = cfg
    // 将基础 agent 赋值给 llmAgent
    a.Agent = baseAgent
    // 设置智能体类型
    a.AgentType = agentinternal.TypeLLMAgent
    // 保存配置
    a.Config = cfg
    // 返回创建好的 llmAgent
    return a, nil
}
注意这里的关键设计:
llmAgent组合了agent.Agent- 通过
agent.New()创建基础智能体 - 将
a.run作为Run函数注入 - 设置内部状态和类型
4.4 llmAgent 的 run 方法
llmAgent.run() 方法是 LLMAgent 的核心:
// run 方法是 LLMAgent 的核心执行函数,创建并运行 Flow 引擎
func (a *llmAgent) run(ctx agent.InvocationContext) iter.Seq2[*session.Event, error] {
    // 创建新的 InvocationContext,将当前 llmAgent 设为 Agent
    ctx = icontext.NewInvocationContext(ctx, icontext.InvocationContextParams{
        // 传递制品管理器
        Artifacts:    ctx.Artifacts(),
        // 传递记忆管理器
        Memory:       ctx.Memory(),
        // 传递会话对象
        Session:      ctx.Session(),
        // 传递分支信息
        Branch:       ctx.Branch(),
        // 设置当前智能体为 llmAgent 自身
        Agent:        a,
        // 传递用户输入内容
        UserContent:  ctx.UserContent(),
        // 传递运行配置
        RunConfig:    ctx.RunConfig(),
        // 传递调用 ID
        InvocationID: ctx.InvocationID(),
    })
    // 创建 Flow 引擎,配置所有组件
    f := &llminternal.Flow{
        // 设置 LLM 模型
        Model:                 a.model,
        // 使用默认的请求处理器链
        RequestProcessors:     llminternal.DefaultRequestProcessors,
        // 使用默认的响应处理器链
        ResponseProcessors:    llminternal.DefaultResponseProcessors,
        // 设置模型调用前的回调
        BeforeModelCallbacks:  a.beforeModelCallbacks,
        // 设置模型调用后的回调
        AfterModelCallbacks:   a.afterModelCallbacks,
        // 设置模型错误回调
        OnModelErrorCallbacks: a.onModelErrorCallbacks,
        // 设置工具调用前的回调
        BeforeToolCallbacks:   a.beforeToolCallbacks,
        // 设置工具调用后的回调
        AfterToolCallbacks:    a.afterToolCallbacks,
        // 设置工具错误回调
        OnToolErrorCallbacks:  a.onToolErrorCallbacks,
    }
    // 返回迭代器,遍历 Flow 引擎产生的事件
    return func(yield func(*session.Event, error) bool) {
        // 遍历 Flow.Run 产生的每个事件
        for ev, err := range f.Run(ctx) {
            // 可能将输出保存到状态中
            a.maybeSaveOutputToState(ev)
            // 产出事件,如果调用方停止则返回
            if !yield(ev, err) {
                return
            }
        }
    }
}
llmAgent.run() 的核心是创建并运行 Flow。Flow 是 ReAct 循环的核心实现。
5. Flow 引擎:ReAct 循环核心
Flow 结构体是 ReAct 循环的核心实现。它封装了所有必要的组件:
// Flow 结构体是 ReAct 循环的核心,封装了 LLM 调用、工具执行和智能体转移
type Flow struct {
    // Model 是 LLM 模型实例
    Model model.LLM
    // Tools 是当前智能体可用的工具列表(由 toolProcessor 填充)
    Tools                 []tool.Tool
    // RequestProcessors 是请求处理器链,在调用 LLM 前执行
    RequestProcessors     []func(ctx agent.InvocationContext, req *model.LLMRequest, f *Flow) iter.Seq2[*session.Event, error]
    // ResponseProcessors 是响应处理器链,在 LLM 返回后执行
    ResponseProcessors    []func(ctx agent.InvocationContext, req *model.LLMRequest, resp *model.LLMResponse) error
    // BeforeModelCallbacks 是模型调用前的回调
    BeforeModelCallbacks  []BeforeModelCallback
    // AfterModelCallbacks 是模型调用后的回调
    AfterModelCallbacks   []AfterModelCallback
    // OnModelErrorCallbacks 是模型调用出错的回调
    OnModelErrorCallbacks []OnModelErrorCallback
    // BeforeToolCallbacks 是工具调用前的回调
    BeforeToolCallbacks   []BeforeToolCallback
    // AfterToolCallbacks 是工具调用后的回调
    AfterToolCallbacks    []AfterToolCallback
    // OnToolErrorCallbacks 是工具调用出错的回调
    OnToolErrorCallbacks  []OnToolErrorCallback
}
5.1 Flow.Run():主循环
Flow.Run() 方法实现了 ReAct 的核心循环:
// Run 方法实现 ReAct 主循环,反复调用 runOneStep 直到收到最终响应
func (f *Flow) Run(ctx agent.InvocationContext) iter.Seq2[*session.Event, error] {
    // 返回迭代器,调用方通过 for-range 遍历事件
    return func(yield func(*session.Event, error) bool) {
        // 无限循环,直到收到最终响应或错误
        for {
            // 记录最后收到的事件
            var lastEvent *session.Event
            // 执行单步推理,遍历一步内产生的所有事件
            for ev, err := range f.runOneStep(ctx) {
                // 如果发生错误,产出错误并终止
                if err != nil {
                    yield(nil, err)
                    return
                }
                // 产出事件,如果调用方停止则终止
                if !yield(ev, nil) {
                    return
                }
                // 更新最后事件
                lastEvent = ev
            }
            // 如果没有事件或收到最终响应,退出循环
            if lastEvent == nil || lastEvent.IsFinalResponse() {
                return
            }
            // 如果是部分响应(流式模式下达到 token 上限),返回错误
            if lastEvent.LLMResponse.Partial {
                yield(nil, fmt.Errorf("TODO: last event is not final"))
                return
            }
        }
    }
}
主循环的逻辑非常清晰。它首先调用 runOneStep() 执行单步推理,这一步会完成从预处理到工具调用的完整流程。如果在这一步中收到任何错误,主循环会立即返回并将错误传播给调用方。接下来,循环检查最后一个事件是否是最终响应——当 lastEvent.IsFinalResponse() 返回 true 时,说明智能体已经完成了本轮推理,不需要继续循环。如果最后一个事件是部分响应(即流式模式下达到了 token 上限),主循环会返回一个错误,提示当前实现尚未处理这种场景。
5.2 runOneStep():单步执行
runOneStep() 是 ReAct 循环的核心,执行一次完整的 LLM 调用和工具处理:
// runOneStep 方法执行一次完整的 ReAct 步骤:预处理 -> 调用 LLM -> 后处理 -> 工具调用
func (f *Flow) runOneStep(ctx agent.InvocationContext) iter.Seq2[*session.Event, error] {
    // 返回迭代器
    return func(yield func(*session.Event, error) bool) {
        // 检查模型是否已配置
        if f.Model == nil {
            yield(nil, fmt.Errorf("agent %q: %w", ctx.Agent().Name(), ErrModelNotConfigured))
            return
        }
        // 创建 LLM 请求对象
        req := &model.LLMRequest{Model: f.Model.Name()}
        // 创建状态变更增量 map
        stateDelta := make(map[string]any)
        // 创建制品变更增量 map
        artifactDelta := make(map[string]int64)
        // 1. 预处理阶段:执行请求处理器链
        for ev, err := range f.preprocess(ctx, req) {
            // 如果出错,产出错误并返回
            if err != nil {
                yield(nil, err)
                return
            }
            // 如果有事件,产出事件
            if ev != nil && !yield(ev, nil) {
                return
            }
        }
        // 如果上下文在预处理中被结束,直接返回
        if ctx.Ended() {
            return
        }
        // 2. 调用 LLM 阶段
        for resp, err := range f.callLLM(ctx, req, stateDelta, artifactDelta) {
            // 如果出错,产出错误并返回
            if err != nil {
                yield(nil, err)
                return
            }
            // 3. 后处理阶段:执行响应处理器链
            if err := f.postprocess(ctx, req, resp); err != nil {
                yield(nil, err)
                return
            }
            // 跳过无内容的响应(无内容、无错误码、未中断)
            if resp.Content == nil && resp.ErrorCode == "" && !resp.Interrupted {
                continue
            }
            // 4. 构建最终模型响应事件
            modelResponseEvent := f.finalizeModelResponseEvent(ctx, resp, tools, stateDelta)
            // 产出模型响应事件
            if !yield(modelResponseEvent, nil) {
                return
            }
            // 5. 处理函数调用(并行执行工具)
            ev, err := f.handleFunctionCalls(ctx, tools, resp.LLMResponse, nil)
            // 如果出错,产出错误并返回
            if err != nil {
                yield(nil, err)
                return
            }
            // 6. 生成工具确认请求事件(HITL 场景)
            toolConfirmationEvent := generateRequestConfirmationEvent(ctx, modelResponseEvent, ev)
            // 如果有确认事件,产出
            if toolConfirmationEvent != nil && !yield(toolConfirmationEvent, nil) {
                return
            }
            // 7. 产出工具响应事件
            if ev != nil && !yield(ev, nil) {
                return
            }
            // 8. 处理智能体转移
            if ev.Actions.TransferToAgent != "" {
                // 查找目标智能体
                nextAgent := f.agentToRun(ctx, ev.Actions.TransferToAgent)
                // 运行目标智能体,转发其事件
                for ev, err := range nextAgent.Run(ctx) {
                    if !yield(ev, err) || err != nil {
                        return
                    }
                }
            }
        }
    }
}
5.3 单步执行流程图
5.4 preprocess():预处理阶段
预处理阶段负责构建 LLM 请求,包括请求处理器链、工具和工具集的预处理:
// preprocess 方法执行请求预处理:处理器链 -> 工具预处理 -> 工具集预处理
func (f *Flow) preprocess(ctx agent.InvocationContext, req *model.LLMRequest) iter.Seq2[*session.Event, error] {
    // 返回迭代器
    return func(yield func(*session.Event, error) bool) {
        // 执行请求处理器链:按顺序遍历所有注册的请求处理器
        for _, processor := range f.RequestProcessors {
            // 每个处理器可能产生多个事件
            for ev, err := range processor(ctx, req, f) {
                // 如果出错,产出错误并返回
                if err != nil {
                    yield(nil, err)
                    return
                }
                // 如果有事件,产出事件
                if ev != nil {
                    yield(ev, nil)
                }
            }
        }
        // 工具预处理:遍历所有工具,执行 ProcessRequest 方法
        if err := toolPreprocess(ctx, req, f.Tools); err != nil {
            yield(nil, err)
            return
        }
        // 工具集预处理:遍历智能体配置的工具集,执行 ProcessRequest 方法
        if err := toolsetPreprocess(ctx, req); err != nil {
            yield(nil, err)
            return
        }
    }
}
预处理阶段的三个层次:
- 请求处理器链:按顺序执行所有注册的请求处理器
- 工具预处理:遍历所有工具,执行它们的
ProcessRequest方法 - 工具集预处理:遍历智能体配置的工具集,执行它们的
ProcessRequest方法
5.5 callLLM():LLM 调用阶段
callLLM() 方法负责调用 LLM,并处理所有相关的回调:
// callLLM 方法封装 LLM 调用的完整生命周期:前置回调 -> 实际调用 -> 后置回调
func (f *Flow) callLLM(ctx agent.InvocationContext, req *model.LLMRequest,
                       stateDelta map[string]any, artifactDelta map[string]int64) iter.Seq2[*responseWithEventID, error] {
    // 返回迭代器
    return func(yield func(*responseWithEventID, error) bool) {
        // 获取插件管理器
        pluginManager := pluginManagerFromContext(ctx)
        // 如果插件管理器存在,执行插件的 BeforeModel 回调
        if pluginManager != nil {
            callbackResponse, callbackErr := pluginManager.RunBeforeModelCallback(cctx, req)
            // 如果插件返回了结果或错误,直接产出并返回
            if callbackResponse != nil || callbackErr != nil {
                yield(newResponseWithEventID(callbackResponse), callbackErr)
                return
            }
        }
        // 执行 Agent 自身的 BeforeModel 回调
        for _, callback := range f.BeforeModelCallbacks {
            callbackResponse, callbackErr := callback(cctx, req)
            // 如果回调返回了结果或错误,直接产出并返回
            if callbackResponse != nil || callbackErr != nil {
                yield(newResponseWithEventID(callbackResponse), callbackErr)
                return
            }
        }
        // 根据运行配置决定是否使用流式模式
        useStream := runconfig.FromContext(ctx).StreamingMode == runconfig.StreamingModeSSE
        // 实际调用 LLM 模型
        for resp, err := range generateContent(ctx, f.Model, req, useStream) {
            // 如果发生错误,执行错误处理回调
            if err != nil {
                cbResp, cbErr := f.runOnModelErrorCallbacks(ctx, req, stateDelta, artifactDelta, err)
                // ...
            }
            // 执行 AfterModel 回调
            callbackResp, callbackErr := f.runAfterModelCallbacks(ctx, resp.LLMResponse, stateDelta, artifactDelta, err)
            // ...
            // 产出响应
            yield(resp, err)
        }
    }
}
callLLM() 的回调执行顺序体现了插件优先、Agent 随后、最后执行实际调用的设计原则。首先,全局插件的 BeforeModel 回调被触发,插件可以检查或修改请求,甚至直接返回缓存的响应来跳过实际的 LLM 调用。如果插件没有返回结果,接下来执行 Agent 自身的 BeforeModel 回调列表。只有当所有前置回调都返回 nil 时,才通过 generateContent() 进行实际的 LLM 调用。如果 LLM 调用返回错误,OnModelError 回调会被依次触发,为错误处理和恢复提供了机会。在成功获取响应后,插件和 Agent 的 AfterModel 回调分别执行,它们可以记录日志、修改响应或收集指标数据。
5.6 generateContent():LLM 调用封装
generateContent() 方法封装了实际的 LLM 调用,并添加了遥测和日志:
// generateContent 函数封装实际的 LLM 调用,添加遥测和日志支持
func generateContent(ctx agent.InvocationContext, m model.LLM, req *model.LLMRequest, useStream bool) iter.Seq2[*responseWithEventID, error] {
    // 返回迭代器
    return func(yield func(*responseWithEventID, error) bool) {
        // 启动遥测 span,记录 LLM 调用
        spanCtx, span := telemetry.StartGenerateContentSpan(ctx, ...)
        // 记录请求日志
        telemetry.LogRequest(ctx, req, backend)
        // 调用模型的 GenerateContent 方法
        for resp, err := range m.GenerateContent(ctx, req, useStream) {
            // 为每个响应分配唯一的事件 ID
            response := newResponseWithEventID(resp)
            // 仅对最终响应(非部分响应)记录日志
            if !resp.Partial {
                telemetry.LogResponse(ctx, resp, backend)
            }
            // 产出响应和可能的错误
            yield(response, err)
        }
    }
}
generateContent() 的特点包括添加了完整的遥测支持,在调用前后记录请求和响应,支持流式和非流式模式,并且每个响应都分配唯一的事件 ID。
5.7 callTool():工具调用阶段
callTool() 方法封装了工具执行的完整生命周期:
// callTool 方法封装工具执行的完整生命周期:前置回调 -> 执行 -> 错误处理 -> 后置回调
func (f *Flow) callTool(toolCtx tool.Context, tool toolinternal.FunctionTool, fArgs map[string]any) map[string]any {
    var response map[string]any
    var err error
    // 获取插件管理器
    pluginManager := pluginManagerFromContext(toolCtx)
    // 如果插件管理器存在,执行插件的 BeforeTool 回调
    if pluginManager != nil {
        response, err = pluginManager.RunBeforeToolCallback(toolCtx, tool, fArgs)
    }
    // 如果插件未返回结果且无错误,执行 Agent 的 BeforeTool 回调
    if response == nil && err == nil {
        response, err = f.invokeBeforeToolCallbacks(toolCtx, tool, fArgs)
    }
    // 如果前置回调未返回结果且无错误,执行工具本身
    if response == nil && err == nil {
        response, err = tool.Run(toolCtx, fArgs)
    }
    // 如果发生错误,执行错误处理回调(插件 + Agent)
    if err != nil && pluginManager != nil {
        errorResponse, cbErr = pluginManager.RunOnToolErrorCallback(toolCtx, tool, fArgs, err)
    }
    if err != nil && errorResponse == nil && cbErr == nil {
        errorResponse, cbErr = f.invokeOnToolErrorCallbacks(toolCtx, tool, fArgs, err)
    }
    // 执行后置回调(插件 + Agent),可以修改结果
    if pluginManager != nil {
        alteredResponse, alteredErr = pluginManager.RunAfterToolCallback(toolCtx, tool, fArgs, response, err)
    }
    if alteredResponse == nil && alteredErr == nil {
        alteredResponse, alteredErr = f.invokeAfterToolCallbacks(toolCtx, tool, fArgs, response, err)
    }
    // 返回最终结果
    return response
}
工具调用的回调链:
- BeforeTool:执行前的回调,可以修改参数或提前返回
- tool.Run():实际执行工具
- OnToolError:如果出错,执行错误处理回调
- AfterTool:执行后的回调,可以修改结果
5.8 工具调用的并行执行
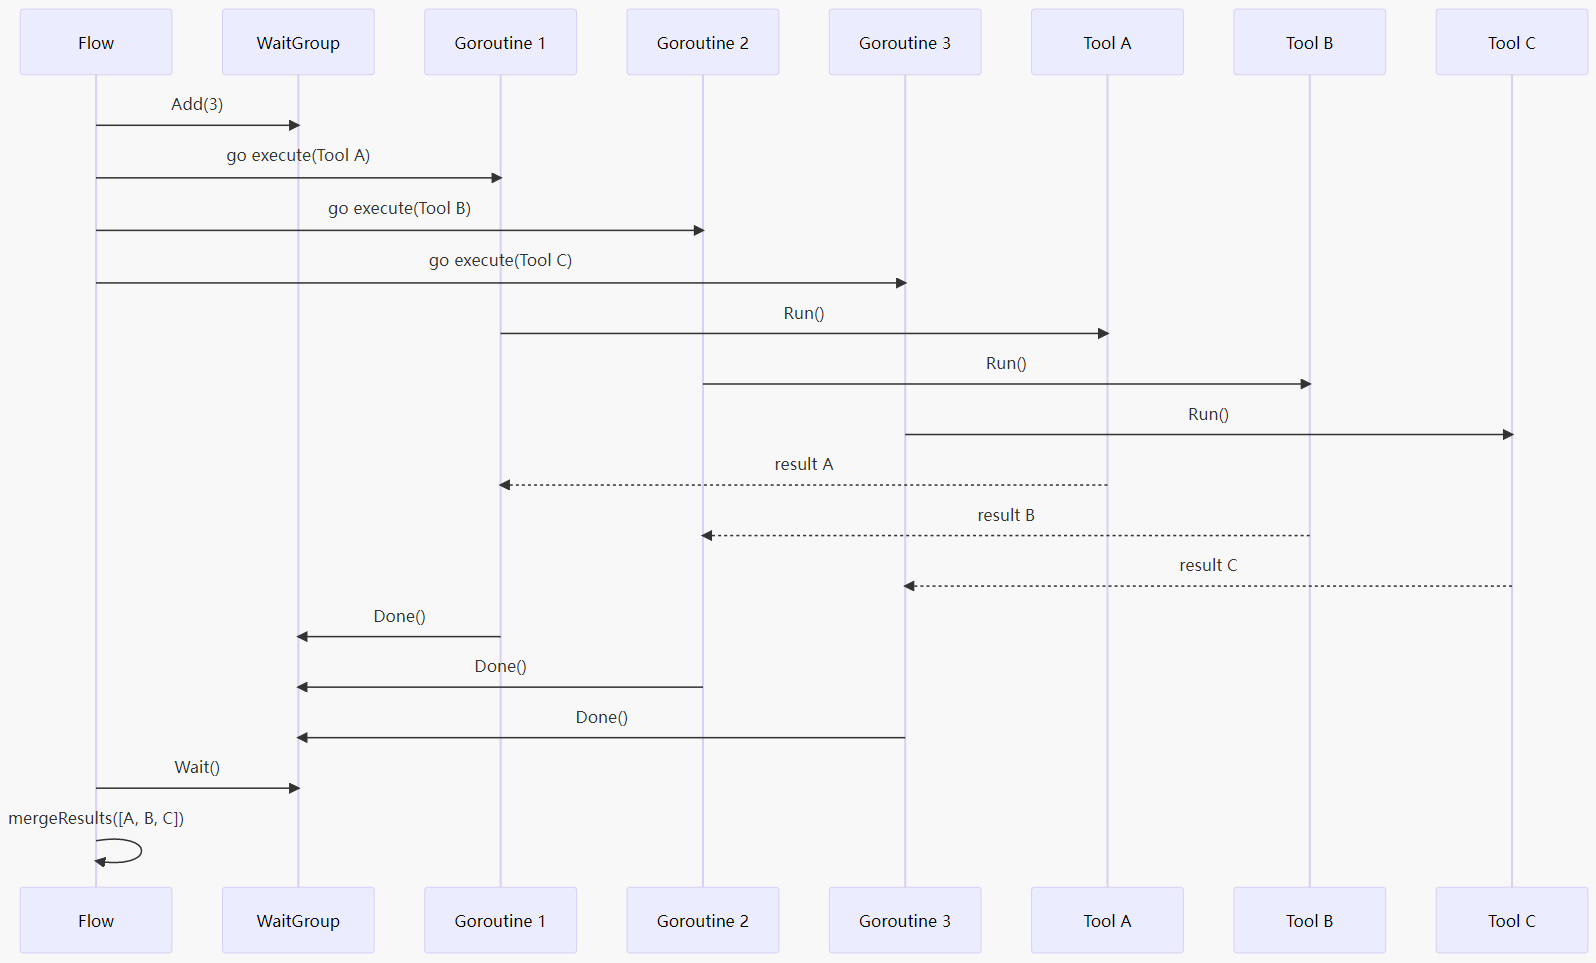
ADK 支持并行执行多个工具调用。handleFunctionCalls() 的实现:
// handleFunctionCalls 方法并行执行多个工具调用
func (f *Flow) handleFunctionCalls(ctx agent.InvocationContext, toolsDict map[string]tool.Tool, resp *model.LLMResponse, toolConfirmations map[string]*toolconfirmation.ToolConfirmation) (mergedEvent *session.Event, err error) {
    // 从响应中提取所有函数调用
    fnCalls := utils.FunctionCalls(resp.Content)
    // 如果有多个函数调用,启动合并的遥测 span
    if len(fnCalls) > 1 {
        mergedCtx, mergedToolCallSpan := telemetry.StartTrace(ctx, "execute_tool (merged)")
        ctx = ctx.WithContext(mergedCtx)
        defer mergedToolCallSpan.End()
    }
    // 创建结果切片,预分配容量
    fnResponseEvents := make([]*session.Event, len(fnCalls))
    // 使用 WaitGroup 等待所有 goroutine 完成
    var wg sync.WaitGroup
    // 为每个函数调用启动一个 goroutine
    for i, fnCall := range fnCalls {
        // 增加 WaitGroup 计数
        wg.Add(1)
        // 启动 goroutine 并行执行工具
        go func(i int, fnCall *genai.FunctionCall) {
            // goroutine 完成时减少计数
            defer wg.Done()
            // 创建工具上下文,包含 StateDelta 用于追踪状态变更
            toolCtx := toolinternal.NewToolContext(toolCallCtx, fnCall.ID, &session.EventActions{StateDelta: make(map[string]any)}, confirmation)
            // 调用工具执行
            result := f.callTool(toolCtx, funcTool, fnCall.Args)
            // 创建新事件包装工具响应
            ev := session.NewEvent(ctx.InvocationID())
            ev.LLMResponse = model.LLMResponse{
                Content: &genai.Content{
                    Role: "user",
                    Parts: []*genai.Part{
                        {FunctionResponse: &genai.FunctionResponse{
                            ID:       fnCall.ID,
                            Name:     fnCall.Name,
                            Response: result,
                        }},
                    },
                },
            }
            // 存储到结果切片
            fnResponseEvents[i] = ev
        }(i, fnCall)
    }
    // 等待所有 goroutine 完成
    wg.Wait()
    // 合并所有并行工具响应事件
    mergedEvent, err = mergeParallelFunctionResponseEvents(fnResponseEvents)
    return mergedEvent, nil
}
关键设计点包括使用 sync.WaitGroup 等待所有 goroutine 完成,每个工具调用在独立的 goroutine 中执行,结果通过 mergeParallelFunctionResponseEvents() 合并。
6. 流式响应聚合器
流式模式是 ADK 的核心特性之一。当 LLM 以 SSE(Server-Sent Events)模式返回响应时,每个响应都是不完整的片段。文本可能被拆分成多个小块,函数调用的参数可能通过 PartialArgs 逐步传输。streamingResponseAggregator 负责把这些零散的片段拼接成完整的内容。
6.1 核心数据结构
// streamingResponseAggregator 负责将流式片段的响应拼接成完整内容
type streamingResponseAggregator struct {
    // usageMetadata 累积的使用量元数据
    usageMetadata     *genai.GenerateContentResponseUsageMetadata
    // groundingMetadata 累积的接地元数据
    groundingMetadata *genai.GroundingMetadata
    // citationMetadata 累积的引用元数据
    citationMetadata  *genai.CitationMetadata
    // response 当前的 LLM 响应
    response          *model.LLMResponse
    // currentThoughtSignature 当前思考的签名
    currentThoughtSignature []byte
    // sequence 最终的 Parts 序列(按正确顺序排列的聚合结果)
    sequence             []*genai.Part
    // currentTextBuffer 当前正在聚合的文本缓冲区
    currentTextBuffer    string
    // currentTextIsThought 当前文本是否为"思考"内容
    currentTextIsThought bool
    // finishReason 最终完成原因
    finishReason         genai.FinishReason
    // currentFunctionName 正在组装的函数名
    currentFunctionName             string
    // currentFunctionID 正在组装的函数调用 ID
    currentFunctionID               string
    // currentFunctionArgs 正在组装的函数参数(嵌套 map)
    currentFunctionArgs             map[string]any
    // currentFunctionThoughtSignature 函数调用的思考签名
    currentFunctionThoughtSignature []byte
}
这个结构体维护了“正在构建中”的状态,把流式片段逐步组装成完整的内容。
6.2 ProcessResponse:流式响应的入口
// ProcessResponse 处理每个流式响应块,进行聚合和产出
func (s *streamingResponseAggregator) ProcessResponse(ctx context.Context,
    genResp *genai.GenerateContentResponse) iter.Seq2[*model.LLMResponse, error] {
    // 返回迭代器
    return func(yield func(*model.LLMResponse, error) bool) {
        // 检查响应中是否有候选结果
        if len(genResp.Candidates) == 0 {
            yield(nil, fmt.Errorf("empty response"))
            return
        }
        // 取第一个候选结果
        candidate := genResp.Candidates[0]
        // 1. 将 genai 响应转换为 LLMResponse
        resp := converters.Genai2LLMResponse(genResp)
        // 判断是否为完整轮次(FinishReason 非空表示完整)
        resp.TurnComplete = candidate.FinishReason != ""
        // 2. 聚合响应(可能产生中间事件)
        if aggrResp := s.aggregateResponse(resp); aggrResp != nil {
            // 产出聚合后的中间事件
            if !yield(aggrResp, nil) {
                return
            }
        }
        // 3. 产出处理后的响应
        if !yield(resp, nil) {
            return
        }
    }
}
每个流式块的处理分为两步:
- 聚合:把当前块的内容拼接到累积状态中
- 产出:把当前块原样 yield 给消费者
6.3 aggregateResponse:内容聚合的核心逻辑
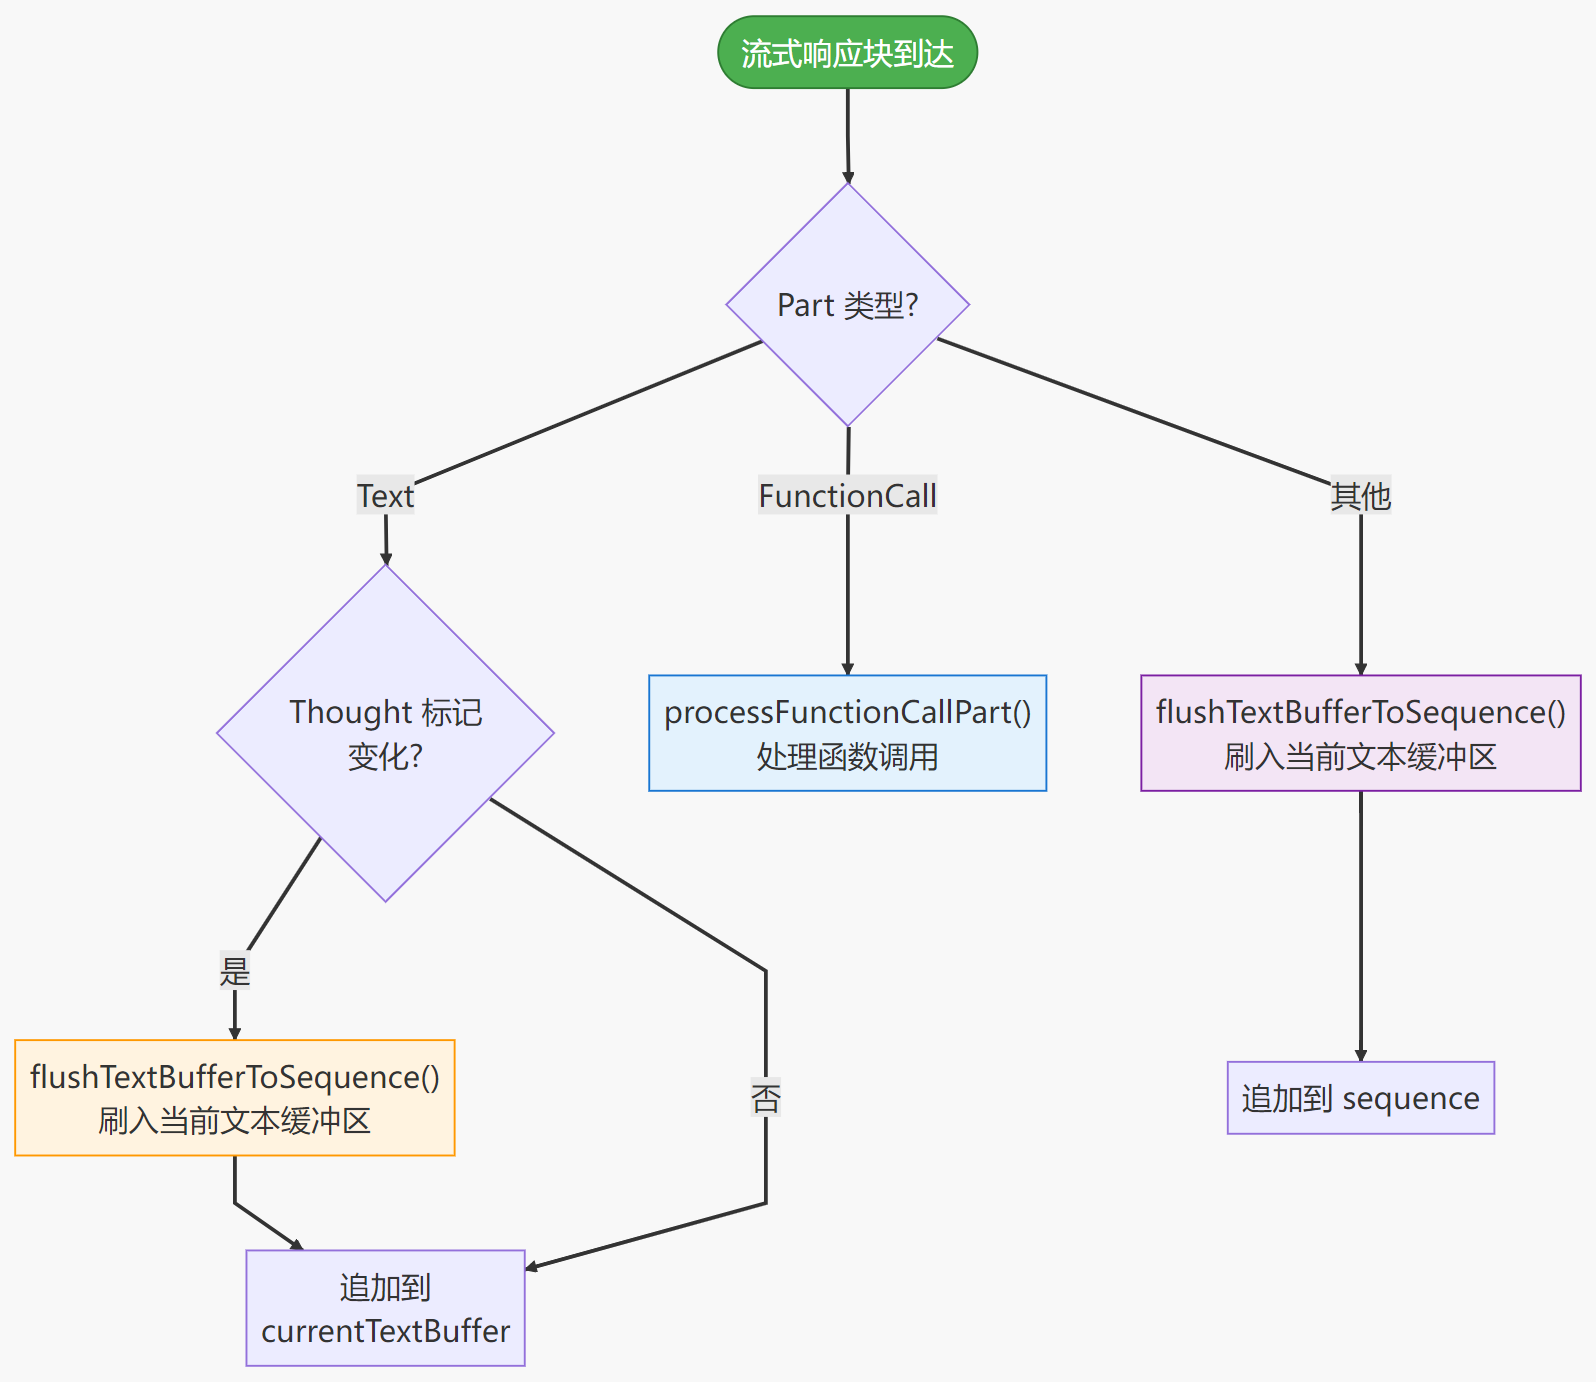
aggregateResponse 是聚合器的核心方法。它处理三种类型的 Part:
// aggregateResponse 方法聚合流式响应的内容,处理文本、函数调用和其他类型
func (s *streamingResponseAggregator) aggregateResponse(llmResponse *model.LLMResponse) *model.LLMResponse {
    // 保存当前响应引用
    s.response = llmResponse
    // 更新使用量元数据
    s.usageMetadata = llmResponse.UsageMetadata
    // 累积 Grounding 元数据(如果存在)
    if llmResponse.GroundingMetadata != nil {
        s.groundingMetadata = llmResponse.GroundingMetadata
    }
    // 累积 Citation 元数据(如果存在)
    if llmResponse.CitationMetadata != nil {
        s.citationMetadata = llmResponse.CitationMetadata
    }
    // 更新完成原因(如果非空)
    if llmResponse.FinishReason != "" {
        s.finishReason = llmResponse.FinishReason
    }
    // 标记为部分响应
    llmResponse.Partial = true
    // 如果内容为空,直接返回
    if llmResponse.Content == nil {
        return nil
    }
    // 遍历响应中的所有 Part
    for _, part := range llmResponse.Content.Parts {
        // 过滤 Gemini 3 的空 Part(使用反射检查零值)
        if reflect.ValueOf(*part).IsZero() {
            continue
        }
        // 处理文本类型的 Part
        if part.Text != "" {
            // 如果 Thought 标记发生变化,先刷入当前文本缓冲区
            if s.currentTextBuffer != "" && part.Thought != s.currentTextIsThought {
                s.flushTextBufferToSequence()
            }
            // 仅在缓冲区为空时设置 Thought 标记(新文本段的起始标记)
            if s.currentTextBuffer == "" {
                s.currentTextIsThought = part.Thought
            }
            // 将文本追加到缓冲区
            s.currentTextBuffer += part.Text
        } else if part.FunctionCall != nil {
            // 处理函数调用类型的 Part
            s.processFunctionCallPart(part)
        } else {
            // 处理其他类型 Part:先刷入文本缓冲区,再追加非文本 Part
            s.flushTextBufferToSequence()
            s.sequence = append(s.sequence, part)
        }
    }
    return nil
}
6.4 文本缓冲区的角色
文本缓冲区是聚合器的核心机制。LLM 可能在多个流式块中返回同一个句子的不同部分:
块1: "今天"
块2: "天气"
块3: "很好"
这三个块被连续追加到 currentTextBuffer 中,最终形成一个完整的文本 Part "今天天气很好"。只有当 Thought 标记发生变化(从思考切换到非思考,或反之)时,缓冲区才会被刷入序列。
6.5 流式函数调用的参数组装
当 LLM 通过流式方式返回函数调用时,参数通过 PartialArgs 逐步传输。每个 PartialArg 包含一个 JSON 路径和对应的值:
// processStreamingFunctionCallPart 处理流式函数调用中的参数片段
func (s *streamingResponseAggregator) processStreamingFunctionCallPart(part *genai.Part) {
    // 1. 收集函数名(如果非空)
    if part.FunctionCall.Name != "" {
        s.currentFunctionName = part.FunctionCall.Name
    }
    // 2. 收集函数调用 ID(如果非空)
    if part.FunctionCall.ID != "" {
        s.currentFunctionID = part.FunctionCall.ID
    }
    // 3. 逐个处理 PartialArgs(每个包含 JSON 路径和对应的值)
    for _, arg := range part.FunctionCall.PartialArgs {
        // 获取 JSON 路径(如 $.location.city)
        jsonPath := arg.JsonPath
        // 如果路径为空,跳过
        if jsonPath == "" {
            continue
        }
        // 从 PartialArg 中提取值
        value, ok := s.getValueFromPartialArg(arg, jsonPath)
        // 如果提取失败,跳过
        if !ok {
            continue
        }
        // 按 JSON 路径设置值到 currentFunctionArgs 中
        s.setValueByJSONPath(jsonPath, value)
    }
    // 4. 如果 WillContinue 为 false,函数调用完成,刷入序列
    if part.FunctionCall.WillContinue != nil && *part.FunctionCall.WillContinue {
        // 还会继续收到更多参数,等待
        return
    }
    // 刷入文本缓冲区和函数调用
    s.flushTextBufferToSequence()
    s.flushFunctionCallToSequence()
}
setValueByJSONPath 方法根据 JSON 路径(如 $.location.city)在 currentFunctionArgs map 中设置对应的值:
// setValueByJSONPath 根据 JSON 路径在嵌套 map 中设置值
func (s *streamingResponseAggregator) setValueByJSONPath(jsonPath string, value any) {
    // 初始化 currentFunctionArgs(如果为空)
    if s.currentFunctionArgs == nil {
        s.currentFunctionArgs = make(map[string]any)
    }
    // 去掉 "$." 前缀,得到纯路径部分
    path := strings.TrimPrefix(jsonPath, "$.")
    // 按 "." 分割路径
    pathParts := strings.Split(path, ".")
    // 逐级创建嵌套 map,current 指向当前层级
    current := s.currentFunctionArgs
    // 遍历除最后一级外的所有路径部分
    for _, part := range pathParts[:len(pathParts)-1] {
        // 检查当前层级是否存在该键
        next, exists := current[part]
        // 尝试转换为 map 类型
        nextMap, ok := next.(map[string]any)
        // 如果不存在或不是 map,创建新的嵌套 map
        if !exists || !ok {
            nextMap = make(map[string]any)
            current[part] = nextMap
        }
        // 进入下一层级
        current = nextMap
    }
    // 在最后一级设置值
    lastKey := pathParts[len(pathParts)-1]
    current[lastKey] = value
}
6.6 字符串值的增量拼接
getValueFromPartialArg 对字符串类型的值有特殊处理——它会检查 JSON 路径下是否已有值,如果有则进行字符串拼接:
// getValueFromPartialArg 从 PartialArg 中提取值,对字符串类型进行增量拼接
func (s *streamingResponseAggregator) getValueFromPartialArg(partialArg *genai.PartialArg, jsonPath string) (any, bool) {
    // 处理字符串类型值
    if partialArg.StringValue != "" {
        // 获取当前字符串片段
        stringChunk := partialArg.StringValue
        // 遍历路径,检查对应位置是否已有值
        var existingValue any = s.currentFunctionArgs
        for _, part := range pathParts {
            // 如果当前层级是 map,检查该键是否存在
            if m, ok := existingValue.(map[string]any); ok {
                if val, exists := m[part]; exists {
                    // 存在,继续深入
                    existingValue = val
                    continue
                }
            }
            // 不存在,标记为 nil
            existingValue = nil
            break
        }
        // 如果已有字符串值,进行拼接(如 "北" + "京" = "北京")
        if str, ok := existingValue.(string); ok {
            return str + stringChunk, true
        }
        // 否则直接返回新值
        return stringChunk, true
    }
    // 其他类型(数字、布尔、null)直接返回
    // ...
}
这意味着若参数 city 的值通过三个流式块传输(“北”、“京”、“市”),聚合器会自动将它们拼接为 "北京市"。
6.7 Close():生成最终聚合响应
当所有流式块处理完毕后,调用 Close() 生成最终的聚合响应:
// Close 方法生成最终的聚合响应,刷入所有剩余缓冲内容
func (s *streamingResponseAggregator) Close() *model.LLMResponse {
    // 如果有响应在处理中
    if s.response != nil {
        // 刷入任何剩余的文本缓冲内容
        s.flushTextBufferToSequence()
        // 刷入任何剩余的函数调用缓冲内容
        s.flushFunctionCallToSequence()
        // 检查 finishReason 是否为正常停止
        errorCode := ""
        errorMessage := ""
        if s.finishReason != genai.FinishReasonStop {
            // 非正常停止,保留错误信息
            errorCode = s.response.ErrorCode
            errorMessage = s.response.ErrorMessage
        }
        // 返回最终聚合响应
        return &model.LLMResponse{
            Content: &genai.Content{
                // 所有聚合后的 Parts,按正确顺序排列
                Parts: s.sequence,
                // 角色为模型
                Role:  genai.RoleModel,
            },
            // 累积的使用量元数据
            UsageMetadata:     s.usageMetadata,
            // 累积的接地元数据
            GroundingMetadata: s.groundingMetadata,
            // 累积的引用元数据
            CitationMetadata:  s.citationMetadata,
            // 错误码
            ErrorCode:         errorCode,
            // 错误消息
            ErrorMessage:      errorMessage,
            // 最终完成原因
            FinishReason:      s.finishReason,
        }
    }
    return nil
}
最终的聚合响应包含了完整的 Parts 序列,其中所有文本和函数调用已按正确顺序排列;累积的元数据包括 UsageMetadata、GroundingMetadata、CitationMetadata;最终的 FinishReason 判断响应是否正常结束。
6.8 responseWithEventID:带事件 ID 的响应
在 LLM 调用过程中,ADK 使用 responseWithEventID 结构体来关联响应和事件:
// responseWithEventID 结构体将 LLM 响应与唯一事件 ID 关联
type responseWithEventID struct {
    // 嵌入 LLMResponse
    *model.LLMResponse
    // eventID 是此响应的唯一标识
    eventID string
}
newResponseWithEventID 函数在创建时为每个响应分配一个 UUID:
// newResponseWithEventID 创建带唯一事件 ID 的响应包装
func newResponseWithEventID(resp *model.LLMResponse) *responseWithEventID {
    // 返回包含 UUID 的响应包装
    return &responseWithEventID{resp, uuid.New().String()}
}
这个 eventID 随后被赋值给 session.Event.ID,确保每个事件都有唯一标识,便于追踪和调试。
7. 请求处理器链
ADK 的预处理和后处理阶段都使用了处理器链模式。这是一个非常优雅的设计:把复杂的请求处理拆分成多个独立的处理器,每个处理器只负责一个特定的功能。
7.1 DefaultRequestProcessors 的完整定义
ADK 默认提供了 12 个请求处理器,按以下顺序执行:
// DefaultRequestProcessors 是默认的请求处理器链,按顺序执行
var DefaultRequestProcessors = []func(ctx agent.InvocationContext, req *model.LLMRequest, f *Flow) iter.Seq2[*session.Event, error]{
    // 1. 基础配置:复制 GenerateContentConfig 到请求中
    basicRequestProcessor,
    // 2. 工具预处理:收集工具并展开工具集
    toolProcessor,
    // 3. 认证预处理:处理需要认证的工具(TODO)
    authPreprocessor,
    // 4. 确认请求处理:人机协同(HITL)确认请求的处理
    RequestConfirmationRequestProcessor,
    // 5. 指令处理:注入系统指令和模板变量替换
    instructionsRequestProcessor,
    // 6. 身份识别:注入智能体身份信息
    identityRequestProcessor,
    // 7. 内容处理:构建对话历史
    ContentsRequestProcessor,
    // 8. NL 规划请求:自然语言规划(TODO)
    nlPlanningRequestProcessor,
    // 9. 代码执行请求:代码执行预处理(TODO)
    codeExecutionRequestProcessor,
    // 10. 输出 Schema 处理:注入合成工具支持结构化输出
    outputSchemaRequestProcessor,
    // 11. 智能体转移:注入 transfer_to_agent 工具
    AgentTransferRequestProcessor,
    // 12. 清理 displayName:Gemini API 兼容性修复
    removeDisplayNameIfExists,
}
7.2 DefaultResponseProcessors
对应的后处理链:
// DefaultResponseProcessors 是默认的响应处理器链
var DefaultResponseProcessors = []func(ctx agent.InvocationContext, req *model.LLMRequest, resp *model.LLMResponse) error{
    // NL 规划响应处理
    nlPlanningResponseProcessor,
    // 代码执行响应处理
    codeExecutionResponseProcessor,
}
7.3 各处理器职责详解
basicRequestProcessor:基础配置
负责把智能体的 GenerateContentConfig 复制到请求中,并处理 OutputSchema。
// basicRequestProcessor 处理基础配置,复制 GenerateContentConfig 到请求
func basicRequestProcessor(ctx agent.InvocationContext, req *model.LLMRequest, f *Flow) iter.Seq2[*session.Event, error] {
    // 返回迭代器
    return func(yield func(*session.Event, error) bool) {
        // 将当前 Agent 转换为 LLMAgent 类型
        llmAgent := asLLMAgent(ctx.Agent())
        // 如果不是 LLMAgent,跳过
        if llmAgent == nil {
            return
        }
        // 获取内部状态
        state := llmAgent.internal()
        // 深拷贝 GenerateContentConfig,确保不同请求之间不共享配置
        req.Config = clone(state.GenerateContentConfig)
        // 如果设置了 OutputSchema 且不需要特殊的 outputSchemaProcessor 处理
        if state.OutputSchema != nil && !needOutputSchemaProcessor(state) {
            // 直接在请求中设置响应 Schema
            req.Config.ResponseSchema = state.OutputSchema
            // 设置响应 MIME 类型为 JSON
            req.Config.ResponseMIMEType = "application/json"
        }
    }
}
注意 clone 函数使用反射实现深拷贝,确保不同请求之间不会共享配置。
toolProcessor:工具收集与预处理
这是处理器链中第一个有实际业务逻辑的处理器。它负责收集智能体的所有工具并存储到 Flow 中:
// toolProcessor 收集智能体的工具并展开工具集,存储到 Flow 中供后续处理器使用
func toolProcessor(ctx agent.InvocationContext, req *model.LLMRequest, f *Flow) iter.Seq2[*session.Event, error] {
    // 返回迭代器
    return func(yield func(*session.Event, error) bool) {
        // 幂等性保护:如果 Flow 已有工具,跳过(避免重复收集)
        if f.Tools != nil {
            return
        }
        // 将当前 Agent 转换为 LLMAgent 类型
        llmAgent, ok := ctx.Agent().(Agent)
        // 如果不是 LLMAgent,返回错误
        if !ok {
            yield(nil, fmt.Errorf("agent %v is not an LLMAgent", ctx.Agent().Name()))
            return
        }
        // 收集智能体的所有直接工具
        tools := Reveal(llmAgent).Tools
        // 展开工具集(Toolsets),提取每个工具集中的工具
        for _, toolSet := range Reveal(llmAgent).Toolsets {
            // 调用工具集的 Tools 方法获取工具列表(延迟求值)
            tsTools, err := toolSet.Tools(icontext.NewReadonlyContext(ctx))
            // 如果出错,返回错误
            if err != nil {
                yield(nil, fmt.Errorf(
                    "failed to extract tools from the tool set %q: %w",
                    toolSet.Name(), err))
                return
            }
            // 将工具集中的工具追加到工具列表
            tools = append(tools, tsTools...)
        }
        // 存储到 Flow 中,供后续处理器使用(Flow 作为共享状态)
        f.Tools = tools
    }
}
这个处理器实现了三个关键功能:
- 幂等性保护:
if f.Tools != nil { return }确保工具只收集一次 - 工具集展开:
toolSet.Tools()是延迟求值的——工具集在需要时才创建工具实例 - Flow 作为共享状态:
f.Tools是 Flow 的共享状态,后续所有处理器都通过它访问工具列表
authPreprocessor:认证预处理
处理需认证的工具,向 LLM 提供认证说明和操作建议。当前为 TODO 占位符。
// authPreprocessor 处理认证相关的工具预处理(当前为 TODO)
func authPreprocessor(ctx agent.InvocationContext, req *model.LLMRequest, f *Flow) iter.Seq2[*session.Event, error] {
    // TODO: 实现认证预处理,参考 Python 版的 auth_preprocessor.py
    return func(yield func(*session.Event, error) bool) {}
}
RequestConfirmationRequestProcessor:HITL 确认请求处理
这是最复杂的处理器之一。它处理人机协同(HITL)确认请求的完整生命周期。
核心数据结构:
// confirmedCall 结构体保存用户的确认/拒绝决定和原始的工具调用
type confirmedCall struct {
    // confirmation 是用户的确认或拒绝决定
    confirmation *toolconfirmation.ToolConfirmation
    // call 是原始的工具调用
    call         genai.FunctionCall
}
处理流程:七步确认重放:
// RequestConfirmationRequestProcessor 处理 HITL 确认请求的七步流程
func RequestConfirmationRequestProcessor(ctx agent.InvocationContext, req *model.LLMRequest, f *Flow) iter.Seq2[*session.Event, error] {
    // 返回迭代器
    return func(yield func(*session.Event, error) bool) {
        // 步骤1:构建工具名称到工具实例的映射
        toolsmap := make(map[string]tool.Tool)
        for _, tool := range f.Tools {
            toolsmap[tool.Name()] = tool
        }
        // 步骤2:收集所有会话事件
        var events []*session.Event
        if ctx.Session() != nil {
            for e := range ctx.Session().Events().All() {
                events = append(events, e)
            }
        }
        // 步骤3:从最新事件开始反向扫描,找到用户确认响应
        confirmationResponses := make(map[string]toolconfirmation.ToolConfirmation)
        confirmationEventIndex := -1
        // 从后往前遍历事件
        for k := len(events) - 1; k >= 0; k-- {
            event := events[k]
            // 跳过非用户事件
            if event.Author != "user" {
                continue
            }
            // 提取函数响应
            responses := utils.FunctionResponses(event.Content)
            // 如果没有函数响应,返回
            if len(responses) == 0 {
                return
            }
            // 遍历函数响应
            for _, funcResp := range responses {
                // 跳过非确认函数调用
                if funcResp.Name != toolconfirmation.FunctionCallName {
                    continue
                }
                // 处理两种 JSON 格式...
                confirmationResponses[funcResp.ID] = tc
            }
            // 记录确认事件索引
            confirmationEventIndex = k
            // 只处理第一个(最新的)用户事件
            break
        }
两种 JSON 格式的兼容处理:
// 格式一:ADK Web 客户端(response 封装格式)
// {"response": "{\"confirmation_status\": \"CONFIRMED\", ...}"}
// hasResponseKey 检查是否有 response 键
if hasResponseKey && len(funcResp.Response) == 1 {
    // 尝试将 response 值作为 JSON 字符串解析
    if jsonString, ok := resp.(string); ok {
        json.Unmarshal([]byte(jsonString), &tc)
    }
}
// 格式二:直接格式(其他客户端)
// {"confirmation_status": "CONFIRMED", ...}
else {
    // 将响应序列化为 JSON 再反序列化到 ToolConfirmation
    tempJSON, _ := json.Marshal(funcResp.Response)
    json.Unmarshal(tempJSON, &tc)
}
步骤4-7:工具调用重放与去重:
        // 步骤4:反向扫描事件,找到确认请求对应的原始工具调用
        for k := len(events) - 2; k >= 0; k-- {
            event := events[k]
            // 提取函数调用
            calls := utils.FunctionCalls(event.Content)
            // 如果没有函数调用,继续
            if len(calls) == 0 {
                continue
            }
            // 步骤5:匹配确认请求中的工具调用
            toolsToResumeByFunctionCallID := map[string]*confirmedCall{}
            for _, functionCall := range calls {
                // 查找对应的确认响应
                confirmation, ok := confirmationResponses[functionCall.ID]
                // 如果没有确认,跳过
                if !ok {
                    continue
                }
                // 从确认中提取原始函数调用
                originalFunctionCall, _ := toolconfirmation.OriginalCallFrom(functionCall)
                // 创建确认调用记录
                toolsToResumeByFunctionCallID[originalFunctionCall.ID] = &confirmedCall{
                    confirmation: &confirmation,
                    call:         *originalFunctionCall,
                }
            }
            // 步骤6:去重——移除已经被执行的工具调用
            for j := len(events) - 1; j > confirmationEventIndex; j-- {
                event = events[j]
                // 提取函数响应
                responses := utils.FunctionResponses(event.Content)
                for _, resp := range responses {
                    // 删除已执行的工具调用
                    delete(toolsToResumeByFunctionCallID, resp.ID)
                }
            }
            // 步骤7:执行确认后的工具调用
            parts := make([]*genai.Part, 0)
            toolsToResumeConfirmation := make(map[string]*toolconfirmation.ToolConfirmation)
            for callID, cc := range toolsToResumeByFunctionCallID {
                // 构建工具调用 Part
                parts = append(parts, &genai.Part{FunctionCall: &cc.call})
                // 保存确认信息
                toolsToResumeConfirmation[callID] = cc.confirmation
            }
            // 执行工具调用
            ev, err := f.handleFunctionCalls(ctx, toolsmap, &model.LLMResponse{
                Content: &genai.Content{Parts: parts, Role: genai.RoleUser},
            }, toolsToResumeConfirmation)
            // 产出事件
            if !yield(ev, err) {
                return
            }
        }
    }
}
去重的必要性:因为确认请求可能被用户多次发送(例如网络重试),导致同一个工具被确认多次。去重步骤通过检查 confirmationEventIndex 之后的事件中是否已经存在对应的函数响应,确保每个工具只执行一次。
instructionsRequestProcessor:指令处理与模板变量替换
这是最复杂的请求处理器之一。它负责以下工作:
- 注入全局指令(GlobalInstruction,来自根智能体)
- 注入智能体指令(Instruction,来自当前智能体)
- 支持模板变量替换(
{variable}占位符) - 支持动态指令提供者(
InstructionProvider函数)
处理流程:
// instructionsRequestProcessor 处理指令注入和模板变量替换
func instructionsRequestProcessor(ctx agent.InvocationContext, req *model.LLMRequest, f *Flow) iter.Seq2[*session.Event, error] {
    // 返回迭代器
    return func(yield func(*session.Event, error) bool) {
        // 将当前 Agent 转换为 LLMAgent 类型
        llmAgent := asLLMAgent(ctx.Agent())
        // 如果不是 LLMAgent,跳过
        if llmAgent == nil {
            return
        }
        // 获取父智能体映射
        parents := parentmap.FromContext(ctx)
        // 获取根智能体(如果当前就是根,则使用自身)
        rootAgent := asLLMAgent(parents.RootAgent(ctx.Agent()))
        if rootAgent == nil {
            rootAgent = llmAgent
        }
        // 1. 先追加全局指令(来自根智能体,作用于所有子智能体)
        if err := appendGlobalInstructions(ctx, req, rootAgent.internal()); err != nil {
            yield(nil, fmt.Errorf("failed to append global instructions: %w", err))
            return
        }
        // 2. 再追加智能体指令(来自当前智能体)
        if err := appendInstructions(ctx, req, llmAgent.internal()); err != nil {
            yield(nil, fmt.Errorf("failed to append instructions: %w", err))
            return
        }
    }
}
关键设计:全局指令先于智能体指令注入。这意味着智能体指令可以覆盖或补充全局指令。
指令注入的两种模式:
// appendInstructions 函数支持两种指令注入模式
func appendInstructions(ctx agent.InvocationContext, req *model.LLMRequest, agentState *State) error {
    // 模式一:动态指令提供者(优先级最高)
    if agentState.InstructionProvider != nil {
        // 调用指令提供者函数,传入只读上下文
        instruction, err := agentState.InstructionProvider(icontext.NewReadonlyContext(ctx))
        // 如果出错,返回错误
        if err != nil {
            return fmt.Errorf("failed to evaluate instruction provider: %w", err)
        }
        // 追加指令到请求
        utils.AppendInstructions(req, instruction)
        return nil
    }
    // 模式二:静态指令 + 模板变量替换
    // 如果静态指令为空,直接返回
    if agentState.Instruction == "" {
        return nil
    }
    // 对静态指令进行模板变量替换
    inst, err := InjectSessionState(ctx, agentState.Instruction)
    // 如果出错,返回错误
    if err != nil {
        return fmt.Errorf("failed to inject session state into instruction: %w", err)
    }
    // 追加指令到请求
    utils.AppendInstructions(req, inst)
    return nil
}
这两种模式是互斥的——如果设置了 InstructionProvider,静态指令和模板变量替换会被跳过。
模板变量替换:InjectSessionState:
这是指令处理器最强大的功能。指令中可以使用 {variable} 占位符引用会话状态、制品内容等:
// InjectSessionState 函数对指令模板中的占位符进行替换
func InjectSessionState(ctx agent.InvocationContext, template string) (string, error) {
    // 使用 strings.Builder 高效构建结果字符串
    var result strings.Builder
    // 记录上一个占位符结束的位置
    lastIndex := 0
    // 使用正则表达式查找所有占位符的起止位置
    matches := placeholderRegex.FindAllStringIndex(template, -1)
    // 遍历所有匹配的占位符
    for _, matchIndexes := range matches {
        // 占位符的起始和结束位置
        startIndex, endIndex := matchIndexes[0], matchIndexes[1]
        // 保留占位符之间的文本(原样写入)
        result.WriteString(template[lastIndex:startIndex])
        // 提取当前占位符的完整字符串
        matchStr := template[startIndex:endIndex]
        // 替换当前占位符为实际值
        replacement, err := replaceMatch(ctx, matchStr)
        // 如果出错,返回错误
        if err != nil {
            return "", err
        }
        // 写入替换后的值
        result.WriteString(replacement)
        // 更新位置
        lastIndex = endIndex
    }
    // 追加最后一段文本(最后一个占位符之后的内容)
    result.WriteString(template[lastIndex:])
    return result.String(), nil
}

// placeholderRegex 匹配占位符:{var_name} 或 {{var_name}}
var placeholderRegex = regexp.MustCompile(`{+[^{}]*}+`)
replaceMatch:占位符的六种替换规则:
// replaceMatch 函数实现了占位符的六种替换规则
func replaceMatch(ctx agent.InvocationContext, match string) (string, error) {
    // 1. 去掉花括号:"{var_name}" → "var_name"
    varName := strings.TrimSpace(strings.Trim(match, "{}"))
    // 2. 检查可选标记(以 "?" 结尾)
    optional := false
    if strings.HasSuffix(varName, "?") {
        // 标记为可选
        optional = true
        // 去掉 "?" 后缀
        varName = strings.TrimSuffix(varName, "?")
    }
    // 3. 制品引用:{artifact.filename}
    if after, ok := strings.CutPrefix(varName, "artifact."); ok {
        // 获取文件名
        fileName := after
        // 从制品服务加载文件
        resp, err := ctx.Artifacts().Load(ctx, fileName)
        // 如果加载失败
        if err != nil {
            // 如果是可选的,静默返回空字符串
            if optional {
                return "", nil
            }
            // 否则返回错误
            return "", fmt.Errorf("failed to load artifact %s: %w", fileName, err)
        }
        // 返回文件内容文本
        return resp.Part.Text, nil
    }
    // 4. 验证变量名是否合法(只允许 app:、user:、temp: 前缀)
    if !isValidStateName(varName) {
        // 不合法,返回原始字符串(不做替换)
        return match, nil
    }
    // 5. 从会话状态获取值
    value, err := ctx.Session().State().Get(varName)
    // 如果获取失败
    if err != nil {
        // 如果是可选的,静默返回空字符串
        if optional {
            return "", nil
        }
        // 否则返回错误
        return "", err
    }
    // 6. 将值转换为字符串
    if value == nil {
        return "", nil
    }
    return fmt.Sprintf("%v", value), nil
}
状态变量名验证:
// isValidStateName 验证变量名是否符合 ADK 的状态命名规范
func isValidStateName(varName string) bool {
    // 按 ":" 分割变量名
    parts := strings.Split(varName, ":")
    // 无前缀的情况:直接验证是否为合法标识符
    if len(parts) == 1 {
        return isIdentifier(varName)
    }
    // 有一个前缀的情况
    if len(parts) == 2 {
        // 构造带冒号的前缀
        prefix := parts[0] + ":"
        // 只允许三个预定义前缀:app:、user:、temp:
        validPrefixes := []string{"app:", "user:", "temp:"}
        if slices.Contains(validPrefixes, prefix) {
            // 验证前缀后的名称是否为合法标识符
            return isIdentifier(parts[1])
        }
    }
    // 其他情况不合法
    return false
}

// isIdentifier 验证字符串是否为合法的 Go 风格标识符
func isIdentifier(s string) bool {
    // 空字符串不合法
    if s == "" {
        return false
    }
    // 遍历每个字符
    for i, r := range s {
        // 首字符必须是字母或下划线
        if i == 0 {
            if !unicode.IsLetter(r) && r != '_' {
                return false
            }
        } else {
            // 后续字符可以是字母、数字或下划线
            if !unicode.IsLetter(r) && !unicode.IsDigit(r) && r != '_' {
                return false
            }
        }
    }
    return true
}
只有 app:、user:、temp: 三个前缀是合法的。这确保了状态引用的安全性。
示例:指令模板的实际效果:
指令模板:
"你是 {user:role}。你的任务是 {app:task_description}。
请参考 {artifact.guidelines.md}。
可选偏好:{user:preferences?}"

替换后:
"你是 admin。你的任务是 帮助用户管理数据。
请参考 <guidelines.md 文件内容>。
可选偏好:dark_mode"
identityRequestProcessor:身份识别
为 LLM 注入智能体的身份信息:
// identityRequestProcessor 为 LLM 注入智能体的身份信息
func identityRequestProcessor(ctx agent.InvocationContext, req *model.LLMRequest, f *Flow) iter.Seq2[*session.Event, error] {
    // 构建身份信息文本
    parts := []string{fmt.Sprintf("You are an agent. Your internal name is %q.", ctx.Agent().Name())}
    // 如果有描述,追加描述信息
    if description := ctx.Agent().Description(); description != "" {
        parts = append(parts, fmt.Sprintf("The description about you is %q.", description))
    }
    // 返回迭代器(此处为简化版)
    return func(yield func(*session.Event, error) bool) {}
}
这让 LLM 知道自己的名字和职责。
ContentsRequestProcessor:内容处理
把会话历史转换为 LLM 可用的消息格式。这是 ReAct 循环的关键一步——LLM 需要看到之前的对话历史才能进行多轮推理。
两种内容构建模式:
// ContentsRequestProcessor 根据配置选择内容构建模式
fn := buildContentsDefault // 默认模式:包含完整对话历史
// 如果配置为 "none",使用仅当前轮次模式
if llmAgent.internal().IncludeContents == "none" {
    fn = buildContentsCurrentTurnContextOnly
}
默认模式(buildContentsDefault)包含完整的对话历史,适用于需要多轮上下文的场景。
仅当前轮次模式(buildContentsCurrentTurnContextOnly)只包含从最近的用户消息或其他智能体回复开始的事件:
// buildContentsCurrentTurnContextOnly 只构建当前轮次的上下文
func buildContentsCurrentTurnContextOnly(agentName, branch string, events []*session.Event) ([]*genai.Content, error) {
    // 从后往前找到最近的用户消息或其他智能体的回复
    for i := len(events) - 1; i >= 0; i-- {
        event := events[i]
        // 如果是用户消息或其他智能体的回复,从这里开始构建
        if event.Author == "user" || isOtherAgentReply(agentName, event) {
            return buildContentsDefault(agentName, branch, events[i:])
        }
    }
    // 没找到,使用全部事件
    return buildContentsDefault(agentName, branch, events)
}
这种模式适用于不需要历史上下文的智能体——比如一个纯粹的翻译智能体,每次只需要处理当前输入。
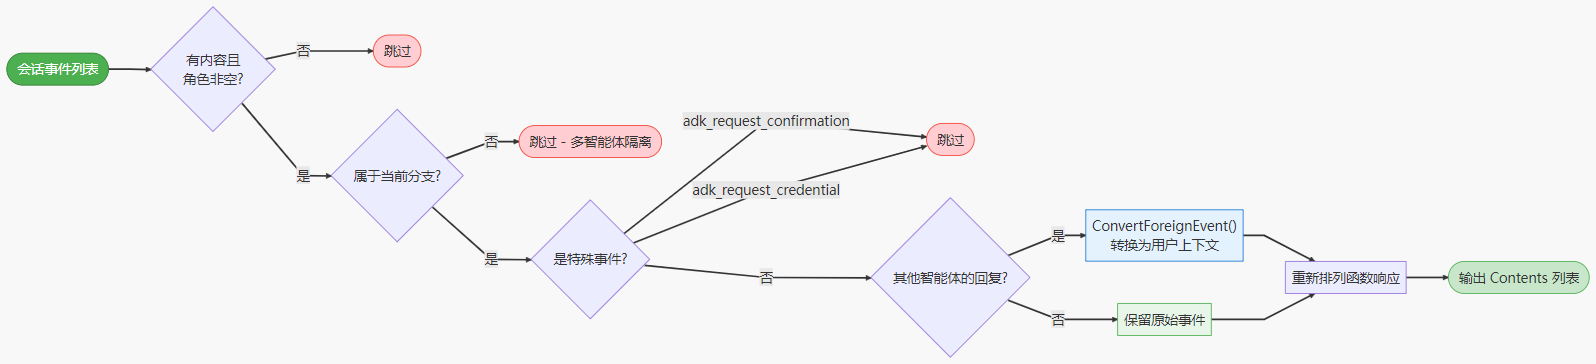
事件过滤的五层筛选:
// buildContentsDefault 对会话事件进行五层筛选
func buildContentsDefault(agentName, invocationBranch string, events []*session.Event) ([]*genai.Content, error) {
    var filtered []*session.Event
    // 遍历所有事件
    for _, ev := range events {
        // 第一层:跳过没有内容的事件(无角色或空 Parts)
        if content == nil || content.Role == "" || len(content.Parts) == 0 {
            continue
        }
        // 第二层:跳过不属于当前分支的事件(多智能体隔离)
        if !eventBelongsToBranch(invocationBranch, ev) {
            continue
        }
        // 第三层:跳过特殊事件(HITL 确认、凭证请求)
        if shouldExcludeEvent(ev) {
            continue
        }
        // 第四层:转换其他智能体的事件为上下文
        if isOtherAgentReply(agentName, ev) {
            filtered = append(filtered, ConvertForeignEvent(ev))
        } else {
            // 第五层:保留当前智能体和用户的事件
            filtered = append(filtered, ev)
        }
    }
    // 第六层:重新排列异步函数响应
    filtered, err = rearrangeEventsForLatestFunctionResponse(filtered)
    filtered, err = rearrangeEventsForFunctionResponsesInHistory(filtered)
    // ...
}
分支匹配:多智能体对话隔离:
// eventBelongsToBranch 实现基于前缀的分支匹配
func eventBelongsToBranch(invocationBranch string, event *session.Event) bool {
    // 如果没有分支信息,保留事件
    if invocationBranch == "" || event.Branch == "" {
        return true
    }
    // 完全匹配
    if event.Branch == invocationBranch {
        return true
    }
    // 前缀匹配:要求后面跟着点号,避免 agent_0 误匹配 agent_00
    return strings.HasPrefix(invocationBranch, event.Branch+".")
}
注意:使用 event.Branch+"." 作为前缀,而不是简单的 event.Branch。这避免了 agent_0 错误匹配 agent_00 的问题。
外部事件转换:ConvertForeignEvent:
当一个智能体收到另一个智能体的事件时,需要把它转换为用户上下文:
// ConvertForeignEvent 将其他智能体的事件转换为用户上下文
func ConvertForeignEvent(ev *session.Event) *session.Event {
    // 创建转换后的内容,角色设为 "user"
    converted := &genai.Content{
        Role:  "user",
        Parts: []*genai.Part{{Text: "For context:"}},
    }
    // 遍历原始事件的 Parts
    for _, p := range content.Parts {
        switch {
        // 文本类型:添加 [agent_name] said: 前缀
        case p.Text != "":
            converted.Parts = append(converted.Parts, &genai.Part{
                Text: fmt.Sprintf("[%s] said: %s", ev.Author, p.Text),
            })
        // 函数调用类型:转换为文本描述
        case p.FunctionCall != nil:
            converted.Parts = append(converted.Parts, &genai.Part{
                Text: fmt.Sprintf("[%s] called tool `%s` with parameters: %s",
                    ev.Author, p.FunctionCall.Name, stringify(p.FunctionCall.Args)),
            })
        // 函数响应类型:转换为文本描述
        case p.FunctionResponse != nil:
            converted.Parts = append(converted.Parts, &genai.Part{
                Text: fmt.Sprintf("[%s] `%s` tool returned result: %v",
                    ev.Author, p.FunctionResponse.Name, p.FunctionResponse.Response),
            })
        }
    }
    // 返回转换后的事件,作者设为 "user"
    return &session.Event{
        Author: "user",
        LLMResponse: model.LLMResponse{Content: converted},
        Branch: ev.Branch,
    }
}
例如,如果智能体 researcher 产生了文本 “北京现在 25 度”,当这个事件传递给智能体 summarizer 时,会被转换为:
user: For context:
user: [researcher] said: 北京现在 25 度
这样 summarizer 的 LLM 就能理解这是其他智能体提供的上下文信息。
异步函数响应重排:
在 HITL(Human-in-the-Loop)场景中,函数调用和函数响应之间可能间隔了很多事件。LLM 要求函数调用紧跟着函数响应。rearrangeEventsForLatestFunctionResponse 解决这个问题:
// rearrangeEventsForLatestFunctionResponse 重排事件,确保函数调用紧跟函数响应
func rearrangeEventsForLatestFunctionResponse(events []*session.Event) ([]*session.Event, error) {
    // 如果最后一个事件不是函数响应,不需要处理
    lastResponses := utils.FunctionResponses(lastEvent.Content)
    if len(lastResponses) == 0 {
        return events, nil
    }
    // 从后往前搜索匹配的函数调用
    for idx := len(events) - 2; idx >= 0; idx-- {
        // 提取函数调用
        calls := utils.FunctionCalls(events[idx].Content)
        for _, call := range calls {
            // 如果找到匹配的函数调用
            if _, found := responseIDs[call.ID]; found {
                // 记录函数调用事件索引
                functionCallEventIdx = idx
                break SearchLoop
            }
        }
    }
    // 删除调用和响应之间的所有事件
    // 合并所有相关的函数响应事件
    resultEvents := events[:functionCallEventIdx+1]
    // 合并函数响应事件
    mergedEvent, err := mergeFunctionResponseEvents(responseEventsToMerge)
    resultEvents = append(resultEvents, mergedEvent)
    return resultEvents, nil
}
这段代码确保了函数调用事件后面紧跟一个合并的函数响应事件,中间的其他事件被移除。这是必要的,因为 LLM(特别是 Gemini)要求 function_call 和 function_response 必须成对出现。
nlPlanningRequestProcessor:NL 规划请求
为自然语言规划(NL Planning)功能预留接口。规划内容在响应阶段被标记为“思考”。
// nlPlanningRequestProcessor 处理自然语言规划请求(当前为 TODO)
func nlPlanningRequestProcessor(ctx agent.InvocationContext, req *model.LLMRequest, f *Flow) iter.Seq2[*session.Event, error] {
    // TODO: 实现 NL 规划,参考 Python 版的 _nl_planning.py
    return func(yield func(*session.Event, error) bool) {}
}
codeExecutionRequestProcessor:代码执行请求
为代码执行工具预处理请求。注意它的位置在 ContentsRequestProcessor 之后,因为它需要修改消息内容以优化数据文件。
// codeExecutionRequestProcessor 处理代码执行请求(当前为 TODO)
func codeExecutionRequestProcessor(ctx agent.InvocationContext, req *model.LLMRequest, f *Flow) iter.Seq2[*session.Event, error] {
    // TODO: 实现代码执行,参考 Python 版的 _code_execution.py
    return func(yield func(*session.Event, error) bool) {}
}
outputSchemaRequestProcessor:结构化输出 Schema 处理
当智能体有输出 Schema 定义但又有工具时,LLM 无法直接使用 ResponseSchema(因为 Gemini 的 ResponseSchema 和工具调用互斥)。这个处理器通过注入一个合成工具来解决这个限制。
激活条件:
// needOutputSchemaProcessor 判断是否需要激活 outputSchemaProcessor
func needOutputSchemaProcessor(state *State) bool {
    // 如果状态或模型为空,不需要
    if state == nil || state.Model == nil {
        return false
    }
    // 只有当有工具且模型需要特殊处理时才激活
    hasTools := len(state.Tools) > 0 || len(state.Toolsets) > 0
    return hasTools && googlellm.NeedsOutputSchemaProcessor(state.Model)
}
合成工具:set_model_response:
// outputSchemaRequestProcessor 注入合成工具 set_model_response 支持结构化输出
func outputSchemaRequestProcessor(ctx agent.InvocationContext, req *model.LLMRequest, f *Flow) iter.Seq2[*session.Event, error] {
    // 返回迭代器
    return func(yield func(*session.Event, error) bool) {
        // 将当前 Agent 转换为 LLMAgent 类型
        llmAgent := asLLMAgent(ctx.Agent())
        // 如果不是 LLMAgent,跳过
        if llmAgent == nil {
            return
        }
        // 获取内部状态
        state := llmAgent.internal()
        // 如果没有 OutputSchema 或不需要特殊处理,跳过
        if state.OutputSchema == nil || !needOutputSchemaProcessor(state) {
            return
        }
        // 创建 set_model_response 合成工具
        setResponseTool := &setModelResponseTool{schema: state.OutputSchema}
        // 将合成工具打包到请求中
        if err := toolutils.PackTool(req, setResponseTool); err != nil {
            yield(nil, fmt.Errorf("failed to pack set_model_response tool: %w", err))
            return
        }
        // 注入指令,告诉 LLM 必须使用此工具输出最终响应
        utils.AppendInstructions(req, instructionForProcessor)
    }
}

// instructionForProcessor 是指令文本,告诉 LLM 必须使用 set_model_response 工具
const instructionForProcessor = "IMPORTANT: You have access to other tools, but you must provide " +
    "your final response using the set_model_response tool with the " +
    "required structured format. After using any other tools needed " +
    "to complete the task, always call set_model_response with your " +
    "final answer in the specified schema format."
setModelResponseTool 的实现:
// setModelResponseTool 是合成工具,让 LLM 输出结构化数据
type setModelResponseTool struct {
    // schema 是输出的 Schema 定义
    schema *genai.Schema
}

// Declaration 返回工具声明,将输出 Schema 作为参数 Schema
func (t *setModelResponseTool) Declaration() *genai.FunctionDeclaration {
    return &genai.FunctionDeclaration{
        // 工具名称
        Name:                 "set_model_response",
        // 工具描述
        Description:          "Set your final response using the required output schema.",
        // 直接使用输出 Schema 作为参数 Schema
        ParametersJsonSchema: t.schema,
    }
}

// Run 执行工具,验证输出是否符合 Schema
func (t *setModelResponseTool) Run(ctx tool.Context, args any) (map[string]any, error) {
    // 将参数转换为 map
    m, ok := args.(map[string]any)
    // 如果类型不匹配,返回错误
    if !ok {
        return nil, fmt.Errorf("unexpected args type for set_model_response: %T", args)
    }
    // 验证输出是否符合 Schema 定义
    if err := utils.ValidateMapOnSchema(m, t.schema, false); err != nil {
        return nil, fmt.Errorf("invalid output schema: %w", err)
    }
    // 返回验证通过的结果
    return m, nil
}
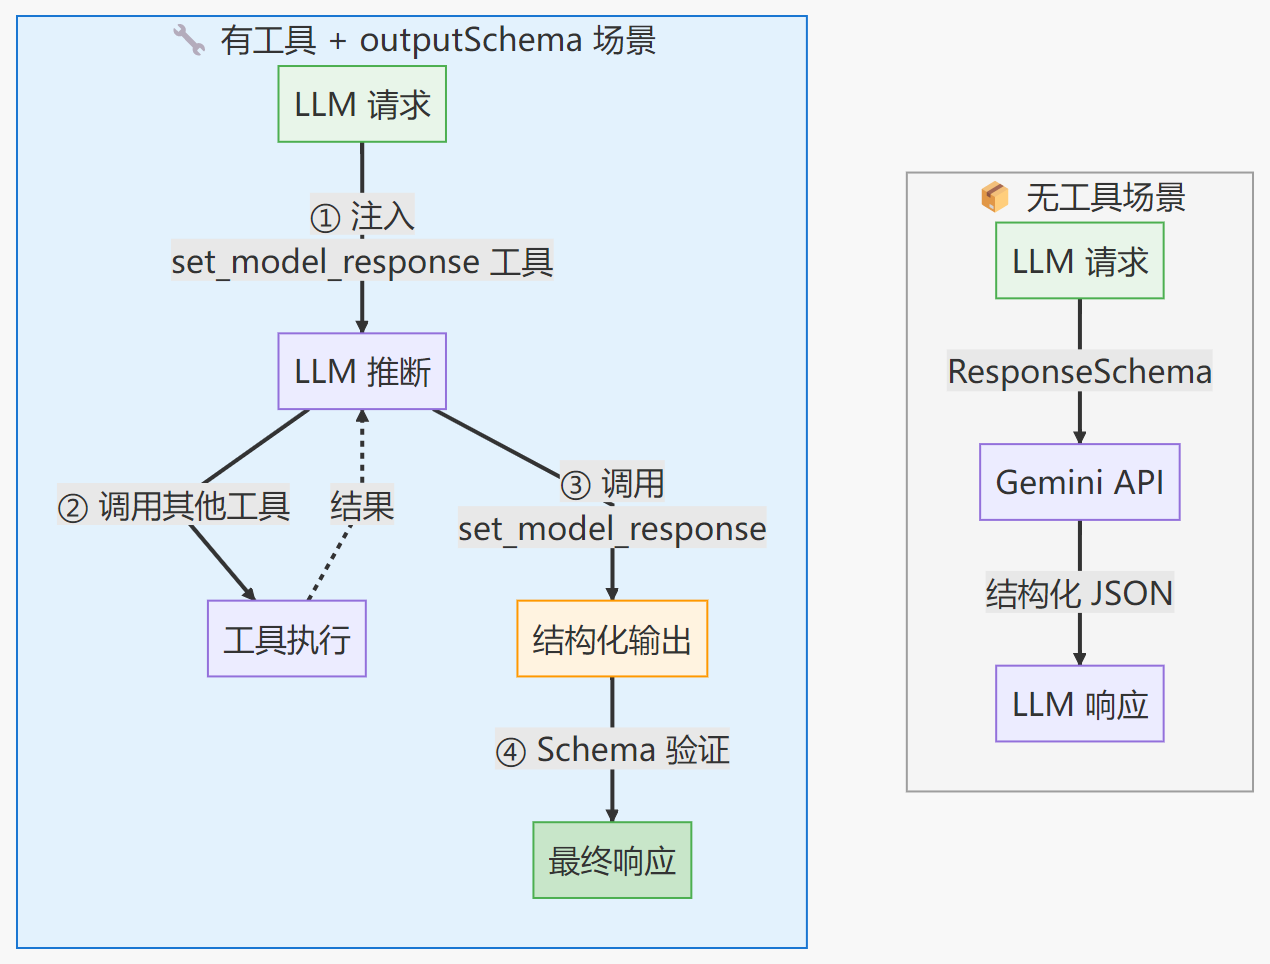
结构化响应的提取:
LLM 完成结构化输出后,createFinalModelResponseEvent 提取 set_model_response 的结果并转换为最终事件:
// createFinalModelResponseEvent 创建最终模型响应事件
func createFinalModelResponseEvent(invocationContext agent.InvocationContext, response string) *session.Event {
    // 创建新事件
    finalEvent := session.NewEvent(invocationContext.InvocationID())
    // 设置作者为当前智能体名称
    finalEvent.Author = invocationContext.Agent().Name()
    // 设置分支
    finalEvent.Branch = invocationContext.Branch()
    // 设置内容为 JSON 响应文本
    finalEvent.Content = &genai.Content{
        Role:  "model",
        Parts: []*genai.Part{{Text: response}},
    }
    return finalEvent
}

// retrieveStructuredModelResponse 从事件中提取结构化模型响应
func retrieveStructuredModelResponse(ev *session.Event) (string, error) {
    // 如果事件或内容为空,返回空
    if ev == nil || ev.LLMResponse.Content == nil {
        return "", nil
    }
    // 遍历 Parts,查找 set_model_response 的函数响应
    for _, part := range ev.LLMResponse.Content.Parts {
        // 如果找到 set_model_response 的函数响应
        if part.FunctionResponse != nil && part.FunctionResponse.Name == "set_model_response" {
            // 将响应序列化为 JSON 字符串
            bytes, _ := json.Marshal(part.FunctionResponse.Response)
            return string(bytes), nil
        }
    }
    return "", nil
}
这个设计巧妙地解决了 Gemini API 的限制:通过把输出 Schema 伪装成工具的参数 Schema,让 LLM 在调用工具的同时也能输出结构化数据。
AgentTransferRequestProcessor:智能体转移
见第 8 节“智能体转移机制”。
removeDisplayNameIfExists:Gemini API 兼容性修复
这个处理器处理一个 Gemini API 的兼容性问题:
// removeDisplayNameIfExists 移除 Gemini API 不支持的 display_name 参数
func removeDisplayNameIfExists(ctx agent.InvocationContext, req *model.LLMRequest, f *Flow) iter.Seq2[*session.Event, error] {
    // 返回迭代器
    return func(yield func(*session.Event, error) bool) {
        // 如果请求中没有内容,跳过
        if req.Contents == nil {
            return
        }
        // 将当前 Agent 转换为 LLMAgent 类型
        llmAgent := asLLMAgent(ctx.Agent())
        // 如果不是 LLMAgent,跳过
        if llmAgent == nil {
            return
        }
        // 只对 Gemini API 变体应用此修复
        if !googlellm.IsGeminiAPIVariant(llmAgent.internal().Model) {
            return
        }
        // 遍历所有内容,清除 InlineData 和 FileData 的 DisplayName
        for _, content := range req.Contents {
            // 如果 Parts 为空,跳过
            if content.Parts == nil {
                continue
            }
            // 遍历所有 Part
            for _, part := range content.Parts {
                // 清除 InlineData 的 DisplayName
                if part.InlineData != nil {
                    part.InlineData.DisplayName = ""
                }
                // 清除 FileData 的 DisplayName
                if part.FileData != nil {
                    part.FileData.DisplayName = ""
                }
            }
        }
    }
}
这个处理器的存在说明了 ADK 作为一个多模型框架的工程挑战——不同模型 API 有不同的兼容性要求,需要模型特定的适配层来处理这些差异。
7.4 LLMAgent 内部状态结构
在结束处理器链的分析之前,我们来看一下 LLMAgent 的内部状态结构。这是 Flow 引擎操作的核心数据结构:
// Agent 接口(内部版本),暴露内部状态
type Agent interface {
    // internal 返回内部状态
    internal() *State
}

// State 是 LLMAgent 的内部状态,Flow 引擎通过此结构体操作智能体
type State struct {
    // Model 是 LLM 模型实例
    Model model.LLM
    // Tools 是工具列表
    Tools    []tool.Tool
    // Toolsets 是工具集列表
    Toolsets []tool.Toolset
    // IncludeContents 是内容包含策略("default" 或 "current_turn")
    IncludeContents string
    // GenerateContentConfig 是生成配置
    GenerateContentConfig *genai.GenerateContentConfig
    // 指令系统(双层)
    // Instruction 是智能体级静态指令
    Instruction               string
    // InstructionProvider 是智能体级动态指令提供者
    InstructionProvider       InstructionProvider
    // GlobalInstruction 是全局静态指令(根智能体)
    GlobalInstruction         string
    // GlobalInstructionProvider 是全局动态指令提供者(根智能体)
    GlobalInstructionProvider InstructionProvider
    // DisallowTransferToParent 是否禁止向父智能体转移
    DisallowTransferToParent bool
    // DisallowTransferToPeers 是否禁止向同级智能体转移
    DisallowTransferToPeers  bool
    // InputSchema 是输入 Schema
    InputSchema  *genai.Schema
    // OutputSchema 是输出 Schema
    OutputSchema *genai.Schema
    // OutputKey 是输出保存键
    OutputKey string
}

// InstructionProvider 是动态指令提供者函数类型
type InstructionProvider func(ctx agent.ReadonlyContext) (string, error)

// internal 返回内部状态自身
func (s *State) internal() *State { return s }

// Reveal 揭示 Agent 的内部状态
func Reveal(a Agent) *State { return a.internal() }
这个结构体是理解 Flow 引擎如何操作 LLMAgent 的关键。每个处理器都可以通过 Reveal(llmAgent) 访问这些内部状态,读取配置并根据需要修改请求。
7.5 处理器链的扩展性
你可以在默认处理器链的基础上添加自己的处理器:
// 创建自定义 Flow,在默认处理器链后追加自定义处理器
customFlow := &llminternal.Flow{
    // 设置模型
    Model: model,
    // 在默认处理器链后追加自定义处理器
    RequestProcessors: append(
        llminternal.DefaultRequestProcessors,
        myCustomProcessor,
    ),
    // ...
}
自定义处理器必须实现这个签名:
// RequestProcessor 是请求处理器的函数签名
type RequestProcessor func(
    // ctx 是调用上下文
    ctx agent.InvocationContext,
    // req 是 LLM 请求对象
    req *model.LLMRequest,
    // f 是 Flow 引擎
    f *Flow,
) iter.Seq2[*session.Event, error]
返回的迭代器允许在处理过程中 yield 额外的事件。
7.6 设计哲学
处理器链模式体现了几个重要的设计原则。单一职责原则要求每个处理器只做一件事,这使得处理器易于理解和测试。可组合性允许处理器自由组合、添加或移除,这为框架的扩展提供了极大的灵活性。由于每个处理器都是独立的函数,可以单独进行单元测试,而不需要启动整个智能体系统。
可扩展性是处理器链模式的另一个重要优势。开发者不需要修改框架代码,只需要在创建 Flow 时追加自己的处理器,就可以添加新功能。这种开放封闭原则(对扩展开放,对修改封闭)的实现,使得 ADK 可以在不破坏现有功能的情况下持续演进。
处理器顺序的敏感性是另一个关键设计考虑。每个处理器的位置都是有意义的,不能随意调换。例如,NL Planning 处理器必须在 ContentsRequestProcessor 之后,因为它的后处理器会标记某些内容为思考内容,需要在内容构建完成之后才能处理。Code Execution 处理器也必须在 ContentsRequestProcessor 之后,因为它需要修改消息内容以优化数据文件。这些顺序约束在处理器的注释中有明确说明,开发者如果需要调整处理器链,应该首先理解每个处理器的依赖关系。
8. 智能体转移机制
智能体转移(Agent Transfer)是多智能体协作的关键机制。ADK 支持三种转移方向:
8.1 transferTargets:计算可转移目标
// transferTargets 函数计算当前智能体可以转移到的目标智能体列表
func transferTargets(agent, parent agent.Agent) []agent.Agent {
    // 先复制子智能体列表
    targets := slices.Clone(agent.SubAgents())
    // 如果父智能体为空,直接返回子智能体
    if llmParent == nil {
        return targets
    }
    // 如果不禁止向父智能体转移,添加父智能体
    if !llmAgent.internal().DisallowTransferToParent {
        targets = append(targets, parent)
    }
    // 如果不禁止向同级智能体转移
    if !llmAgent.internal().DisallowTransferToPeers {
        // 如果父智能体启用了自动流
        if shouldUseAutoFlow(parent) {
            // 遍历父智能体的所有子智能体
            for _, peer := range parent.SubAgents() {
                // 排除自身
                if peer.Name() != agent.Name() {
                    // 添加同级智能体
                    targets = append(targets, peer)
                }
            }
        }
    }
    return targets
}
注意有两个开关:DisallowTransferToParent 控制是否禁止向上转移,DisallowTransferToPeers 控制是否禁止同级转移。
8.2 TransferToAgentTool:转移工具
// TransferToAgentTool 是智能体转移工具,让 LLM 可以调用 transfer_to_agent
type TransferToAgentTool struct{}

// Declaration 返回 transfer_to_agent 工具的函数声明
func (t *TransferToAgentTool) Declaration() *genai.FunctionDeclaration {
    return &genai.FunctionDeclaration{
        // 工具名称
        Name:        "transfer_to_agent",
        // 工具描述
        Description: t.Description(),
        // 参数 Schema
        Parameters: &genai.Schema{
            // 参数类型为 object
            Type: "object",
            // 参数属性
            Properties: map[string]*genai.Schema{
                "agent_name": {
                    // agent_name 是字符串类型
                    Type:        "string",
                    // 参数描述
                    Description: "the agent name to transfer to",
                },
            },
            // 必填参数
            Required: []string{"agent_name"},
        },
    }
}

// Run 执行转移工具,设置 TransferToAgent 动作标志
func (t *TransferToAgentTool) Run(ctx tool.Context, args any) (map[string]any, error) {
    // 将参数转换为 map
    m, ok := args.(map[string]any)
    // 如果类型不匹配,返回错误
    if !ok {
        return nil, fmt.Errorf("unexpected args type: %T", args)
    }
    // 获取目标智能体名称
    agentName, ok := m["agent_name"].(string)
    // 如果名称为空或不是字符串,返回错误
    if !ok || agentName == "" {
        return nil, fmt.Errorf("empty agent_name: %v", args)
    }
    // 设置 TransferToAgent 动作标志(而不是直接调用智能体)
    ctx.Actions().TransferToAgent = agentName
    // 返回空结果
    return map[string]any{}, nil
}
注意它设置的是 Actions.TransferToAgent 而不是直接调用智能体。这是一个标准的 ADK 模式:工具只设置动作标志,实际的转移由 Flow 来处理。
8.3 shouldUseAutoFlow:判断是否启用自动流
// shouldUseAutoFlow 判断智能体是否需要启用自动流
func shouldUseAutoFlow(agent agent.Agent) bool {
    // 将 Agent 转换为 LLMAgent 类型
    a := asLLMAgent(agent)
    // 如果不是 LLMAgent,不启用
    if a == nil {
        return false
    }
    // 满足以下任一条件就启用自动流:
    // 1. 有子智能体
    // 2. 允许向上转移
    // 3. 允许同级转移
    return len(agent.SubAgents()) != 0 ||
           !a.internal().DisallowTransferToParent ||
           !a.internal().DisallowTransferToPeers
}
8.4 智能体转移的触发
在 runOneStep() 中,当工具执行后检测到 TransferToAgent 动作标志,Flow 会触发转移:
// 8. 处理智能体转移
// 如果事件的动作中设置了 TransferToAgent
if ev.Actions.TransferToAgent != "" {
    // 在智能体树中查找目标智能体
    nextAgent := f.agentToRun(ctx, ev.Actions.TransferToAgent)
    // 如果找不到目标智能体,返回错误
    if nextAgent == nil {
        yield(nil, fmt.Errorf("failed to find agent: %s", ev.Actions.TransferToAgent))
        return
    }
    // 执行目标智能体并转发其所有事件
    for ev, err := range nextAgent.Run(ctx) {
        yield(ev, err)
    }
}
8.5 agentToRun():查找目标智能体
// agentToRun 方法在允许的转移目标中查找指定名称的智能体
func (f *Flow) agentToRun(ctx agent.InvocationContext, agentName string) agent.Agent {
    // 获取父智能体映射
    parents := parentmap.FromContext(ctx)
    // 计算可转移的目标列表
    agents := transferTargets(ctx.Agent(), parents[ctx.Agent().Name()])
    // 遍历目标列表,查找匹配名称的智能体
    for _, agent := range agents {
        if agent.Name() == agentName {
            return agent
        }
    }
    // 未找到,返回 nil
    return nil
}
智能体转移不是随意的——它只能转移到允许的目标。transferTargets() 函数会根据智能体的配置(DisallowTransferToParent、DisallowTransferToPeers)决定哪些智能体可以作为转移目标。
9. 指令模板与动态指令
LLMAgent 支持两种指令方式:静态指令和动态指令。
9.1 静态指令
静态指令是一个字符串,可以使用模板语法:
// Instruction 示例:静态指令模板
Instruction: `你是一个天气助手。当用户询问天气时:
1. 识别城市名称
2. 使用 {city} 变量查询天气
3. 返回格式化的结果`,
模板变量会从会话状态中获取。如果变量不存在,可以使用 {var?} 语法使其可选。
9.2 动态指令
动态指令通过 InstructionProvider 函数提供:
// InstructionProvider 示例:动态生成指令
InstructionProvider: func(ctx agent.ReadonlyContext) (string, error) {
    // 获取用户 ID
    userID := ctx.Session().UserID()
    // 返回动态生成的指令
    return fmt.Sprintf("你是用户 %s 的专属助手。", userID), nil
},
动态指令不会自动进行模板替换,如果需要,可以使用 util/instructionutil.InjectSessionState() 辅助函数。
9.3 IncludeContents:控制对话历史
IncludeContents 控制 LLMAgent 如何处理对话历史:
// IncludeContents 类型定义对话历史包含策略
type IncludeContents string

const (
    // IncludeContentsNone 表示不包含对话历史,减少 token 消耗
    IncludeContentsNone IncludeContents = "none"
    // IncludeContentsDefault 表示包含完整对话历史
    IncludeContentsDefault IncludeContents = "default"
)
这在某些场景下很有用,比如当对话历史很长时,可以设置为 none 减少 token 消耗,当需要完整上下文时则使用 default。
9.4 输入/输出 Schema
LLMAgent 支持定义输入和输出 Schema:
// InputSchema 定义输入数据结构的 Schema
InputSchema  *genai.Schema
// OutputSchema 定义输出数据结构的 Schema
OutputSchema *genai.Schema
当设置了 OutputSchema 时,智能体只能回复,不能使用任何工具。这在需要结构化输出时非常有用。
9.5 输出保存到状态
LLMAgent 可以将输出保存到会话状态中,供后续使用:
// maybeSaveOutputToState 将智能体的输出保存到会话状态中
func (a *llmAgent) maybeSaveOutputToState(event *session.Event) {
    // 如果事件为空,跳过
    if event == nil {
        return
    }
    // 如果事件不是当前智能体产生的,跳过
    if event.Author != a.Name() {
        return
    }
    // 如果配置了 OutputKey 且事件非部分响应、有内容
    if a.OutputKey != "" && !event.Partial && event.Content != nil && len(event.Content.Parts) > 0 {
        var sb strings.Builder
        // 遍历所有 Part,收集非思考的文本内容
        for _, part := range event.Content.Parts {
            // 只收集文本内容,跳过思考内容
            if part.Text != "" && !part.Thought {
                sb.WriteString(part.Text)
            }
        }
        // 获取聚合后的文本
        result := sb.String()
        // 初始化 StateDelta(如果为空)
        if event.Actions.StateDelta == nil {
            event.Actions.StateDelta = make(map[string]any)
        }
        // 将结果保存到 StateDelta 中
        event.Actions.StateDelta[a.OutputKey] = result
    }
}
这个功能非常实用。例如,你可以:
- 让分析智能体将结果保存到
state.analysis - 让写作智能体从
state.analysis读取并生成报告
10. 小结
通过本文的分析,我们深入理解了 ADK Go 中智能体的实现原理:
Agent 接口:定义了智能体的基本行为,返回事件序列。internal() 方法实现了内部访问的封装。
上下文层次结构:InvocationContext 到 CallbackContext 到 ReadonlyContext,每层提供不同级别的访问权限。CallbackContext 通过 StateDelta 和 ArtifactDelta 实现变更追踪。
agent 结构体:基础实现,包含 beforeAgentCallbacks 和 afterAgentCallbacks 回调机制,以及由具体智能体注入的 run 核心执行函数。
LLMAgent:基于 LLM 的智能体,通过组合模式复用基础智能体。llmAgent.run() 创建 Flow 引擎并注入所有配置。
Flow 引擎:ReAct 循环核心。Run() 实现主循环,runOneStep() 实现单步推理(预处理 -> 调用 LLM -> 后处理 -> 工具调用 -> 智能体转移)。callLLM() 和 callTool() 分别封装了 LLM 和工具的完整生命周期回调。
流式响应聚合器:streamingResponseAggregator 将 SSE 流式片段拼接成完整内容。处理文本缓冲、函数调用参数组装(支持 JSON 路径嵌套和字符串增量拼接),最终通过 Close() 生成完整聚合响应。
请求处理器链:12 个处理器按顺序执行。basicRequestProcessor 复制配置,toolProcessor 收集工具,instructionsRequestProcessor 处理指令和模板变量替换(支持 {var} 占位符、{artifact.xxx} 制品引用、{var?} 可选标记),ContentsRequestProcessor 进行五层事件筛选,RequestConfirmationRequestProcessor 处理 HITL 确认的七步重放流程,outputSchemaRequestProcessor 通过合成工具解决 Gemini API 限制。
智能体转移:通过 transfer_to_agent 工具实现,支持父智能体、子智能体、同级智能体之间的转移。DisallowTransferToParent 和 DisallowTransferToPeers 控制转移范围。
指令系统:支持静态指令模板和动态 InstructionProvider 函数。{var} 占位符支持 app:、user:、temp: 三种前缀,{artifact.xxx} 支持制品引用,{var?} 支持可选变量。
输出保存:通过 OutputKey 将智能体输出保存到 StateDelta,支持智能体间的数据传递。

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐


 2
 0
- 0


 已为社区贡献1条内容

所有评论(0)