LangGraph 工作流与 Agent 开发实战
AI大模型工程师-应用篇 系列目录:
├── LangChain
│ ├── 提示词模板、对话管理与结构化输出核心用法
│ ├── LCEL 表达式语法
│ └── 多模态聊天机器人实战
├── Embedding
│ └── Embedding 与向量数据库简单应用——从文本向量化到 RAG 检索增强生成
├── LangGraph
│ └── LangGraph 工作流与 Agent 开发实战(本文)
└── MCP
└── 协议与 Agent 通信实战(即将发布)
本文从 LangChain 的线性链路出发,解释为什么需要 LangGraph,厘清核心概念与 Agent 的本质,然后从零构建一个完整的 LangGraph Agent 项目——涵盖项目初始化、工具定义(四种定义方式、参数描述增强、高级特性)、状态管理、记忆存储机制以及接口发布等核心内容。
文章目录
一、从 LangChain 到 LangGraph
1.1 为什么需要新的框架?
在前面的文章中,我们用 LangChain 的 LCEL 语法构建了不少链路:提示词模板 → 大模型 → 输出解析器,数据像流水线一样从头流到尾,中间不拐弯、不回头。
这种线性链路能覆盖大多数"问答"场景,但一旦任务变复杂,就会碰壁。
举个例子:我们希望构建一个能调用工具的 Agent。它的工作流程是这样的:
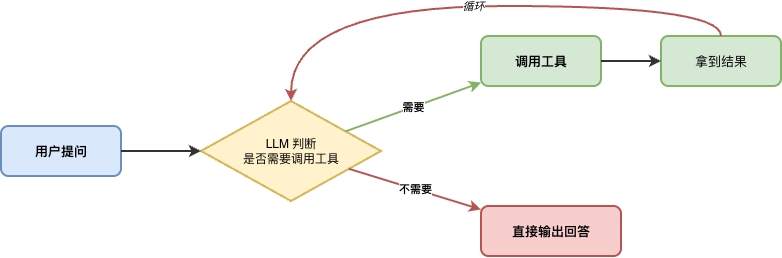
这里有两个 LCEL 搞不定的东西:条件分支(根据 LLM 的判断走不同路径)和循环(工具调用后还要回到 LLM 再判断一次)。
LCEL 的设计目标是"声明式的线性管道",它没有提供原生的循环和条件跳转能力。要在 LCEL 中实现上面的逻辑,你需要写大量的 Python 胶水代码来手动控制流程,链路本身变得难以阅读和维护。
LangGraph 就是为了解决这个问题而诞生的。 它用"状态图"来描述工作流:每个操作是图中的一个节点,节点之间的跳转关系是边,边可以带条件。循环、分支、回退都成了图结构中的自然表达,不再需要额外的胶水代码。
1.2 LangGraph 是什么?
一句话概括:LangGraph 是一个基于图(Graph)的 LLM 应用编排框架,用"状态 + 节点 + 边"来描述复杂的工作流。
如果说 LCEL 是一条"流水线"——数据从左到右依次经过每个工序,那 LangGraph 就是一张"流程图"——数据在节点之间流转,走哪条路取决于当前的状态。
LangGraph 由 LangChain 团队开发和维护,但它是一个独立的 Python 库(包名 langgraph),有自己的 API 和设计理念。
类比来看:LangChain 是工具箱,里面装着锤子(ChatModel)、螺丝刀(PromptTemplate)、扳手(OutputParser)等各种工具;LangGraph 是施工图纸,它告诉你先用锤子敲这里,再用螺丝刀拧那里,如果检查不合格就回去重新敲。两者是互补关系:LangChain 提供组件,LangGraph 编排组件的执行流程。
| LangChain | LangGraph | |
|---|---|---|
| 定位 | LLM 应用的组件工具箱 | LLM 工作流的编排引擎 |
| 编排方式 | 线性链路(LCEL 管道) | 有向图(节点 + 边) |
| 是否支持循环 | 不原生支持 | 原生支持 |
| 是否支持条件分支 | 有限支持(RunnableBranch) | 原生支持(条件边) |
| 数据流模型 | 上一步的输出 → 下一步的输入 | 所有节点共享同一个 State |
| 适用场景 | 线性的问答/检索/生成链路 | Agent、多步推理、复杂工作流 |
1.3 核心概念
LangGraph 围绕五个核心概念构建:
- StateGraph:整个工作流的容器,往里面添加节点和边,最后编译(
compile)成一个可执行的图。 - State(状态):贯穿整个工作流的共享数据结构(通常用
TypedDict定义)。可以把它想象成一块"白板":工作流启动时白板上写着初始信息,每个节点执行后往白板上擦写新内容,下一个节点看到的就是更新后的白板。 - Node(节点):工作流中的每一步操作,本质上是一个 Python 函数。接收当前 State,返回要更新的字段。节点之间是解耦的——每个节点只关心"我从 State 里读什么、往 State 里写什么"。
- Edge(边):节点之间的连接。分为普通边(无条件跳转)和条件边(根据当前 State 动态决定下一步去哪个节点)。条件边是 LangGraph 最强大的特性之一。
- START / END:内置的特殊节点,分别标记流程的入口和出口。
把以上概念组合起来,一个典型的 LangGraph 工作流长这样:
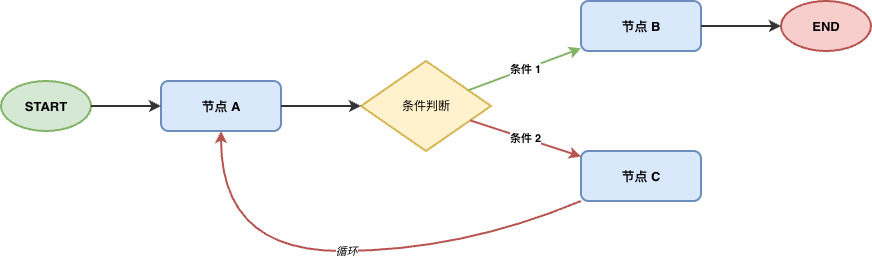
这就是一张有向图:有入口、有出口、有分支、有循环——LangGraph 名字里的 “Graph” 正是这个含义。
1.4 什么是 Agent?
Agent(智能体)是一个以 LLM 为"大脑"的自主系统。 它能够感知当前状态、制定计划、调用工具执行操作,并根据执行结果决定下一步行动,直到任务完成。
和普通的 LLM 对话相比,Agent 多了三个关键能力:
- 规划(Planning):面对复杂任务,能把它拆分成多个步骤。
- 工具调用(Tool Use):能调用外部工具——搜索引擎、API、数据库、计算器等——来获取信息或执行操作。
- 自主迭代(Autonomous Iteration):检查每一步的执行结果,决定是继续、重试,还是结束。这是一个循环过程。
用一句话区分:普通 LLM 对话是"你问我答",Agent 是"你下指令,我自己想办法完成"。
Agent 的核心工作模式本质上就是一个带条件分支和循环的状态图——这正是它和 LangGraph 总是一起出现的原因:
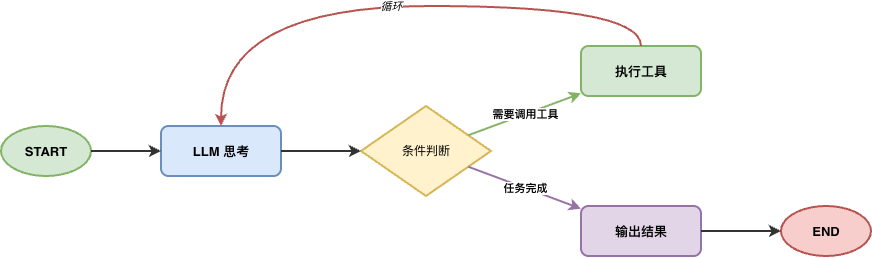
普通 LLM 应用、Workflow 和 Agent 的区别:
| 普通 LLM 应用 | Workflow(工作流) | Agent(智能体) | |
|---|---|---|---|
| 执行流程 | 固定的一问一答 | 开发者预定义多步流程 | LLM 在运行时动态决定 |
| 工具调用 | 不调用 | 按固定顺序调用 | LLM 自主选择是否调用、调用哪个 |
| LLM 的角色 | 文本生成器 | 被调用者,在固定节点中执行特定任务 | 决策者,决定下一步做什么 |
| 可控性 | 高 | 较高,分支逻辑由开发者写死 | 低,结果依赖 LLM 的判断质量 |
| 典型场景 | 问答、翻译、摘要 | 步骤明确的任务(摘要→翻译→审校) | 开放性任务(“帮我调研竞品并写份报告”) |
一句话区分:普通应用是"写死的一条线",Workflow 是"开发者画好流程图,LLM 按图执行",Agent 是"开发者给 LLM 一套工具,LLM 自己画流程图"。
带着这些问题继续阅读——它们的答案会在后续章节中逐一浮现:
- 用 LangGraph 是否必须依赖 LangChain?两者的边界在哪里?
- LangGraph(开源框架)、LangGraph Platform(云服务)、LangGraph Studio(调试工具)分别是什么?
- 相比 LCEL 的线性链路,LangGraph 在实际开发中具体带来了哪些优势?
二、环境准备与项目构建
理解了核心概念之后,需要将它们落地为一个可运行的项目。LangGraph 提供了完整的 CLI 工具链,支持快速初始化项目并启动开发服务器。在编写 Agent 逻辑之前,需要先搭建好项目骨架和运行环境。
2.1 使用脚手架初始化项目
LangGraph CLI 提供了 langgraph new 命令,可以从官方模板快速生成项目骨架,省去手动创建目录和配置文件的步骤。
安装 CLI:
# 推荐通过 uv 安装(inmem 附带内存模式依赖,开发调试时无需外部数据库)
uv add --dev "langgraph-cli[inmem]>=0.4.14"

# 或通过 pip 安装
pip install "langgraph-cli[inmem]"
初始化项目:
langgraph new my_agent
执行后 CLI 会提示选择模板(如 react-agent、chatbot 等),选择后自动生成完整的项目结构,包括 langgraph.json、pyproject.toml、graph.py 等文件,以及 .env 模板。
生成的项目可以直接通过 langgraph dev 启动运行,后续章节中的配置文件和目录结构都以此为基础进行说明。
如果不使用脚手架,也可以完全手动创建项目——核心只需要
langgraph.json+graph.py两个文件。下面的 2.2-2.5 节会逐一说明每个配置文件的作用。
2.2 项目依赖配置
本文使用 uv 作为 Python 包管理工具。将以下内容保存为项目根目录下的 pyproject.toml 文件:
[project]
name = "langgraph_agent"
version = "0.0.1"
requires-python = ">=3.11"
dependencies = [
    "langchain>=1.2.13",
    "langchain-openai>=1.1.11",
    "langgraph>=1.1.2",
    "langgraph-checkpoint-postgres>=3.0.5",
    "python-dotenv>=1.0.1",
    "zai-sdk==0.2.2",  # 智谱 AI SDK
]

[dependency-groups]
dev = [
    "langgraph-cli[inmem]>=0.4.14",  # LangGraph CLI 工具
    "pytest>=8.3.5",
    "ruff>=0.8.2",
    "mypy>=1.13.0",
]
执行 uv sync 即可自动创建虚拟环境并安装所有依赖。
2.3 LangGraph 配置文件
LangGraph 项目通过 langgraph.json 配置文件来定义图(Graph)的入口和环境变量。在项目根目录创建该文件:
{
  "$schema": "https://langgra.ph/schema.json",
  "dependencies": ["."],
  "graphs": {
    "agent": "./src/agent/graph.py:graph"
  },
  "env": ".env",
  "image_distro": "wolfi"
}
关键配置说明:
| 字段 | 说明 |
|---|---|
graphs | 定义图的名称和入口,格式为 "名称": "模块路径:变量名" |
env | 环境变量文件路径 |
dependencies | 项目依赖路径 |
graphs 中的名称和路径都可以根据项目需要自定义修改。名称(如 "agent")会作为 API 调用时的标识符(对应 client.runs.stream(None, "agent", ...) 中的第二个参数);路径指向实际的图定义模块和变量。一个项目可以注册多个图:
"graphs": {
    "agent": "./src/agent/graph.py:graph",
    "chatbot": "./src/chatbot/graph.py:chat_graph"
}
2.4 环境变量配置
创建 .env 文件管理 API 密钥等敏感信息:
# 本地私有化部署模型
LOCAL_API_KEY=xx
LOCAL_BASE_URL=http://127.0.0.1:11434/v1

# 智谱 AI
ZHIPU_API_KEY=sk-xxx

# OpenAI
OPENAI_API_KEY=sk-xxx
OPENAI_BASE_URL=https://api.openai.com/v1

# Qwen 多模态(魔搭社区)
QWEN_API_KEY=sk-xxx
QWEN_BASE_URL=https://api-inference.modelscope.cn/v1
2.5 项目结构
本文示例项目结构如下:
langgraph_agent/
├── langgraph.json           # LangGraph 配置文件
├── pyproject.toml           # Python 项目配置
├── .env                     # 环境变量
└── src/
    └── agent/
        ├── __init__.py      # 导出 graph
        ├── graph.py         # 核心 Agent 图定义
        ├── state.py      # 状态定义
        ├── llm_config.py        # LLM 模型配置
        ├── env_utils.py     # 环境变量加载
        └── tools/           # 工具定义目录
            ├── __init__.py
            ├── calculator.py       # 四则运算工具(多种定义方式)
            ├── web_search.py       # 网络搜索工具
            ├── chain_tool.py       # Chain 转 Tool 示例
            └── user_greeting.py    # State 注入示例
LangGraph 官方模板非常精简,核心只需要 langgraph.json + graph.py。以上结构为个人项目参考,按功能模块划分工具文件。
文件职责说明:
| 文件 | 职责 |
|---|---|
graph.py | Agent 入口,创建 ReAct(Reasoning + Acting,推理-行动循环)图 |
state.py | 自定义 AgentState |
llm_config.py | LLM 实例化配置 |
env_utils.py | 环境变量加载 |
tools/ | 按功能划分工具模块(calculator、web_search 等) |
2.6 启动 LangGraph 服务
使用 LangGraph CLI 启动开发服务器:
# 进入项目目录
cd langgraph_agent

# 启动开发服务器(支持热重载)
langgraph dev
服务启动后,API 在 http://localhost:2024 提供服务,同时自动打开 LangGraph Studio 可视化调试界面(地址为 https://smith.langchain.com/studio/?baseUrl=http://127.0.0.1:2024)。
常用 CLI 命令:
| 命令 | 说明 |
|---|---|
langgraph dev | 开发模式启动(支持热重载) |
langgraph up | 生产模式启动(使用 Docker) |
langgraph test | 运行测试 |
三、核心组件:LLM 与状态管理
项目骨架搭建完成后,接下来配置 Agent 运行所依赖的两个核心组件:LLM(负责推理决策)和 State(负责在节点间传递数据)。第一章中我们用"白板"比喻了 State 的概念,现在来看它在代码中的实际形态。
3.1 LLM 模型配置
Agent 能理解用户意图、决定何时调用工具、并生成自然语言回复,这些能力都来自 LLM。LangGraph 本身并不限定你用哪家模型,只要是兼容 LangChain ChatModel 接口的模型都可以接入,比如 OpenAI、Claude、智谱 GLM、DeepSeek、本地 Ollama/vLLM 等。切换模型通常只需要修改这一个文件。
我们把 LLM 配置集中放在 src/agent/llm_config.py,方便 graph.py 和工具模块统一引用:
from langchain_openai import ChatOpenAI
from agent.env_utils import LOCAL_BASE_URL, QWEN_API_KEY, QWEN_BASE_URL

# 本地私有化部署的大模型
llm = ChatOpenAI(
    model='qwen3',
    temperature=0.8,
    api_key='xx',
    base_url=LOCAL_BASE_URL,
    extra_body={'chat_template_kwargs': {'enable_thinking': False}},
)

# 多模态大模型(云端 API)
multimodal_llm = ChatOpenAI(
    model='Qwen/Qwen3-Omni-30B-A3B-Instruct',
    api_key=QWEN_API_KEY,
    base_url=QWEN_BASE_URL,
)
支持的模型类型:OpenAI、Claude、智谱 GLM、DeepSeek、本地部署模型(Ollama/vLLM)等。
3.2 AgentState 状态定义
State 是贯穿整个工作流的共享数据结构,所有节点都可以读取和更新它。LangGraph 提供了两个内置 State,也支持自定义扩展。
内置 State 对比:
| State | 来源 | 字段 | 说明 |
|---|---|---|---|
MessagesState | langgraph.graph | messages | 仅包含消息列表,轻量通用 |
AgentState | langgraph.prebuilt | messages + remaining_steps | 在 MessagesState 基础上增加了剩余步数控制 |
两者的完整定义如下:
# MessagesState 的内部定义(无需手动编写,直接 import 使用即可)
# from langgraph.graph import MessagesState
class MessagesState(TypedDict):
    messages: Annotated[list[AnyMessage], add_messages]

# AgentState 的内部定义(create_react_agent 默认使用)
# from langgraph.prebuilt.chat_agent_executor import AgentState
class AgentState(TypedDict):
    messages: Annotated[Sequence[BaseMessage], add_messages]
    remaining_steps: NotRequired[RemainingSteps]  # Agent 剩余可执行步数,防止无限循环
如何选择:如果使用
create_react_agent,默认已绑定AgentState,直接继承它扩展即可;如果是手动构建StateGraph,使用MessagesState更轻量。
自定义状态扩展:继承 AgentState,添加业务所需的字段。以下是 src/agent/state.py 的定义:
from langgraph.prebuilt.chat_agent_executor import AgentState


class CustomState(AgentState):
    """自定义状态,扩展内置的 AgentState"""
    username: str  # 新增用户名字段
CustomState 继承了 AgentState 的 messages 和 remaining_steps 字段,并新增了 username。后续在第四章的 State 注入工具中,会用到这个自定义字段。
3.3 状态更新的 Reducer 机制
当多个节点更新同一个状态字段时,LangGraph 使用 Reducer(归约函数,决定多个更新值如何合并为一个最终值)来决定如何合并更新:
| Reducer | 行为 | 适用类型 |
|---|---|---|
| 默认(无 reducer) | 后一个值覆盖前一个值 | 单值字段 |
add_messages | 消息追加合并 | messages 字段 |
以上一节的 CustomState 为例:messages 字段通过 Annotated[..., add_messages] 绑定了 add_messages reducer,新消息会追加到列表末尾;而 username 字段没有 reducer,后一个值直接覆盖前一个值。
四、工具定义与高级特性
Agent 能调用工具的前提是工具被正确定义和注册。LangGraph 继承了 LangChain 的工具体系,提供了四种核心定义方式,以及围绕参数描述、运行时配置、状态管理等维度的增强能力。
4.1 四种工具定义方式
根据工具的复杂度和来源,LangChain 提供了四种创建工具的方式:
| 方式 | 核心 API | 适用场景 |
|---|---|---|
@tool 装饰器 | @tool | 大多数场景,最简单直接 |
StructuredTool 类 | StructuredTool.from_function() | 需要同时提供同步和异步实现 |
BaseTool 子类 | 继承 BaseTool | 复杂业务逻辑、需要封装多个方法 |
| Chain 转 Tool | chain.as_tool() | 复用已有的 LCEL Chain |
方式一:@tool 装饰器
使用 @tool 装饰器将普通函数转换为工具,函数的 docstring 自动成为工具描述:
from langchain_core.tools import tool

@tool(return_direct=True)  # return_direct=True 直接返回结果,不继续处理
def calculate(a: float, b: float, operation: str) -> float:
    """工具函数:计算两个数据的运算结果"""
    result = 0.0
    match operation:
        case "add":
            result = a + b
        case "subtract":
            result = a - b
        case "multiply":
            result = a * b
        case "divide":
            if b != 0:
                result = a / b
            else:
                raise ValueError("除数不能为零")
    return result
关键参数:
return_direct=True:工具执行后直接返回结果,不再交给 LLM 处理
注意:
return_direct在create_react_agent中的行为是——当该工具被调用后,Agent 会立即结束当前轮次并将工具返回值作为最终输出,跳过 LLM 的后续总结步骤。适用于不需要 LLM 二次加工的场景(如精确计算、数据查询)。
方式二:StructuredTool 类
当需要同时提供同步和异步实现时,@tool 装饰器无法满足,需要使用 StructuredTool:
from langchain_core.tools import StructuredTool

def calculate_sync(a: float, b: float, operation: str) -> float:
    """同步版本:执行两个数值的四则运算"""
    match operation:
        case "add": return a + b
        case "subtract": return a - b
        case "multiply": return a * b
        case "divide": return a / b if b != 0 else 0.0

async def calculate_async(a: float, b: float, operation: str) -> float:
    """异步版本:逻辑与同步版本一致"""
    return calculate_sync(a, b, operation)

calculator = StructuredTool.from_function(
    func=calculate_sync,           # 同步函数
    name="calculator",
    description="工具函数:执行两个数值的四则运算。",
    return_direct=False,
    coroutine=calculate_async,      # 异步函数(可选)
)
StructuredTool 通过 func 和 coroutine 参数分别接收同步和异步函数。当 Agent 在异步环境(如 langgraph dev)中运行时,会自动调用 coroutine;在同步环境中则调用 func。
方式三:BaseTool 子类
对于需要封装复杂业务逻辑的工具(如需要初始化外部客户端、管理资源生命周期),继承 BaseTool 类更合适:
from typing import Type
from langchain_core.tools import BaseTool
from pydantic import BaseModel, Field
from zai import ZhipuAiClient

class SearchArgs(BaseModel):
    query: str = Field(description="需要进行网络搜索的信息。")

class WebSearchTool(BaseTool):
    name: str = "search_tool"
    description: str = '搜索互联网上公开内容的工具'
    return_direct: bool = False
    args_schema: Type[BaseModel] = SearchArgs

    def _run(self, query: str) -> str:
        """同步执行"""
        zhipuai_client = ZhipuAiClient(api_key="xxx")
        response = zhipuai_client.web_search.web_search(
            search_engine="search_pro_quark",
            search_query=query,
        )
        # 处理搜索结果
        contents = []
        for item in response.search_result:
            contents.append(f"标题: {item.title}\n内容: {item.content}")
        return "\n\n".join(contents)
与 @tool 装饰器相比,BaseTool 子类将工具元信息(name、description、args_schema)和执行逻辑(_run)封装在一个类中,支持添加自定义属性和多个方法。如需异步支持,可重写 _arun 方法。
方式四:Chain 转 Tool
已有的 LCEL(LangChain Expression Language,LangChain 表达式语言)Chain 可以通过 as_tool() 方法直接转换为工具,无需重新编写逻辑:
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import PromptTemplate
from pydantic import BaseModel, Field

prompt = (
    PromptTemplate.from_template("帮我生成一个简短的,关于{topic}的报幕词。")
    + ", 要求: 1、内容搞笑一点;"
    + "2、输出的内容采用{language}。"
)

chain = prompt | llm | StrOutputParser()

class ToolArgs(BaseModel):
    topic: str = Field(description="报幕词的主题")
    language: str = Field(description="报幕词采用的语言")

runnable_tool = chain.as_tool(
    name='chain_tool',
    description='这是一个专门生成报幕词的工具',
    args_schema=ToolArgs
)
4.2 参数描述增强
@tool 装饰器默认只从 docstring 中提取工具描述,但 LLM 调用工具时需要理解每个参数的含义。以下三种方式可以为参数提供更精确的描述,帮助 LLM 正确传参。
args_schema:Pydantic 模型
使用 Pydantic BaseModel 定义参数 Schema,每个字段通过 Field(description=...) 描述参数含义:
from langchain_core.tools import tool
from pydantic import BaseModel, Field

class CalculateArgs(BaseModel):
    a: float = Field(description="第一个需要输入的数字")
    b: float = Field(description="第二个需要输入的数字")
    operation: str = Field(description="运算类型")

@tool('calculate', args_schema=CalculateArgs)
def calculate(a: float, b: float, operation: str) -> float:
    """工具函数:计算两个数据的运算结果"""
    # 函数体与 4.1 节方式一相同,此处聚焦参数描述方式
    ...
Annotated 类型注解
使用 Python Annotated 类型直接在参数上添加描述,无需额外定义 Schema 类:
from typing import Annotated
from langchain_core.tools import tool

@tool('calculate')
def calculate(
    a: Annotated[float, "第一个需要输入的数字"],
    b: Annotated[float, "第二个需要输入的数字"],
    operation: Annotated[str, "运算类型,只能是add,subtract,multiply和divide中任意一个。"]
) -> float:
    """工具函数:计算两个数据的运算结果"""
    # 函数体与 4.1 节方式一相同,此处聚焦参数描述方式
    ...
parse_docstring:从 docstring 提取
通过 parse_docstring=True 自动解析 Google 风格的 docstring,从 Args 部分提取参数描述:
from langchain_core.tools import tool

@tool('calculate', parse_docstring=True)
def calculate(a: float, b: float, operation: str) -> float:
    """执行两个数值的四则运算。

    Args:
        a (float): 第一个操作数。
        b (float): 第二个操作数。
        operation (str): 运算类型,必须为以下之一:add, subtract, multiply, divide。

    Returns:
        float: 返回两个数字的运算结果。
    """
    # 函数体与 4.1 节方式一相同,此处聚焦参数描述方式
    ...
注意事项:docstring 必须严格遵循 Google 风格格式,Args 段缩进和类型标注不能省略。
三种参数描述方式对比:
| 方式 | 优点 | 适用场景 |
|---|---|---|
args_schema | 参数校验与描述分离,可复用 Schema | 参数逻辑复杂,需要校验 |
Annotated | 描述紧贴参数定义,代码最简洁 | 参数简单,追求代码简洁 |
parse_docstring | 利用已有 docstring,无需额外代码 | 已有规范 docstring 的函数 |
4.3 高级特性
工具定义完成后,在实际开发中还会遇到一些进阶需求:获取运行时配置、读写 Agent 状态等。这些能力可以与上述任意定义方式搭配使用。
访问 RunnableConfig
工具函数可以通过声明 config: RunnableConfig 参数来获取运行时配置信息(如用户身份、API 密钥等)。LangGraph 会自动注入该参数,不会暴露给 LLM:
from langchain_core.runnables import RunnableConfig
from langchain_core.tools import tool

@tool
def get_user_info_by_name(config: RunnableConfig) -> dict:
    """获取用户的所有信息,包括:性别,年龄等"""
    # 从 config 中获取配置信息
    user_name = config['configurable'].get('user_name', '默认用户')
    print(f"调用工具,传入的用户名是: {user_name}")
    return {'username': user_name, 'sex': '男', 'age': 18}
RunnableConfig 不仅适用于 @tool,在 BaseTool._run() 和 _arun() 方法中同样可以通过参数获取。配置值由客户端调用时通过 config={"configurable": {...}} 传入(详见第五章 5.3 节)。
State 注入与 Command 更新
当工具需要读取或修改 Agent State 时,可以使用 InjectedState 注入当前状态,使用 Command 返回状态更新。这与第三章定义的 CustomState 直接关联:
from typing import Annotated
from langchain_core.messages import ToolMessage
from langchain_core.runnables import RunnableConfig
from langchain_core.tools import tool, InjectedToolCallId
from langgraph.prebuilt import InjectedState
from langgraph.types import Command

from agent.state import CustomState

@tool
def get_user_name(
    tool_call_id: Annotated[str, InjectedToolCallId],  # 注入工具调用 ID
    config: RunnableConfig
) -> Command:
    """获取当前用户的 username,以便生成祝福语句"""
    user_name = config['configurable'].get('user_name', '默认用户')
    # 返回 Command 更新状态
    return Command(update={
        "username": user_name,  # 更新状态中的 username
        "messages": [
            ToolMessage(
                content='成功的得到当前用户的username',
                tool_call_id=tool_call_id
            )
        ]
    })

@tool
def greet_user(state: Annotated[CustomState, InjectedState]) -> str:
    """在获取用户的 username 之后,生成祝福语句"""
    username = state['username']  # 从状态中获取用户名
    return f'祝贺你:{username}!'
get_user_name 通过 Command 同时更新了 username 和 messages 两个字段。其中 ToolMessage 必须携带 tool_call_id,与 LLM 发出的 AIMessage.tool_calls 配对,告知 Agent 该工具调用已完成。greet_user 则通过 InjectedState 读取状态中的 username 字段。
关键注入器:
| 注入器 | 用途 |
|---|---|
InjectedToolCallId | 注入工具调用的唯一 ID |
InjectedState | 注入当前 Agent 状态 |
InjectedStore | 注入长期存储实例 |
以上注入器和 RunnableConfig 一样,都是由 LangGraph 自动注入的参数,不会出现在工具的参数 Schema 中,LLM 不感知它们的存在。
4.4 工具定义方式总结
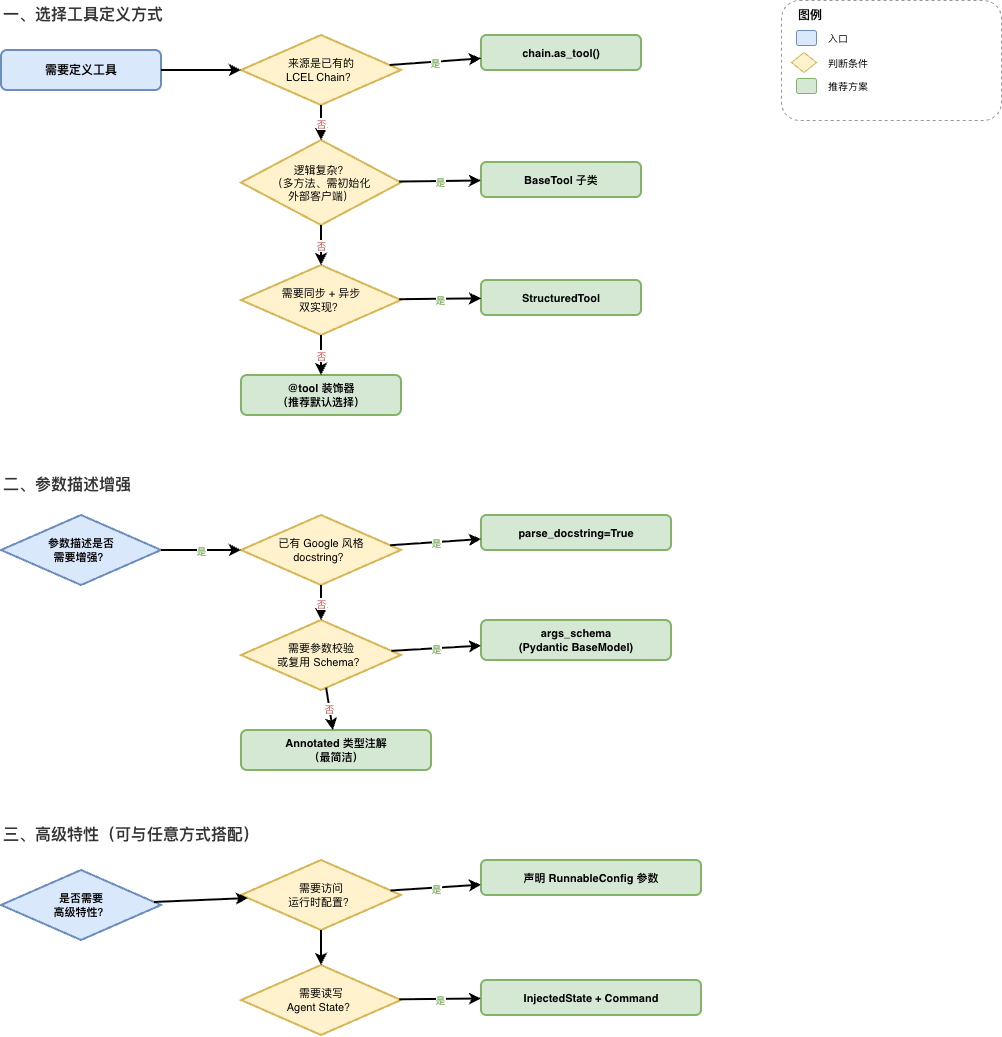
如何选择?
五、Agent 图的构建与配置
LLM、State、Tools 三大组件就绪后,需要将它们组装成一个可运行的 Agent 图。LangGraph 提供了 create_react_agent 将这些组件连接起来,自动构建 ReAct(推理-行动循环)工作流。
5.1 使用 create_react_agent 创建 Agent
LangGraph 提供了 create_react_agent 快速创建 ReAct 模式的 Agent:
新版本(
langgraph >= 0.3)中create_react_agent已更名为create_agent
from langchain_core.messages import AnyMessage
from langchain_core.runnables import RunnableConfig
from langgraph.prebuilt import create_react_agent
from langgraph.prebuilt.chat_agent_executor import AgentState

from agent.llm_config import llm
from agent.state import CustomState
from agent.tools.calculator import calculate
from agent.tools.chain_tool import runnable_tool
from agent.tools.web_search import WebSearchTool
from agent.tools.user_greeting import greet_user, get_user_name

search_tool = WebSearchTool()


# 提示词模板函数:由用户传入内容,组成一个动态的系统提示词
def prompt(state: AgentState, config: RunnableConfig) -> list[AnyMessage]:
    user_name = config['configurable'].get('user_name', '默认用户')
    system_message = f'你是一个智能助手,尽可能的调用工具回答用户的问题,当前用户的名字是: {user_name}'
    return [{'role': 'system', 'content': system_message}] + state['messages']


graph = create_react_agent(
    llm,
    tools=[calculate, runnable_tool, search_tool, get_user_name, greet_user],
    prompt=prompt,
    state_schema=CustomState
)
5.2 prompt 参数详解
prompt 参数支持三种形式:
# 1. 字符串形式(静态提示词)
graph = create_react_agent(llm, tools=[...], prompt="你是一个智能助手!")

# 2. 函数形式(动态提示词,可访问 state 和 config)
def prompt(state: AgentState, config: RunnableConfig) -> list[AnyMessage]:
    user_name = config['configurable'].get('user_name', '默认用户')
    return [{'role': 'system', 'content': f'用户是: {user_name}'}] + state['messages']

# 3. 返回消息列表的形式(注意必须拼接 state['messages'],否则用户输入会丢失)
def prompt(state: AgentState) -> list[dict]:
    return [
        {"role": "system", "content": "你是一个助手"},
    ] + state['messages']
5.3 Configurable 静态配置
通过 config['configurable'] 可以在运行时传递配置信息:
在 API 调用时传递配置:
# 客户端调用
client.runs.stream(
    None,
    "agent",
    input={"messages": [{"role": "human", "content": "你好"}]},
    config={"configurable": {"user_name": "阿远", "thread_id": "1"}}
)
在工具中访问配置:
@tool
def my_tool(config: RunnableConfig) -> str:
    user_name = config['configurable'].get('user_name', 'default')
    return f"当前用户: {user_name}"
在 prompt 函数中访问配置:
def prompt(state: AgentState, config: RunnableConfig) -> list[AnyMessage]:
    user_name = config['configurable'].get('user_name', '默认用户')
    # ...
六、记忆存储机制
Agent 图已经可以运行,但每次调用都是"无记忆"的——用户上一轮说了什么,Agent 不会自动记住。要让 Agent 具备会话连续性和跨会话记忆,需要引入存储机制。
Agent 的记忆存储分为两类:短期记忆(会话上下文)和长期记忆(跨会话持久化)。
6.1 存储类型对比
| 存储类型 | 类名 | 用途 | 生命周期 |
|---|---|---|---|
| 内存 | InMemorySaver | 临时会话 | 进程结束即消失 |
| SQLite | SqliteSaver | 持久化会话 | 文件持久化 |
| PostgreSQL | PostgresSaver | 生产级会话 | 数据库持久化 |
| Redis | RedisSaver | 分布式会话 | 可配置过期时间 |
| PostgresStore | PostgresStore | 长期记忆 | 跨会话持久化 |
6.2 短期记忆(Checkpointer)
Checkpointer(检查点存储器)负责在每个图执行步骤后保存状态快照,从而支持会话暂停、恢复和历史回溯。它解决的是 thread 内的短期记忆:例如同一会话中的消息上下文、执行历史和状态恢复。
from langgraph.checkpoint.memory import InMemorySaver
from langgraph.checkpoint.postgres import PostgresSaver
from langgraph.prebuilt import create_react_agent

# 内存存储(开发调试)
checkpointer = InMemorySaver()

# PostgreSQL 存储(生产环境,必须使用 with 上下文管理器)
DB_URI = 'postgresql://postgres:123123@localhost:5432/langgraph_db'
with PostgresSaver.from_conn_string(DB_URI) as checkpointer:
    checkpointer.setup()  # 第一次使用必须调用 setup 初始化表结构

    agent = create_react_agent(
        llm,
        tools=[...],
        checkpointer=checkpointer,
    )

    # 配置 thread_id 区分不同会话
    config = {"configurable": {"thread_id": "user_123"}}
6.3 长期记忆(Store)
长期记忆用于跨会话存储用户偏好、历史记录等信息。需要注意的是,store 不能替代 checkpointer:前者负责 跨会话的长期记忆,后者负责 thread 内的短期状态快照。因此,当 Agent 既需要多轮会话上下文,又需要长期记忆时,应同时配置 checkpointer 和 store。
from langgraph.checkpoint.postgres import PostgresSaver
from langgraph.store.postgres import PostgresStore
from langgraph.prebuilt import create_react_agent

DB_URI = 'postgresql://postgres:123123@localhost:5432/langgraph_db'

with (
    PostgresStore.from_conn_string(DB_URI) as store,  # 长期存储
    PostgresSaver.from_conn_string(DB_URI) as checkpointer,  # 短期存储
):
    store.setup()  # 第一次使用必须调用 setup

    agent = create_react_agent(
        llm,
        tools=[runnable_tool, search_tool],
        prompt="你是一个智能助手",
        checkpointer=checkpointer,  # 短期记忆:保存 thread 内状态快照
        store=store,                # 长期记忆:保存跨会话持久化数据
    )
6.4 获取和恢复状态
get_state 返回指定会话的当前最新状态(最后一次执行后的快照),适合查看 Agent 的最新上下文。get_state_history 返回该会话的全部历史状态列表(按时间倒序),适合回溯和调试每一步的中间结果。
config = {"configurable": {"thread_id": "1"}}

# 获取当前会话状态
state = agent.get_state(config)
print(state.values)  # 状态值

# 获取会话历史
history = list(agent.get_state_history(config))
for state in history:
    print(state.values)

# 恢复到特定状态(通过 config 中的 checkpoint_id 指定)
target_config = {"configurable": {"thread_id": "1", "checkpoint_id": "<目标 checkpoint_id>"}}
agent.update_state(target_config, state.values)
七、接口发布与远程调用
Agent 在本地调试通过后,下一步是将其发布为服务供外部调用。LangGraph Server 启动后,自动提供标准的 HTTP API 接口。
7.1 API 端点说明
| 端点 | 方法 | 说明 |
|---|---|---|
/threads | POST | 创建新会话 |
/threads/{thread_id} | GET | 获取会话信息 |
/runs/stream | POST | 流式调用 Agent |
/runs/wait | POST | 同步调用 Agent |
/threads/{thread_id}/state | GET | 获取会话状态 |
7.2 同步客户端调用
使用 langgraph-sdk 的同步客户端:
from langgraph_sdk import get_sync_client

client = get_sync_client(url="http://localhost:2024")

for chunk in client.runs.stream(
    None,  # Threadless run(无状态单次调用,不关联任何会话线程)
    "agent",  # 图名称,在 langgraph.json 中定义
    input={
        "messages": [{
            "role": "human",
            "content": "告诉我当前用户的年龄?",
        }],
    },
    stream_mode="messages",  # 流式模式
    config={"configurable": {"user_name": "阿远"}}
):
    if isinstance(chunk.data, list) and 'type' in chunk.data[0] and chunk.data[0]['type'] in ['AIMessageChunk', 'ai']:
        print(chunk.data[0]['content'], end='')
stream_mode 参数说明:
| 值 | 说明 |
|---|---|
messages | 逐 Token 流式输出 |
updates | 按节点返回更新 |
messages-tuple | 返回消息元组 |
7.3 异步客户端调用
from langgraph_sdk import get_client
import asyncio

client = get_client(url="http://localhost:2024")

async def main():
    async for chunk in client.runs.stream(
        None,
        "agent",
        input={
            "messages": [{
                "role": "human",
                "content": "给当前用户一个祝福语",
            }],
        },
        config={"configurable": {"user_name": "阿远"}}
    ):
        print(f"Event: {chunk.event}")
        print(chunk.data)

if __name__ == '__main__':
    asyncio.run(main())
7.4 带 Thread 的会话调用
使用 thread_id 维持会话上下文:
# 创建会话
thread = client.threads.create()
thread_id = thread["thread_id"]

# 发送消息(保持上下文)
client.runs.wait(
    thread_id,
    "agent",
    input={"messages": [{"role": "human", "content": "我叫阿远"}]},
)

# 后续消息会记住之前的上下文
client.runs.wait(
    thread_id,
    "agent",
    input={"messages": [{"role": "human", "content": "我叫什么名字?"}]},
)
八、LangGraph Studio 可视化调试
在开发过程中,仅靠日志排查 Agent 的执行路径效率较低。LangGraph Studio 是官方提供的可视化调试 IDE,启动 langgraph dev 后自动打开,可直观观察图的执行流程。
8.1 主要功能
- 图结构可视化:直观展示节点和边的连接关系
- 实时执行跟踪:逐步查看每个节点的输入输出
- 断点调试:在任意节点暂停执行
- 状态检查:查看当前 State 的完整内容
- 消息流查看:追踪 LLM 调用和工具执行
8.2 使用方式
# 启动服务(自动打开 Studio)
langgraph dev

# Studio 地址(浏览器自动打开)
# https://smith.langchain.com/studio/?baseUrl=http://127.0.0.1:2024
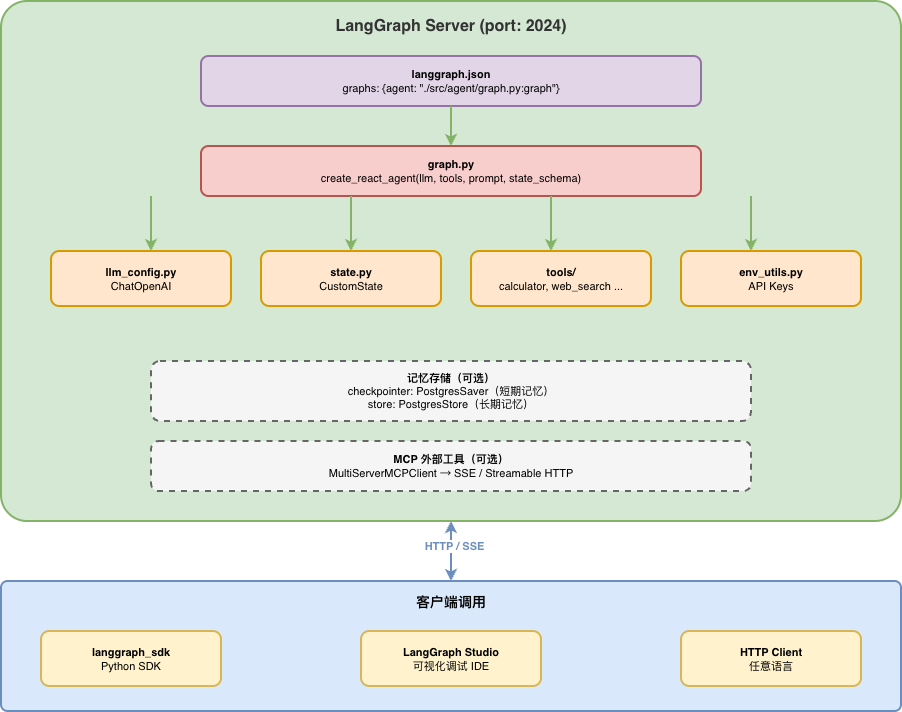
总结:技术架构全景图
写在最后
本文从 LangChain 的线性链路出发,引出 LangGraph 的设计动机,厘清核心概念与 Agent 的本质,然后从项目搭建到接口发布,完整走通了一个 LangGraph Agent 的开发流程。
核心决策回顾:
- 工具定义方式怎么选? — 简单工具用
@tool装饰器即可;需要同步/异步双实现选StructuredTool;复杂业务逻辑选BaseTool子类;复用已有 Chain 选as_tool()。参数描述增强和高级特性(RunnableConfig、State 注入)可以与任意定义方式搭配使用 - 记忆存储怎么选? — 开发阶段用
InMemorySaver;需要持久化用PostgresSaver(短期)+PostgresStore(长期);分布式场景用RedisSaver - Agent 的记忆如何分层? — 会话上下文和状态回溯依赖
checkpointer;跨会话持久化数据依赖store。两者职责不同,通常需要组合使用
下一篇文章将深入探讨 MCP 协议与 Agent 通信实战,敬请期待。
如有疑问或建议,欢迎留言讨论!

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐


 9
 0
- 0


 已为社区贡献2条内容

所有评论(0)