AI Agent 工程师 2026 潜力无限!12 步进阶路线图, Claude 全教程助你打造生产级 Agent
导读:这是完整的 12 步路线图,贯穿决定 Agent 能否真正工作的七大支柱——上下文(Context)、工具(Tools)、记忆(Memory)、循环(Loops)、图(Graphs)、支撑框架(Harness)、评估(Evals)——每一步都配有一个经过验证的 Claude 工作流。

引言:Demo 能跑,不等于生产可用
前沿模型在 SWE-bench Verified 上一年内从 30% 涨到了 80% 以上。编码 Agent 取得了巨大、可衡量的进步。
与此同时,只有 17% 的高管表示他们的公司已全面采用 AI Agent。
Agent 会失败,因为上下文膨胀;因为循环永远不收敛;因为没人能衡量上周的改动是否让事情变好。 Demo 在你自己的机器上跑得通。生产环境是另一种动物。

这 12 步路线图贯穿把「能跑」与「能生产」区分开来的七大支柱——每一步都有各自的失败模式、各自的 Claude 工作流、以及如果你跳过它就会悄悄毁掉 Agent 的方式。
这里有一个让其余内容连贯起来的重新框定:这不是七项独立技能,而是一个技能在七个维度上的投影。
- 坏的上下文会破坏循环。
- 没有评估的循环永远不会收敛到你能信任的结果。
- 没有评估的图,放大的是你的错误而不是你的吞吐量。
- 没有支撑框架的记忆,会话一结束就蒸发。
- 没有上下文管理的工具,会在工作开始前就淹没窗口。
也就是说,孤立地学习它们毫无用处——但它们存在依赖顺序:先基础,再执行,最后可靠性。这 12 步正是这样排布的。
- Context——先看清实际加载了什么
Karpathy 的框架值得记住:模型是 CPU,上下文窗口是 RAM。上下文工程就是往 RAM 里精确装入下一步需要的东西——不多不少。

一个重新框定一切的数字:在 Claude Code 里,你打第一个字符之前大约要加载 7,850 个 token——系统提示词、自动记忆、技能描述、CLAUDE.md、环境信息、MCP 工具名。

你真正的提示词只有大约 45 个 token。所有人都在优化那 45 个,却从没人打开那 7,850 个。
/context 会按类别打印你的真实分解,告诉你哪些记忆文件被加载,并标记哪个工具调用吃掉了最多 token。
要盯两个数字:记忆文件(过大意味着 CLAUDE.md 超重)和剩余空间。配合 /memory 查看实际参与的文件。
- Context——先砍,再分层
Anthropic 为 Claude 5 那一代删掉了 Claude Code 系统提示词 80% 以上的内容,编码评估实测零损失。
大部分上下文并不是错的——它是写给更弱模型的指导,如今只花钱买 token,还迫使 Claude 在开工之前先调和矛盾。

两条原则让裁剪变得安全:
-
按块删除,不要按行删除
——单独一句话埋在评估的噪声底里,什么都说明不了。
-
把绝对指令变成原则
:与其说「永远不要写多行注释」,不如说「写出像周围代码一样的代码」——匹配它的注释密度、命名和习惯。
规则给出一个固定答案;原则给 Claude 一种通过阅读你的仓库找到正确答案的方法。
-
幸存下来的内容放进树,而不是滚动条。
Anthropic 的指导是一个硬数字:项目 CLAUDE.md 保持在 200 行以内,只放 Claude 无法推断的坑。
其余一切变成技能(描述在启动时加载、正文在调用时加载)或路径限定规则(只在读取匹配文件时加载)。
payments-api
Subscription billing and invoicing for the web app.
Gotchas
// Non-obvious. Claude cannot infer these by reading the repo.
- All shared types live in
src/types.ts— one monolithic file. Moneyis integer cents, never a float.- Webhook retries must stay idempotent — provider replays for 72h.
db/legacy/is frozen. Read it, never edit it.
Deeper guides
- Verification →
.claude/skills/verify/ - Releases →
.claude/skills/deploy/
// NOT here: directory tree, framework, test runner, language
// version. Claude reads those from the repo itself.
- Tools & MCP——Agent 能触达什么
工具是 Agent 触碰世界的方式,而工具描述本身就是上下文——这让它成为「Agent 能做什么」与「Agent 能负担多少认知」之间的枢纽。

旧建议是用示例教工具。
如今反过来了:对当前模型来说,示例会把 Claude 约束在示例所描述的探索空间里。要设计富有表达力的参数。
一个 pending | in_progress | completed 的状态枚举,不用任何示例就能教完整个生命周期——类型本身就是文档。
Anthropic 在 SWE-bench Verified 上达到 SOTA,一部分靠的是对工具描述的精细打磨,而不是换模型。

而延迟加载优于全量倾倒。 Claude Code 只加载 MCP 工具名——大约 120 个 token——通过工具搜索按需抓取 schema。
对工具描述做检索而不是全部加载,选择准确率大约提升三倍。
这让描述成为发现面:要说清工具在什么场景适用,而不只是它做什么。 一个 Claude 找不到的工具,等于你没有发布它。
@mcp.tool()
def find_stalled_shipments(hours: int = 24) -> list[dict]:
“”“Shipments with no scan event in N hours.
Use when ops asks what is stuck, or before an escalation review.”“”
return query(STALLED_SQL, hours)
@mcp.tool()
def reroute(shipment_id: str, hub: str, reason: str) -> dict:
“”“Reroute a shipment. Writes an audit row — compliance
requires a reason on every manual intervention.”“”
return post_with_audit(shipment_id, hub, reason)
“Use when…” is the discovery surface for tool search.
reason: str is required, so the audit trail cannot be skipped.
The type enforces what a paragraph of instructions would only ask for.
- Memory——什么能活过窗口
每个长任务最终都会超过一个窗口。
边界处发生什么是大多数人从未做出的设计决策——他们让自动压缩去猜,然后奇怪为什么 Agent 忘了一小时前说过的约束。
机制具体且值得记住:项目根 CLAUDE.md 和自动记忆会从磁盘重新注入。

但用 path: 限定的规则和嵌套的 CLAUDE.md 活在消息历史里——它们会被摘要掉,直到再次读到匹配文件才回来。
被调用的技能正文会回来,上限是每个技能 5k、总计 25k token,最旧的先丢、从尾部截断——所以任何关键内容必须放在 SKILL.md 顶部。

最可靠的动作是计算领域最古老的那招:写进文件。
计划文件、进度日志、Agent 边干边改的笔记。它不占窗口、存活于磁盘、扛得住压缩。
也要刻意压缩——/compact focus on the auth bug 会保留你选择的内容;当下一任务不依赖过去二十条消息时,/clear 被严重低估。
- Loops——何时停止
Agent 循环是 行动→观察→决策→重复。全部工程问题都住在最后一步:它怎么知道自己做完了?

放任自流,模型会朝两个方向答错——对做了一半的活宣布胜利,或者在三轮迭代前就完成的事情上无限空转。
两者都不是更好的提示词能修好的,因为都是结构性问题。停止条件应该放在模型判断之外的代码里。 对有界工作,那是测试门或 schema 检查。
对规模未知的探索任务,收敛模式是「循环到干涸」:持续运行,直到连续 K 轮都没有新发现。

有一个细节决定成败,几乎所有人第一次都会搞错:去重要对「见过的所有东西」做,而不是对「已确认的结果」做。
否则被否决的发现每一轮都会重新出现,循环永远不会干涸——你造出了一台永远花钱重新发现同一批死胡同的机器。
const seen = new Set(); const confirmed = []; let dry = 0;
while (dry < 2) { // stop after 2 empty rounds
const found = await runFinders();
const fresh = found.filter((b) => !seen.has(key(b)));
if (!fresh.length) { dry++; continue; }
dry = 0;
fresh.forEach((b) => seen.add(key(b)));
// ^ dedupe against SEEN, not against confirmed.
//   Backwards, and this loop never terminates.

confirmed.push(...(await verify(fresh)));
}
- Loops——谁来检查答案
收敛的循环也只会收敛到模型当时相信的东西。解法是验证器——一个独立于模型自身判断、唯一任务就是试图杀死发现的组件。

活下来的,通过。活不下来的,到不了答案。
三个值得掌握的范式:
-
对抗式验证
:对每个发现,孵化 N 个独立怀疑者去反驳它;只有多数派存活才保留。
-
视角多样化验证
:给每个验证器一个不同透镜——正确性、安全性、能否复现——因为多样性会抓住 N 个相同检查永远抓不到的失败模式。
-
评审团
:从不同角度生成 N 个候选,用并行评审打分,从胜者合成,同时嫁接亚军的精华。
› For each finding, spawn three verifiers - correctness, security,
reproducibility. Accept only what survives two of three.● 6 findings → 18 verifier agents, running in parallel
✓ missing auth on /invoices/:id 3/3 — accepted
✓ race in webhook retry 2/3 — accepted
● “unsafe regex in validator” 0/3 — killed
● “N+1 query in dashboard” 1/3 — killed2 of 6 findings were confident and wrong. The loop caught them,
not your reviewer, and not your users.
注意这指向哪里。 验证器就是内联运行的评估——与第三层同样的纪律,只不过按结果应用而不是按发布应用。建好验证器的团队会发现第 11 步容易得多,因为他们已经写下了「好」是什么意思。
- Graphs——什么该并行
大多数人把 Agent 写成一条直线——第一步、第二步、第三步,各自礼貌地等前一步。然后他们发现一半步骤根本不需要等。
节点是一份工作单元;边意味着这个输出喂给那个输入。 没有数据跨越,就没有边——等待是纯粹的浪费。

主力形状是菱形:扇出获取广度,用普通代码归约,用一个 Agent 合成。
归约步骤值得强调,因为钱从那里漏掉——展平去重是 flatMap 加一个 Set,不是 Agent。
边是免费的。把 Agent 花在判断上,而不是管道上。
天花板真的很高。 Claude Code 的动态工作流可以在一次运行中协调多达 1,000 个并行子 Agent,而编排成本是零模型 token——因为它是脚本,不是对话。
› Run a workflow to audit every route under src/routes/ for missing
auth. One agent per route file, verify each finding before reporting.
● Claude wrote an orchestration script · launching…
✓ Scope 1/1 ✓ Fan-out 18/18 one agent per file
◯ Verify 11/18 3-vote skeptics per finding
○ Synthesize 0/1 your session stays responsive — the fleet runs
in the background
这个架构正是一个团队如何在六天内把 Bun 运行时约 96 万行代码从 Zig 移植到 Rust、且 99.8% 的测试仍然通过的原因。
- Graphs——形状的成本
拓扑不是装饰——它是你在延迟和花费上最大的杠杆,两个选择承担了其中大部分。

第一,parallel() 对比 pipeline()。 parallel() 的屏障让所有东西等最慢的节点完成后,下一阶段才开始。
pipeline() 让每个条目独立流过所有阶段——条目 A 可以在阶段 3,而 B 还在阶段 1。
默认用 pipeline。 只有某个阶段真的需要所有先前结果同时在场时才伸手拿屏障,比如跨集合去重。「感觉更干净」不是理由;屏障延迟是真实、可测量、被浪费的时间。
第二,按节点分层模型。 每个子 Agent 默认继承你的会话模型,除非脚本覆盖——所以一个大任务默认全部按最高档计费。

有界、重复的节点——提取这个字段、分类这个工单——应该放便宜模型;真正发生判断的归并节点保持高档。
一百个便宜的扇出节点喂一个顶级合成,成本只是同一任务全平跑的零头,最终质量相同。
- Harness——熬过会话死亡
Anthropic 把问题框得很妙:长任务是「由轮班工程师组成的软件项目,每位新工程师到来时对上一班毫无记忆」。

单靠压缩解决不了。即使前沿模型在「克隆 claude.ai」这样的任务上跨上下文窗口循环,也会失败——而且失败在两种具体、可复现的方式上。
第一, Agent 试图一次性把应用写完,实现到一半耗尽上下文,留给下一个会话一个半成品、无文档、需要逆向工程的特性。
第二, 项目后期,Agent 环顾四周,看到真实进展,就宣布工作完成。
两者都在任何编码开始之前被修复:一个初始化 Agent 只运行一次,搭建环境——一个启动开发服务器的 init.sh、一份进度日志、一个初始 git commit、一份 JSON 特性清单——claude.ai 克隆版有 200 多条,每一条都标记为失败。
{
“category”: “functional”,
“description”: “New chat button creates a fresh conversation”,
“steps”: [
“Navigate to main interface”,
“Click the ‘New Chat’ button”,
“Verify a new conversation is created”,
“Check that chat area shows welcome state”
],
“passes”: false
}
// 200+ of these, all starting false. Agents may ONLY flip passes.
// “It is unacceptable to remove or edit tests” — deliberately strong
// wording, because a model that CAN edit the spec WILL edit the spec.
有一个细节值得直接偷走:他们选了 JSON 而不是 Markdown 放那份清单,因为模型重写 JSON 的可能性实测更低。
- Harness——一个会话一个增量
环境搭好后,每个编码会话得到一份契约:先摸清状况、挑恰好一个特性、像用户一样验证它、让仓库保持干净。

「干净」的意思和真实团队一样——没有大 bug、代码有序、下一个工程师不用清理别人的烂摊子就能开工。
摸底仪式是机械的,每次都省 token: pwd、读进度文件、读 git log、读特性清单、跑 init.sh、在动任何东西之前先测试基础功能是否正常。
最后一项检查比听上去重要得多——没有它,Agent 在一个坏掉的应用上开始新特性,只会让坏得更深。
关于「标记完成」:Claude 的倾向是完成改动、跑几个单元测试、就宣布结束,从不端到端检查这个特性。
[Assistant] Getting my bearings on the current state.
[Tool] bash — pwd
[Tool] read — claude-progress.txt
[Tool] read — feature_list.json
[Tool] bash — git log --oneline -20
[Tool] bash — ./init.sh start the dev server
[Assistant] Verifying fundamentals before touching anything…
✓ core chat, theme switching, conversation loading all pass
[Assistant] Picking the highest-priority failing feature.
no guessing. no archaeology. the previous shift left notes.
给它真正的测试工具,要求它像人类用户那样验证——浏览器自动化、真实点击。
就这一个要求就在 Anthropic 的实验里大幅提升了性能,抓住了仅从代码看不见的 bug。
- Evals——一个数字,而不是一种感觉
引爆点总是同一句话:用户反馈改动后 Agent 感觉更差了,而团队除了猜-试之外没有任何验证手段。

没有评估,调试就是被动的——等抱怨、手动复现、修复、祈祷没有别的东西回归。你分不清真回归和噪声。
起步要比你想的更小。 团队拖延是因为想象需要几百个任务;从真实失败中挑 20–50 个就是很好的开始,因为早期改动的效应量很大。

从你已经在手动测试的东西、bug 追踪器、支持队列里取材。 写任务时确保两位领域专家能独立得出相同的结论——任务里的歧义会变成指标里的噪声。
并且要构建平衡的集合: 测试行为「应该触发」和「不应该触发」两种情况,否则你会优化出一个什么都搜的 Agent。
刻意组合三种评分器:
-
基于代码
——快、便宜、客观;能用就用。
-
基于模型
——用 rubric 处理细微差别,对照人类校准,理想情况是每个维度一个独立评委,而不是一个评委给所有东西打分。
-
人工
——黄金标准,只用于校准其他两者。
并且要评 Agent 产出的结果,而不是它走过的路径: 检查确切的工具调用序列很脆弱,因为 Agent 经常找到你没预料到的有效路径。
task:
id: “fix-auth-bypass_1”
desc: “Fix authentication bypass when password field is empty”
graders:
- type: deterministic_tests # fast, objective, reproducible
required: [test_empty_pw_rejected.py]
- type: llm_rubric # nuance tests can’t capture
rubric: prompts/code_quality.md
- type: static_analysis
commands: [ruff, mypy, bandit]
- type: state_check # the OUTCOME, not the claim
expect: { security_logs: { event_type: “auth_blocked” } }
tracked_metrics:
- type: transcript
metrics: [n_turns, n_toolcalls, n_total_tokens]
The agent says “fixed”. The state_check decides whether it was.
Grade outcomes, not announcements.
- Evals——让数字保持诚实
没人读的套件,是没人该信的数字。 在读完许多次试验的转录之前,你不会知道评分器是否有效——任务失败时,转录会告诉你 Agent 是真错了,还是你的评分器拒绝了一个有效解。

失败应该让人感觉公平:哪里错了、为什么错,一目了然。
两个陷阱会让好 Agent 看起来很糟:
-
多次试验 0% 通过率通常意味着任务坏了,而不是 Agent 不行。
Opus 4.5 最初在 CORE-Bench 上只有 42%——然后研究者发现僵化的评分拒绝了「96.12」(它期望「96.124991…」)、含糊的规格、不可复现的任务。修复之后:95%。
-
另一个陷阱是饱和
——100% 的评估能追踪回归,但给你没有可爬的山丘,真实能力增长开始表现为噪声。
然后把两个指标分开。 pass@k 是 k 次尝试至少成功一次的概率——它随 k 上升。pass^k 是 k 次全部成功的概率——它快速下降。单次 75% 成功率时,三次全部通过只有大约 42%。
一次成功就够的场景用 pass@k;任何面向用户的东西用 pass^k——用户期望它每次都工作。
› Run the suite against the new model and compare to baseline.
● 47 tasks × 3 trials · 141 runs · parallel
capability suite pass@1 61% → 74% +13
regression suite pass@1 99% → 99% held
consistency pass^3 52% → 68% +16
● 2 regressions: refund_partial, escalation_tone →
transcripts written to ./eval-results/failures/
the upgrade decision took an afternoon, not three weeks
最后,让它成为例行公事。 把套件接进 CI,每次改动、每次模型升级都跑。
这就是把新模型发布从数周手动测试变成一天跑完套件读 diff 的东西——也是没有评估的团队永远追不上的复利优势。
7 个可以直接让 Claude 干的任务——每个支柱一个
-
打开你从未看过的窗口。
先测量,再裁剪。记忆文件数字过大意味着 CLAUDE.md 超重——一条命令诊断,一个下午修复。
› /context 然后 /doctor -
审计你的工具描述。
每条描述都应该说清工具何时适用,而不只是做什么。那句话就是发现面——没有它,接上了的工具也是 Claude 永远不选的工具。
› 审查这个 MCP 服务器里的每条工具描述。给每条加一句「use when」,并收紧参数类型。 -
把状态搬到文件系统。
让 Claude 维护一份边干边改的计划文件。它活在磁盘上所以扛得过压缩——长任务不再半路丢线索。
› 开始前把计划写进 plan.md,每步之后更新。每次恢复时重读。 -
给你的循环装上验证器。
挑一个让 Claude 自己决定「做完了」的任务。加一个外部检查,看看第一个答案有多少次活不过三个怀疑者。
› 每次修复后,孵化三个验证器——正确性、安全性、可复现性。只接受三过二。 -
把一个线性任务变成扇出。
找一个你顺序循环文件或来源的任务。每项一个 Agent、同时跑,然后一次归并。墙钟时间差就是全部课程。
› 运行一个工作流审计 src/routes/ 下的每条路由。每个文件一个 Agent,验证每个发现,然后合成。 -
搭建一个多会话项目。
在长构建开始前,让 Claude 写 init.sh、进度日志、一份所有条目都标记失败的 JSON 特性清单。
› 扮演初始化 Agent:写 init.sh、claude-progress.txt、feature_list.json,覆盖所有需求,全部 passes:false。 -
把上周的 bug 变成套件。
打开你的 bug 追踪器,把真实失败转成 20 个有明确通过标准的任务。这个套件比你本季度能采纳的任何框架都值钱。
› 这是 20 个真实失败。把每个写成 eval 任务,尽量用确定性评分器,不行就上 rubric。
最后
我在一线科技企业深耕十二载,见证过太多因技术更迭而跃迁的案例。那些率先拥抱 AI 的同事,早已在效率与薪资上形成代际优势,我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在大模型的学习中的很多困惑。
我整理出这套 AI 大模型突围资料包:
- ✅AI大模型学习路线图
- ✅Agent行业报告
- ✅100集大模型视频教程
- ✅大模型书籍PDF
- ✅DeepSeek教程
- ✅AI产品经理入门资料
完整的大模型学习和面试资料已经上传带到CSDN的官方了,有需要的朋友可以扫描下方二维码免费领取【保证100%免费】👇👇
为什么说现在普通人就业/升职加薪的首选是AI大模型?
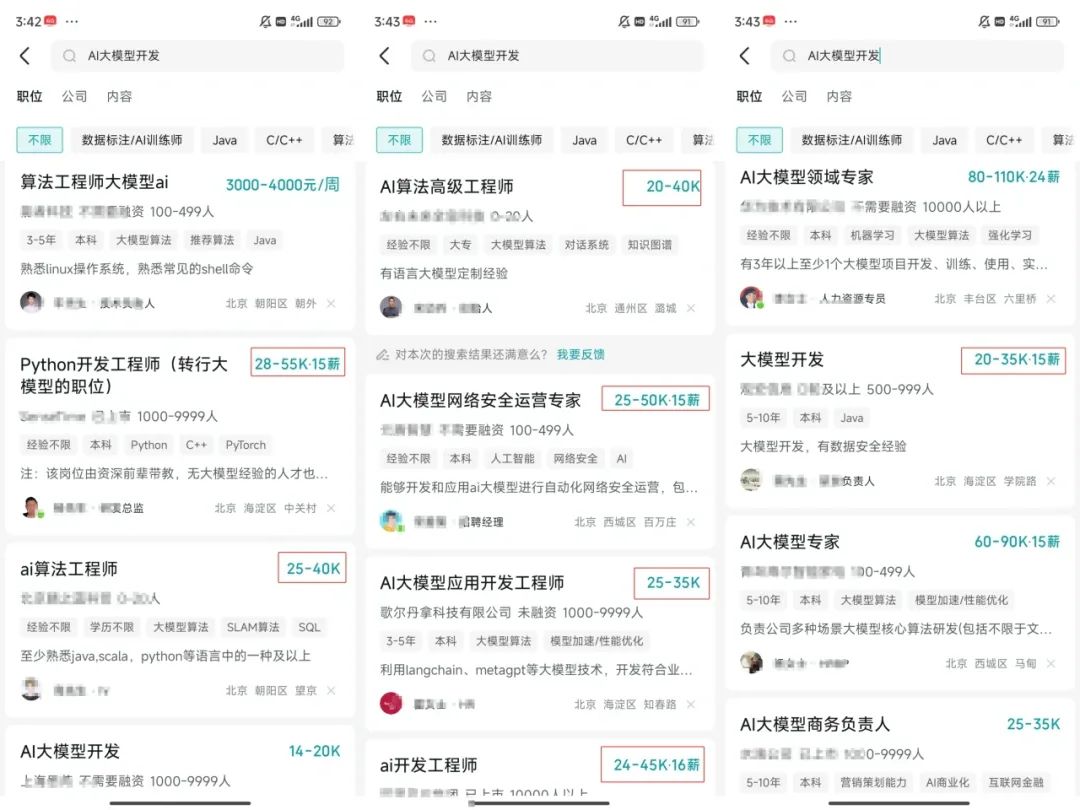
人工智能技术的爆发式增长,正以不可逆转之势重塑就业市场版图。从DeepSeek等国产大模型引发的科技圈热议,到全国两会关于AI产业发展的政策聚焦,再到招聘会上排起的长队,AI的热度已从技术领域渗透到就业市场的每一个角落。
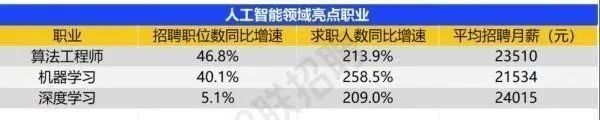
智联招聘的最新数据给出了最直观的印证:2025年2月,AI领域求职人数同比增幅突破200% ,远超其他行业平均水平;整个人工智能行业的求职增速达到33.4%,位居各行业榜首,其中人工智能工程师岗位的求职热度更是飙升69.6%。
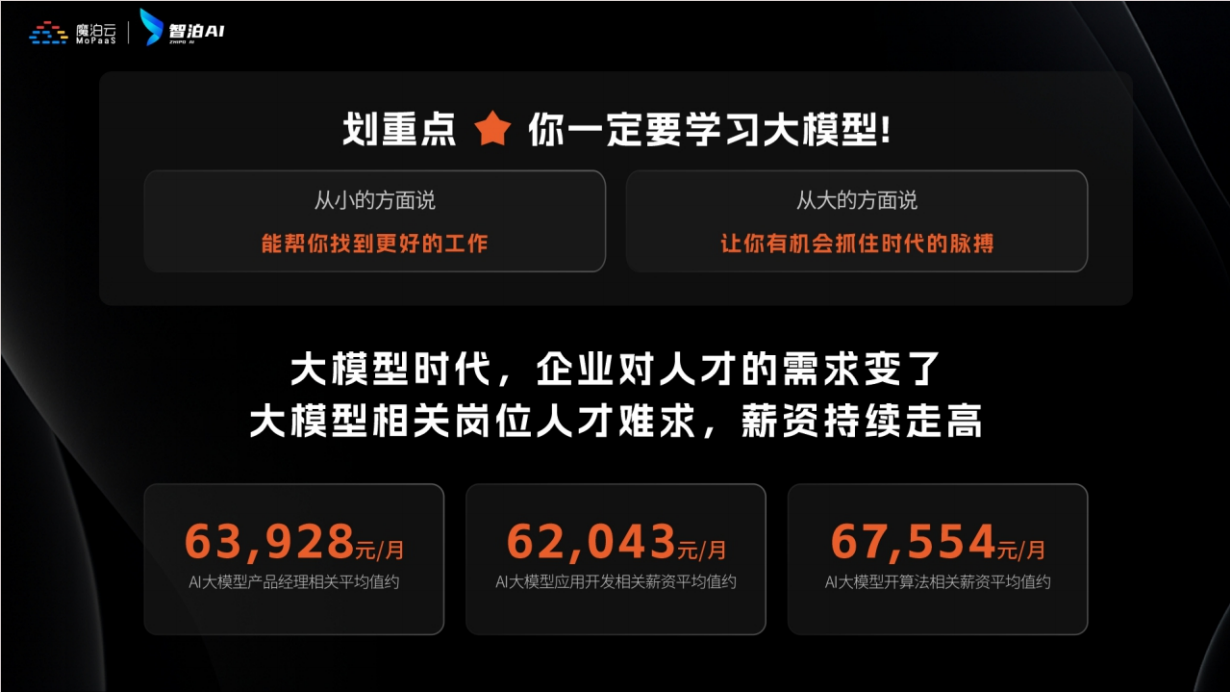
AI产业的快速扩张,也让人才供需矛盾愈发突出。麦肯锡报告明确预测,到2030年中国AI专业人才需求将达600万人,人才缺口可能高达400万人,这一缺口不仅存在于核心技术领域,更蔓延至产业应用的各个环节。
资料包有什么?
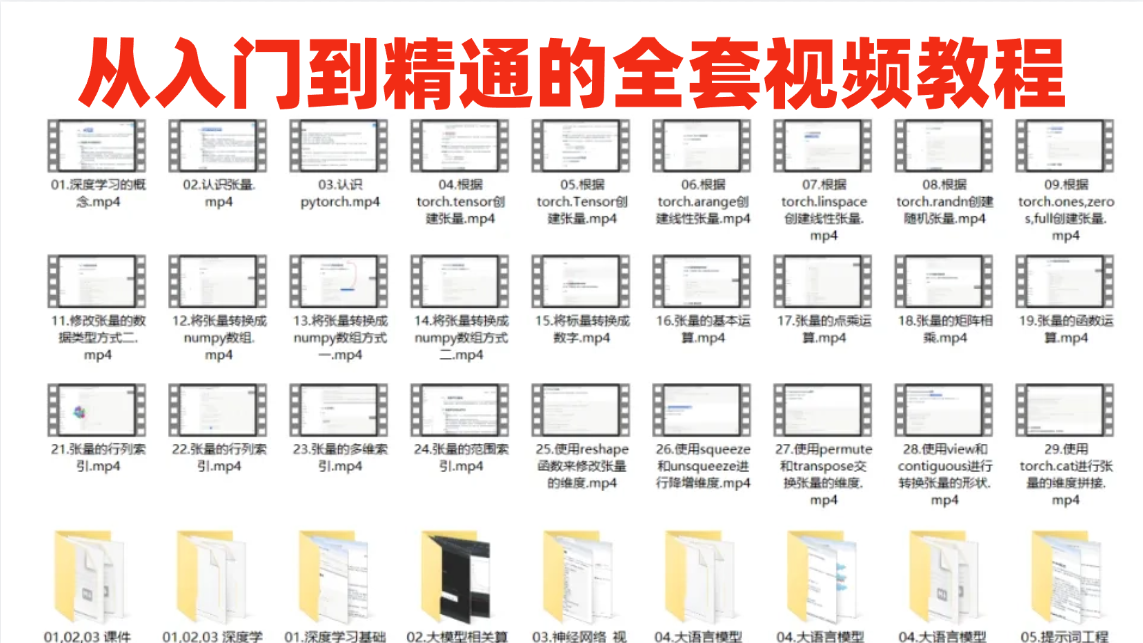
①从入门到精通的全套视频教程⑤⑥
包含提示词工程、RAG、Agent等技术点
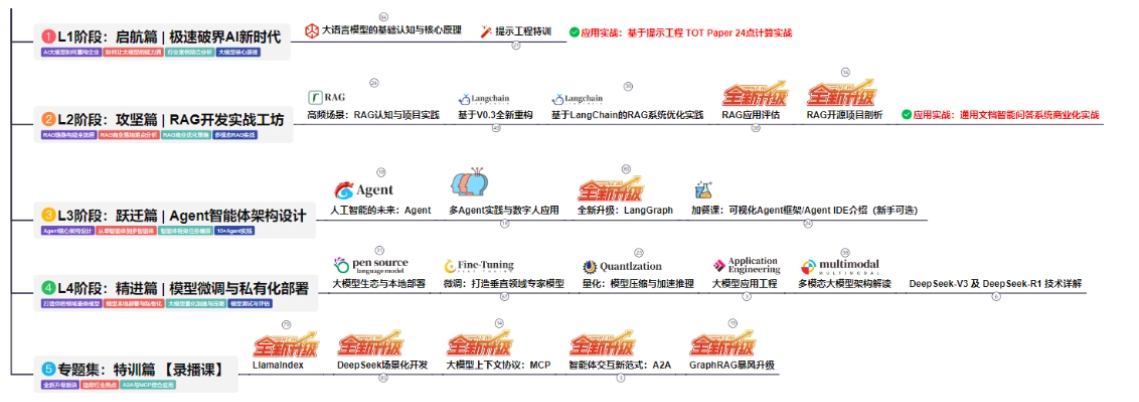
② AI大模型学习路线图(还有视频解说)
全过程AI大模型学习路线
③学习电子书籍和技术文档
市面上的大模型书籍确实太多了,这些是我精选出来的
④各大厂大模型面试题目详解
⑤ 这些资料真的有用吗?
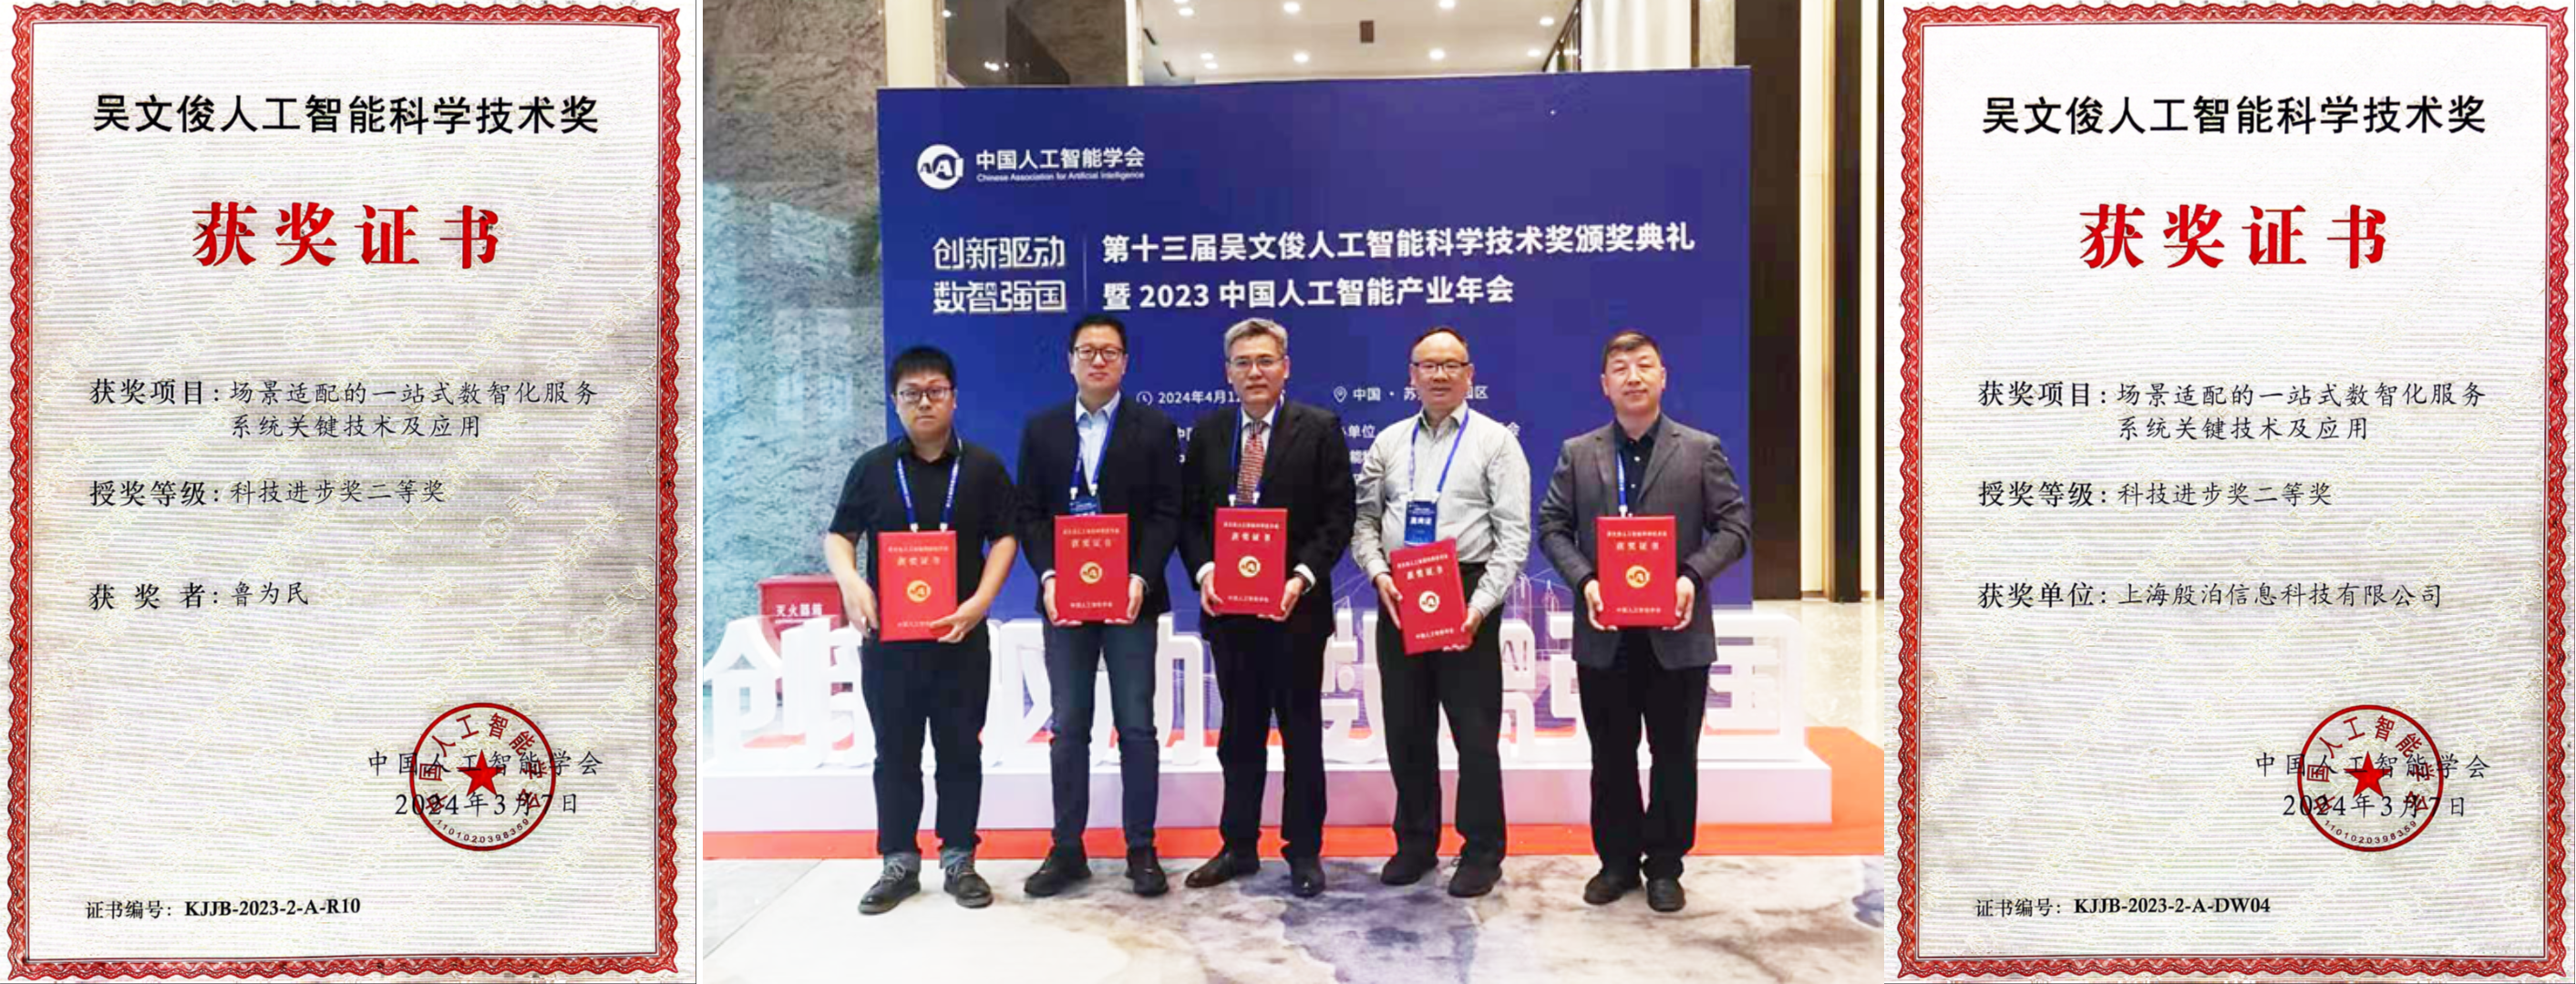
这份资料由我和鲁为民博士共同整理,鲁为民博士先后获得了北京清华大学学士和美国加州理工学院博士学位,在包括IEEE Transactions等学术期刊和诸多国际会议上发表了超过50篇学术论文、取得了多项美国和中国发明专利,同时还斩获了吴文俊人工智能科学技术奖。目前我正在和鲁博士共同进行人工智能的研究。
所有的视频教程由智泊AI老师录制,且资料与智泊AI共享,相互补充。这份学习大礼包应该算是现在最全面的大模型学习资料了。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
智泊AI始终秉持着“让每个人平等享受到优质教育资源”的育人理念,通过动态追踪大模型开发、数据标注伦理等前沿技术趋势,构建起"前沿课程+智能实训+精准就业"的高效培养体系。
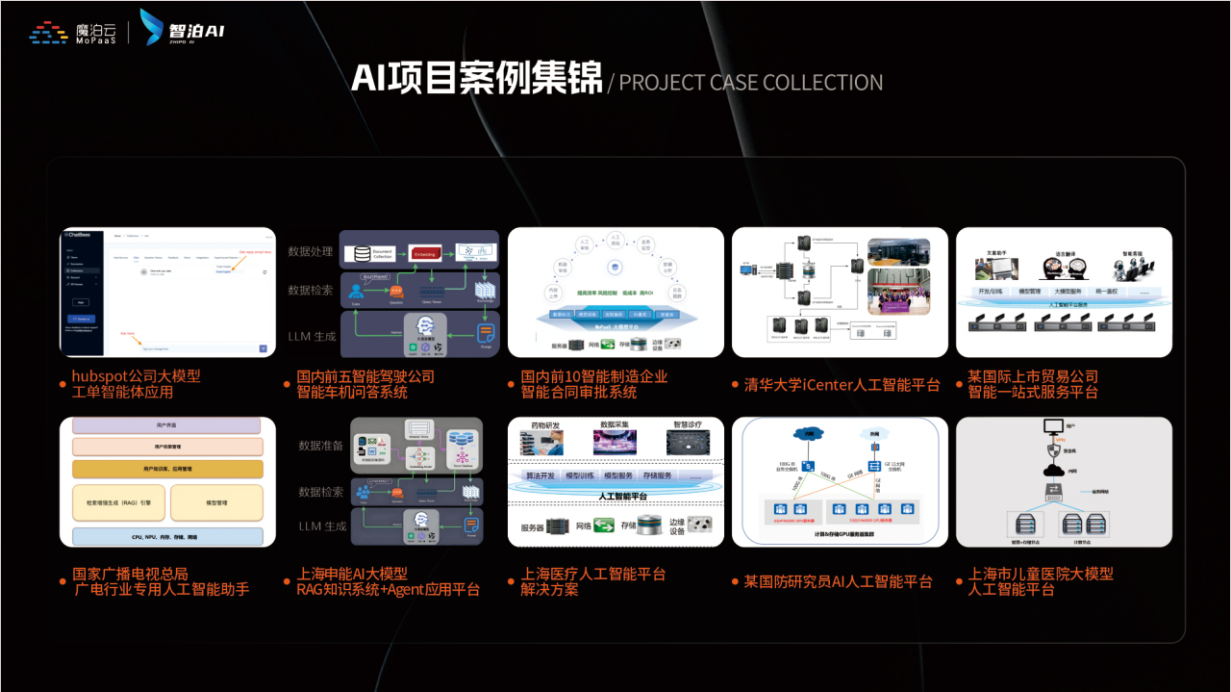
课堂上不光教理论,还带着学员做了十多个真实项目。学员要亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事!
如果说你是以下人群中的其中一类,都可以来智泊AI学习人工智能,找到高薪工作,一次小小的“投资”换来的是终身受益!
应届毕业生:无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。
零基础转型:非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界。
业务赋能 突破瓶颈:传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型。
👉获取方式:
😝有需要的小伙伴,可以保存图片到wx扫描二v码免费领取【保证100%免费】🆓**

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐

 2
 0
- 0


 已为社区贡献171条内容

所有评论(0)