大数据基于python房价的预测与分析系统
数据收集与清洗
从公开数据源(如链家、安居客、政府公开数据)爬取或下载房价相关数据,包括房屋面积、地理位置、房龄、周边设施等。使用Python的pandas库进行数据清洗,处理缺失值、异常值和重复数据。
import pandas as pd
data = pd.read_csv('house_price.csv')
data.drop_duplicates(inplace=True)
data.fillna(data.mean(), inplace=True)
特征工程
提取关键特征并进行标准化或归一化处理。对分类变量(如地理位置)进行独热编码,数值变量(如面积)进行标准化。
from sklearn.preprocessing import StandardScaler, OneHotEncoder
scaler = StandardScaler()
data[['area', 'age']] = scaler.fit_transform(data[['area', 'age']])
encoder = OneHotEncoder()
location_encoded = encoder.fit_transform(data[['location']]).toarray()
模型选择与训练
选择适合回归任务的模型(如线性回归、随机森林、梯度提升树)。将数据集分为训练集和测试集,进行模型训练与评估。
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestRegressor
X_train, X_test, y_train, y_test = train_test_split(features, target, test_size=0.2)
model = RandomForestRegressor()
model.fit(X_train, y_train)
模型评估
使用均方误差(MSE)、均方根误差(RMSE)和R²分数评估模型性能。
from sklearn.metrics import mean_squared_error, r2_score
y_pred = model.predict(X_test)
mse = mean_squared_error(y_test, y_pred)
r2 = r2_score(y_test, y_pred)
可视化分析
使用matplotlib或seaborn绘制房价分布、特征重要性、预测结果与实际值的对比图。
import matplotlib.pyplot as plt
plt.scatter(y_test, y_pred)
plt.xlabel('Actual Price')
plt.ylabel('Predicted Price')
plt.title('Actual vs Predicted Prices')
plt.show()
系统部署
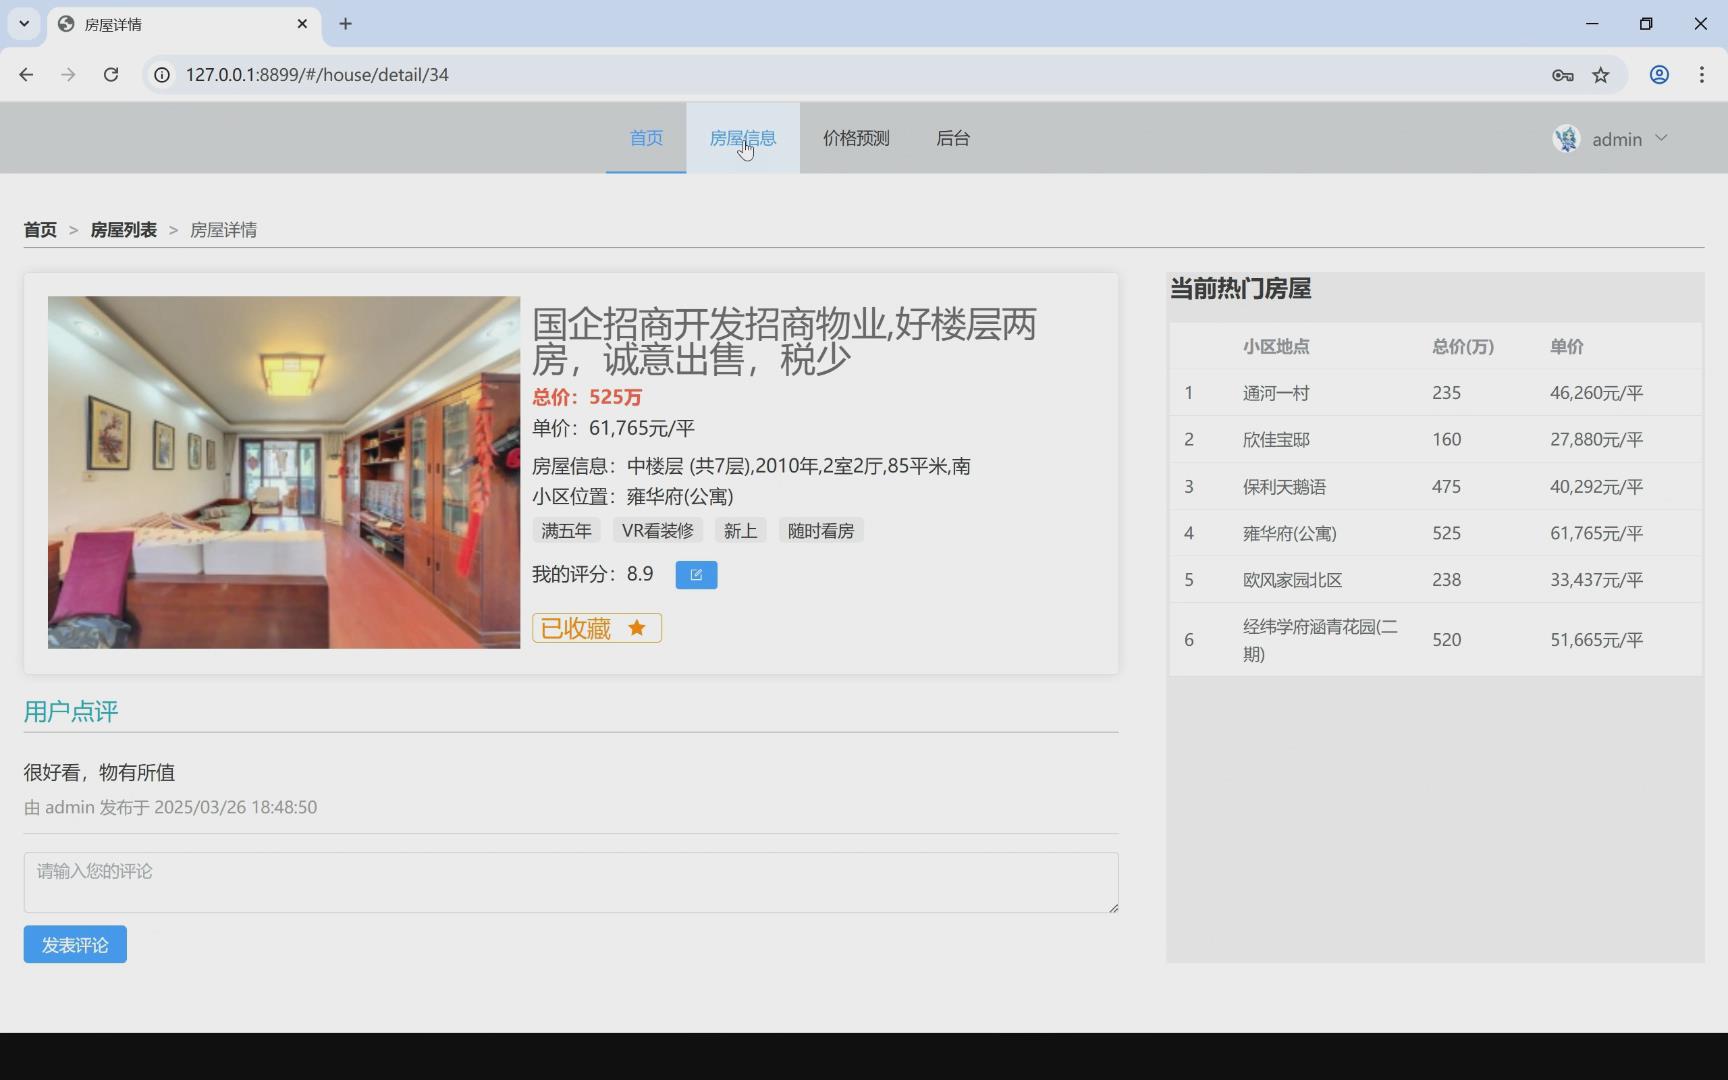
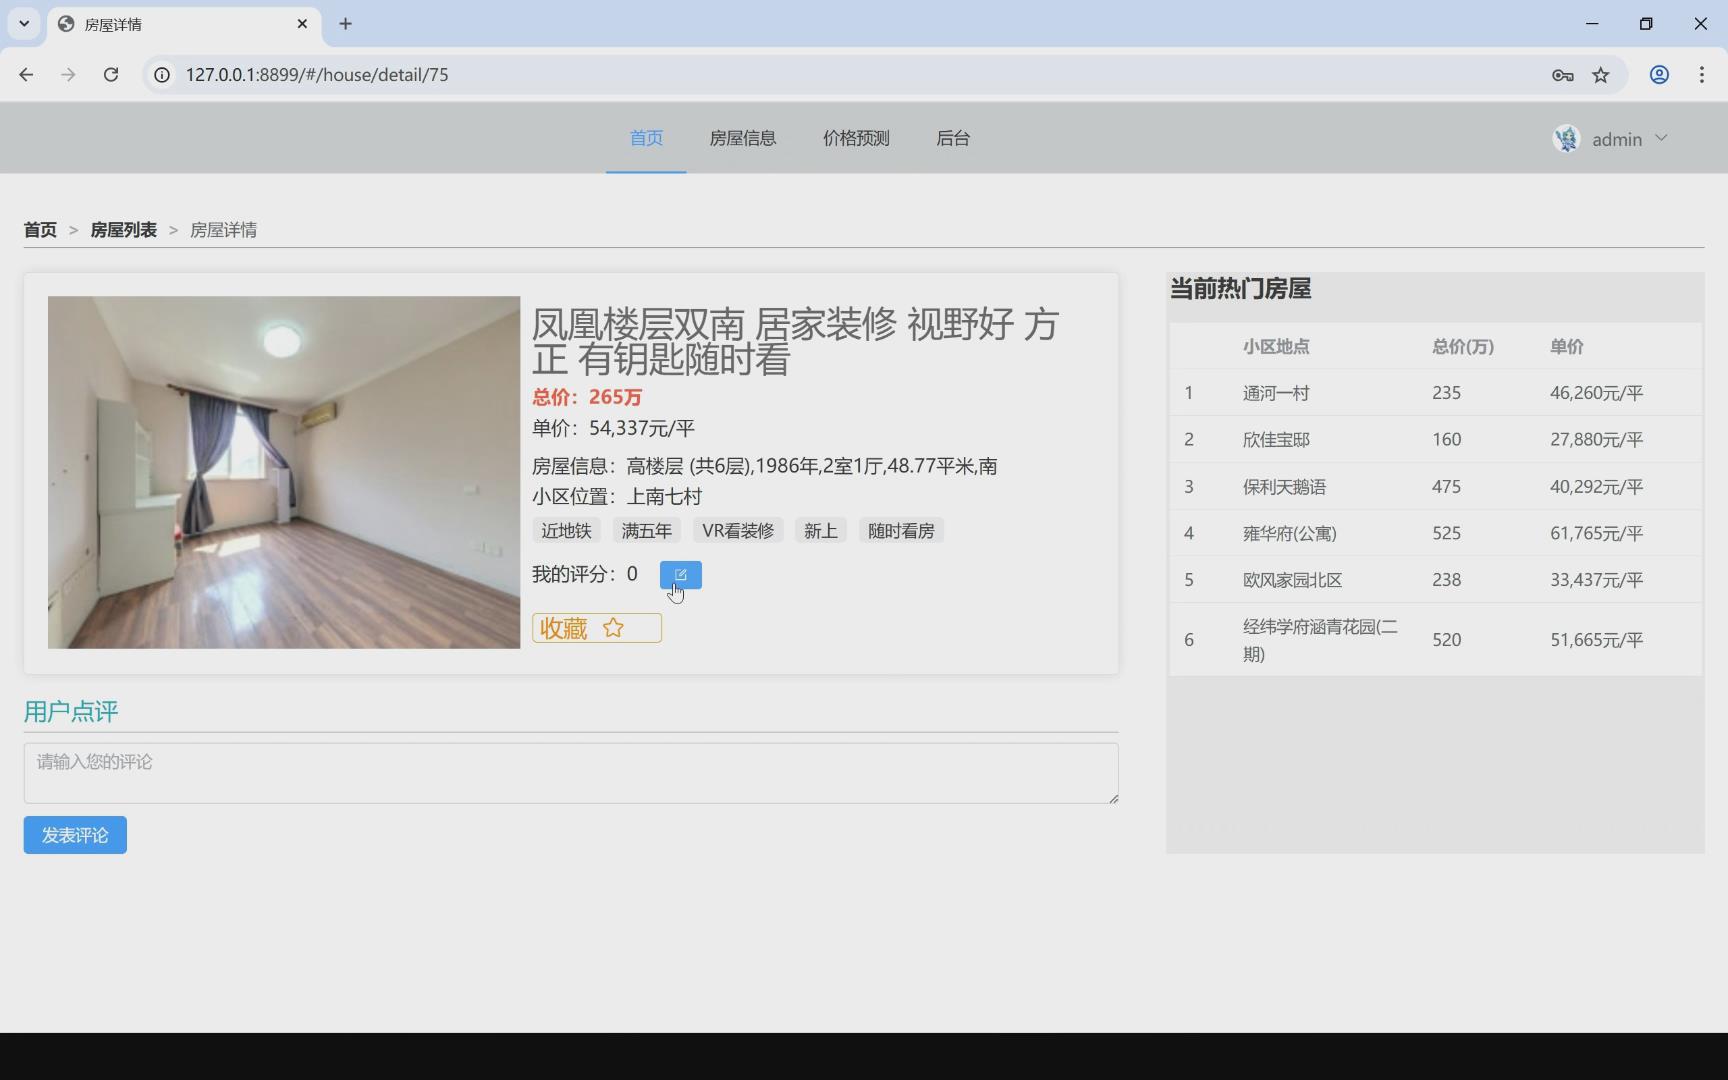
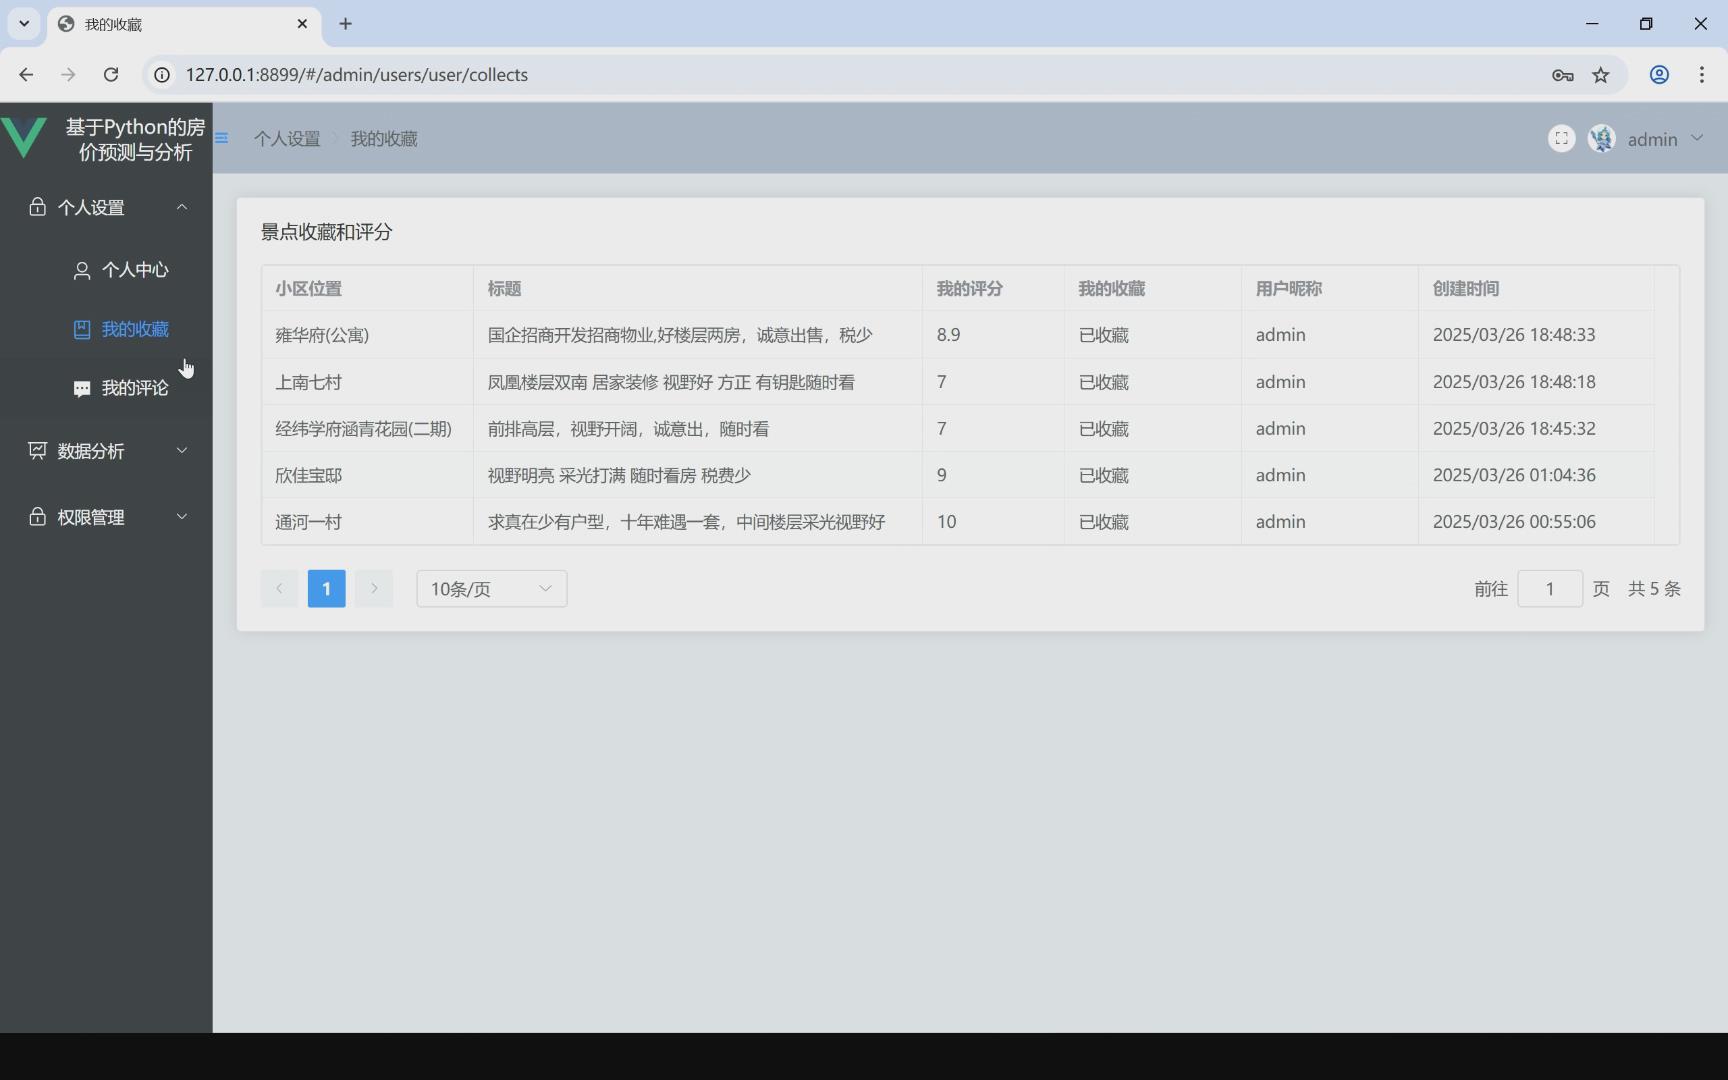
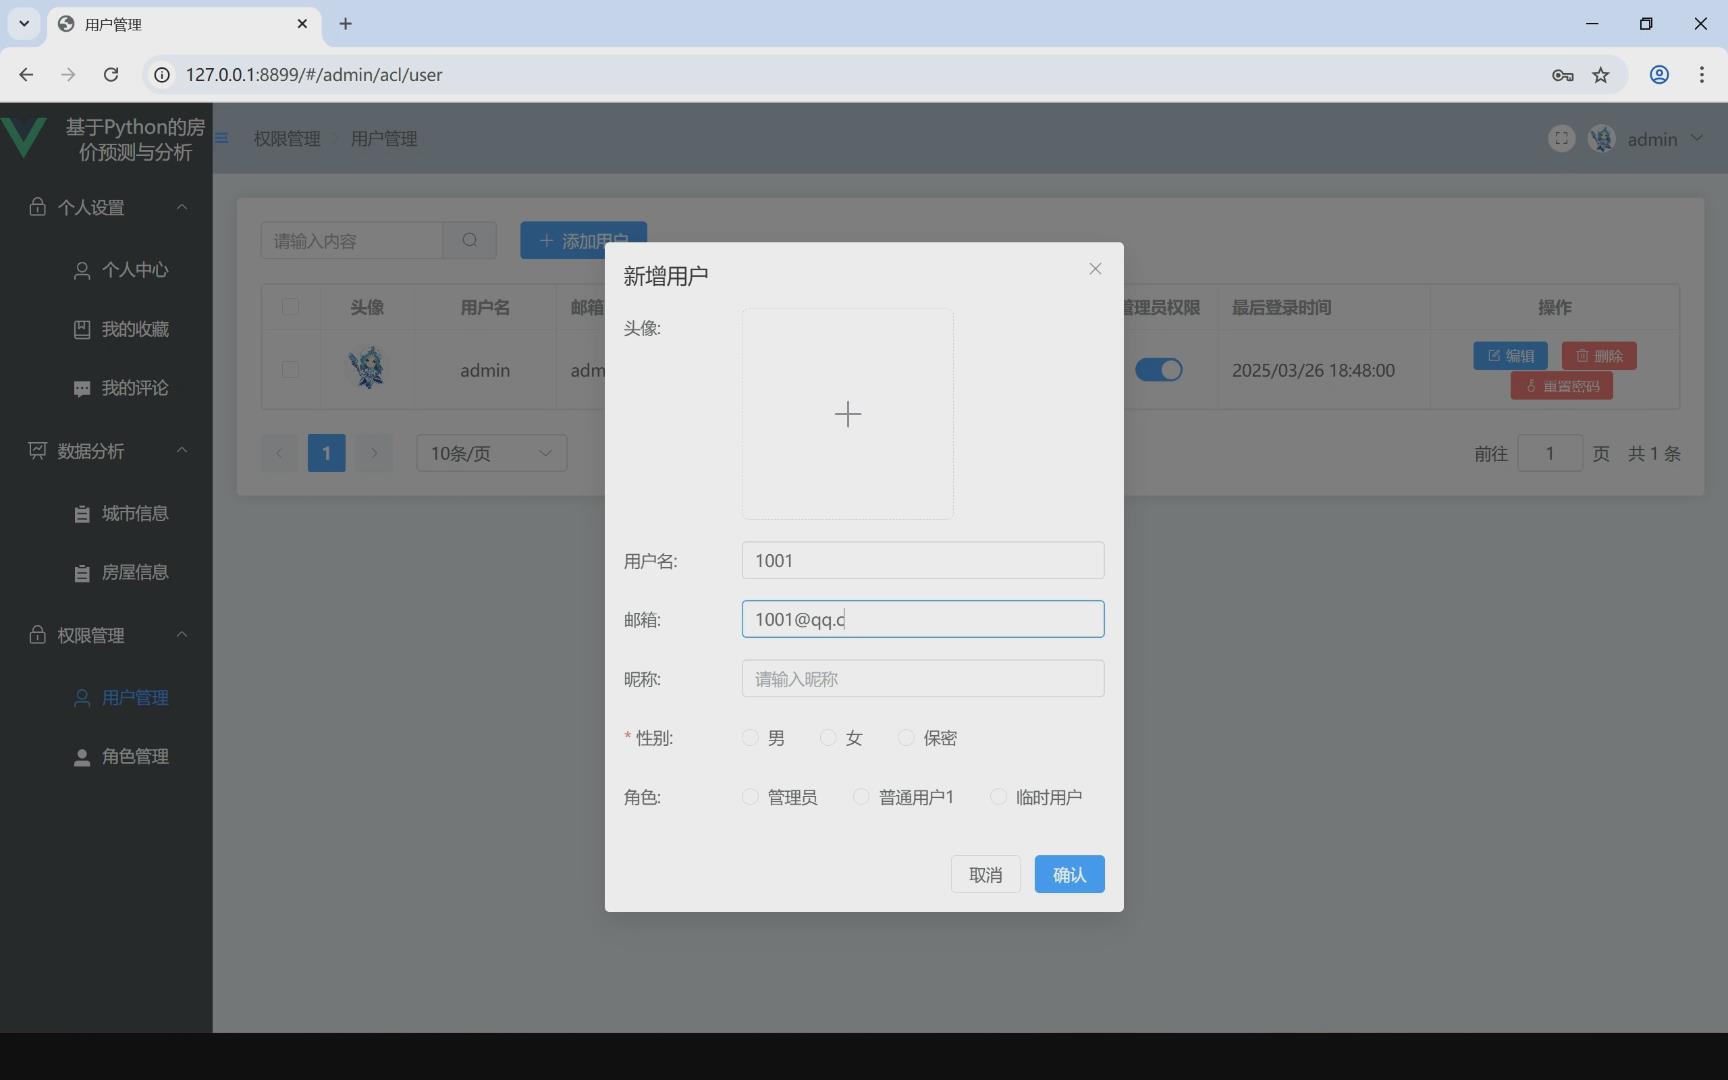
将训练好的模型保存为joblib或pickle文件,集成到Flask或Django框架中,提供API或Web界面供用户输入参数并获取预测结果。
import joblib
joblib.dump(model, 'house_price_model.joblib')
持续优化
定期更新数据,重新训练模型。尝试特征组合或更复杂的模型(如XGBoost、神经网络)以提升预测精度。
from xgboost import XGBRegressor
xgb_model = XGBRegressor()
xgb_model.fit(X_train, y_train)
开发技术路线
开发语言:Python
框架:flask/django
开发软件:PyCharm/vscode
数据库:mysql
数据库工具:Navicat for mysql
前端开发框架:vue.js
数据库 mysql 版本不限
本系统后端语言框架支持: 1 java(SSM/springboot)-idea/eclipse 2.Nodejs+Vue.js -vscode 3.python(flask/django)--pycharm/vscode 4.php(thinkphp/laravel)-hbuilderx
源码lw获取/同行可拿货,招校园代理 :文章底部获取博主联系方式!
需要成品或者定制,文章最下方名片联系我即可~ 所有项目都经过测试完善,本系统包修改时间和标题,包安装部署运行调试,不满意的可以定制

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐
 20
 0
- 0


 已为社区贡献107条内容

所有评论(0)