【论文阅读】Agent 记忆机制(10):MemRL——从语义召回到价值感知的经验记忆
文章目录
- 前言
- 零、论文基本信息
- 一、这篇论文想解决什么问题?
- 二、相关工作
- 三、问题组织:记忆增强的 Agent 策略
- 四、非参数强化学习
- 五、MemRL 方法总览
- 六、意图—经验—效用三元组
- 七、从语义召回到价值感知选择
- 八、记忆上的非参数强化学习
- 九、一个简单例子:MemRL 如何学习经验价值?
- 十、理论稳定性分析
- 十一、实验设置
- 十二、主要实验结果:运行时学习
- 十三、迁移实验
- 十四、消融实验:运行时强化学习是否有效?
- 十五、Q 值权重的影响
- 十六、跨任务优化与单任务反思
- 十七、召回数量的敏感度
- 十八、Q Critic 是否真的能够预测任务成功?
- 十九、MemRL 的稳定性与遗忘
- 二十、跨模型记忆迁移
- 二十一、MemRL 的优势
- 二十二、局限性
- 二十三、和 Memory-R1、AgeMem、Mem0、A-Mem 的区别
- 二十四、我的理解和启发
- 二十五、未来可以如何改造自己的项目?
- 二十六、总结
- 参考资料
前言
前面已经阅读了 A-Mem、Memory-R1、LightMem、AgeMem、GAM、Mem0 和 Zep 等多种 Agent 记忆方法。
这些方法分别关注:
- 如何提取和更新长期记忆;
- 如何建立记忆之间的结构化关联;
- 如何统一管理短期记忆和长期记忆;
- 如何降低记忆系统的 token 和调用成本;
- 如何用知识图谱保存实体、关系和时间变化。
但是,它们大多仍然面临一个共同问题:
召回到的记忆虽然在语义上相关,却不一定真的能够帮助 Agent 完成当前任务。
传统 RAG 和多数记忆系统通常默认:
语义越相似
→ 越值得召回
→ 越有助于完成任务
但在实际 Agent 任务中,这个假设并不总是成立。
例如,Agent 当前需要完成一个文件操作任务:
把目录中的所有 Markdown 文件移动到 archive 文件夹。
记忆库中可能存在两条语义相近的历史经验:
经验 A:
先使用 ls 查看目录,再逐个调用 mv 移动文件。
历史上多次成功。

经验 B:
直接执行 mv *.md archive。
在目标文件夹不存在时执行失败。
两条经验都与“移动 Markdown 文件”高度相关。但如果只根据向量相似度召回,它们的排名可能非常接近。
真正重要的问题不是:
哪条经验与当前任务在语义上更相似?
而是:
哪条经验在过去真正帮助 Agent 完成了任务?
这篇论文提出了 MemRL,一种基于情景记忆的非参数强化学习方法。
MemRL 不修改大模型权重,而是把学习过程放在外部记忆中。每条经验除了保存对应的任务意图和解决过程,还会保存一个可持续更新的效用值,也就是 Q 值。
当 Agent 使用某条记忆完成任务后,系统根据环境反馈更新该记忆的效用:
使用某条经验后任务成功
→ 提高这条经验的效用值

使用某条经验后任务失败
→ 降低这条经验的效用值
下一次面对相似任务时,系统不仅考虑语义相似度,还会优先选择历史上真正有效的经验。
因此,MemRL 的核心思路可以概括为:
不更新模型参数,而是通过环境奖励持续学习“哪些记忆真正有用”。
这种方法试图在两个目标之间取得平衡:
- 稳定性:冻结大模型参数,避免在线微调造成灾难性遗忘;
- 可塑性:通过持续更新外部记忆的效用,让 Agent 在运行过程中不断进步。
零、论文基本信息
- 论文名称:MemRL: Self-Evolving Agents via Runtime Reinforcement Learning on Episodic Memory
- 发表平台:arXiv preprint
- 代码仓库:MemTensor/MemRL
- 作者信息:
- Shengtao Zhang,Shanghai Jiao Tong University
- Jiaqian Wang,Xidian University
- Ruiwen Zhou,National University of Singapore
- Junwei Liao,Shanghai Jiao Tong University / Shanghai Innovation Institute
- Yuchen Feng,MemTensor
- Zhuo Li,Shanghai Jiao Tong University
- Yujie Zheng,Shanghai Jiao Tong University
- Weinan Zhang,Shanghai Jiao Tong University / Shanghai Innovation Institute
- Ying Wen,Shanghai Jiao Tong University / Shanghai Innovation Institute
- Zhiyu Li,MemTensor
- Feiyu Xiong,MemTensor
- Yutao Qi,Xidian University
- Bo Tang,University of Science and Technology of China / MemTensor
- Muning Wen,Shanghai Jiao Tong University
一、这篇论文想解决什么问题?
这篇论文关注的是:
如何让已经部署的 Agent 在不更新模型参数的情况下,持续从过去的任务经验和环境反馈中学习?
当前让 Agent 获得持续学习能力,主要有两条路线。
1. 参数化学习
参数化学习会通过微调、强化学习或在线更新模型参数,把新经验写入模型权重。
这种方法的优点是,新能力能够直接内化到模型中。
但是,它也存在明显问题:
- 训练成本较高;
- 需要保存梯度和优化器状态;
- 在线更新速度较慢;
- 新任务训练可能破坏旧能力;
- 容易出现灾难性遗忘;
- 在生产环境中很难频繁更新大模型。
也就是说,参数更新具有较强的可塑性,但可能破坏模型原本的稳定性。
2. 非参数记忆学习
另一条路线是保持模型参数不变,把新经验存入外部记忆。
当 Agent 再次遇到相似问题时,从记忆库中检索过去的解决方案,并将其作为上下文提供给模型。
这种方法:
- 不需要训练模型;
- 写入速度快;
- 容易增量扩展;
- 不会直接破坏模型原有能力。
但是,现有方法通常只根据语义相似度召回经验。
这会带来一个关键问题:
语义相似的经验不一定具有相同的任务效用。
例如:
当前任务:
查找数据库中销量最高的商品。

经验 A:
使用 ORDER BY sales DESC LIMIT 1。
历史执行成功。

经验 B:
使用 MAX(sales),但没有返回对应商品名称。
历史执行失败。
经验 A 和经验 B 在语义上都高度相关,但它们对完成当前任务的帮助不同。
如果系统无法记录环境反馈,就可能反复召回失败经验。
3. 稳定性与可塑性的矛盾
论文把这一问题概括为稳定性—可塑性困境:
只保持模型不变:
系统稳定,但缺乏持续学习能力。

持续修改模型参数:
系统可以学习,但可能遗忘旧能力。
MemRL 的解决思路是:
冻结大模型
+
持续更新外部情景记忆
模型负责稳定推理,记忆负责运行时学习。
论文 Figure 1 展示了这种类比关系。
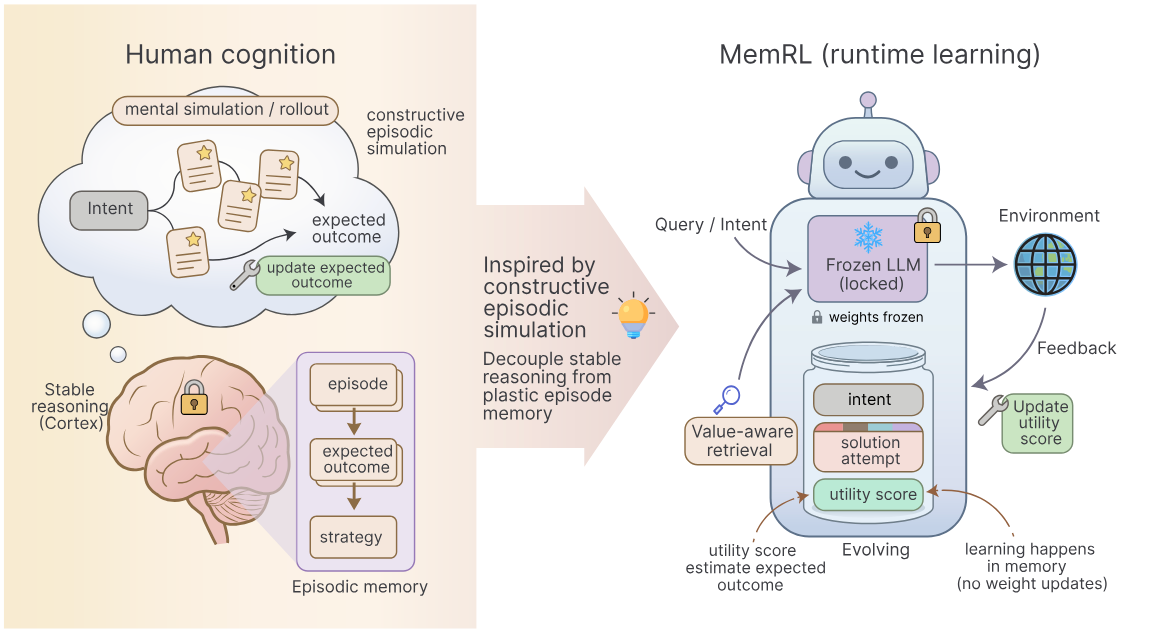
图源:Zhang et al., 2026,Figure 1。
图中将冻结的大模型类比为相对稳定的认知推理系统,将外部情景记忆类比为能够持续变化的经验系统。
环境反馈不会修改模型权重,而是用于更新记忆的效用值,从而让学习发生在记忆空间中。
二、相关工作
论文的相关工作主要涉及三个方向:
- 运行时学习;
- 大模型强化学习;
- Agent 记忆系统。
1. 运行时学习
运行时学习关注 Agent 在部署之后,如何通过持续交互不断提高能力。
它与传统持续学习和测试时适应有所不同。
传统持续学习通常仍然会更新模型参数,以适应不断变化的数据分布;测试时适应也经常通过调整部分参数,使模型适应当前测试环境。
而 MemRL 设置了一个更严格的约束:
大模型主干必须保持冻结。
这意味着 Agent 的能力提升不能来自模型参数,而只能来自外部经验记忆和检索策略的变化。
2. 大模型强化学习
强化学习已经广泛应用于大模型训练,例如:
- 基于人类反馈的强化学习;
- 使用规则验证器优化推理;
- 通过环境奖励训练工具调用;
- 让 Agent 学习复杂动作策略。
这些方法的共同特点是:
环境奖励
→ 优化模型参数或额外的参数化策略模块
MemRL 同样利用环境奖励,但优化对象发生了变化:
传统强化学习:
更新模型参数。

MemRL:
更新记忆中的效用值和检索策略。
因此,论文把它称为 Non-Parametric Reinforcement Learning,非参数强化学习。
这里的“非参数”不是指系统完全没有参数,而是指:
运行时学习过程不修改大模型权重,学习结果保存在外部记忆结构中。
3. Agent 记忆系统
早期记忆系统主要使用:
- 向量数据库;
- 语义相似度检索;
- 对话摘要;
- 分层存储;
- 固定启发式规则。
后续方法开始关注:
- 记忆的提取和更新;
- 记忆节点之间的结构化关联;
- 记忆反思;
- 基于反馈的记忆优化;
- 长期记忆生命周期管理。
但论文认为,大多数现有方法仍然缺少一个明确指标:
一条记忆在被召回后,究竟多大概率能够帮助 Agent 获得更高任务奖励?
MemRL 通过 Q 值显式建模这种功能效用,把记忆召回从相似度匹配转化为价值决策。
三、问题组织:记忆增强的 Agent 策略
论文使用 Memory-Based Markov Decision Process,基于记忆的马尔可夫决策过程 描述 Agent 与记忆之间的交互。
该过程可以表示为:
( S , A , P , R , γ , M ) \left(S,A,P,R,\gamma,M\right) (S,A,P,R,γ,M)
其中:
- S S S 表示状态空间;
- A A A 表示 Agent 的动作空间;
- P P P 表示环境状态转移;
- R R R 表示奖励函数;
- γ \gamma γ 表示折扣因子;
- M M M 表示不断演化的外部记忆库。
在第 t t t 个时间步,Agent 接收当前状态 s t s_t st,从记忆库 M t M_t Mt 中选择相关经验,再生成动作 a t a_t at。
整个 Agent 策略可以写成:
π ( a t ∣ s t , M t ) = ∑ m ∈ M t μ ( m ∣ s t , M t ) p L L M ( a t ∣ s t , m ) \pi(a_t\mid s_t,M_t)=\sum_{m\in M_t}\mu(m\mid s_t,M_t)p_{\mathrm{LLM}}(a_t\mid s_t,m) π(at∣st,Mt)=m∈Mt∑μ(m∣st,Mt)pLLM(at∣st,m)
其中:
- μ ( m ∣ s t , M t ) \mu(m\mid s_t,M_t) μ(m∣st,Mt) 是记忆检索策略;
- p L L M ( a t ∣ s t , m ) p_{\mathrm{LLM}}(a_t\mid s_t,m) pLLM(at∣st,m) 是冻结大模型的推理策略;
- m m m 是被召回的某条记忆;
- π \pi π 是最终的联合 Agent 策略。
这个公式可以理解为:
最终动作质量
=
记忆检索策略
+
冻结大模型根据该记忆生成动作的能力
过去的记忆增强方法主要优化第二部分,也就是换更强的生成模型,或者只用固定的向量相似度作为第一部分。
MemRL 则重点优化:
μ(m | s, M)
也就是:
当前状态下,究竟应该选择哪条历史记忆?
论文 Figure 2 给出了一个跨任务经验复用的例子。
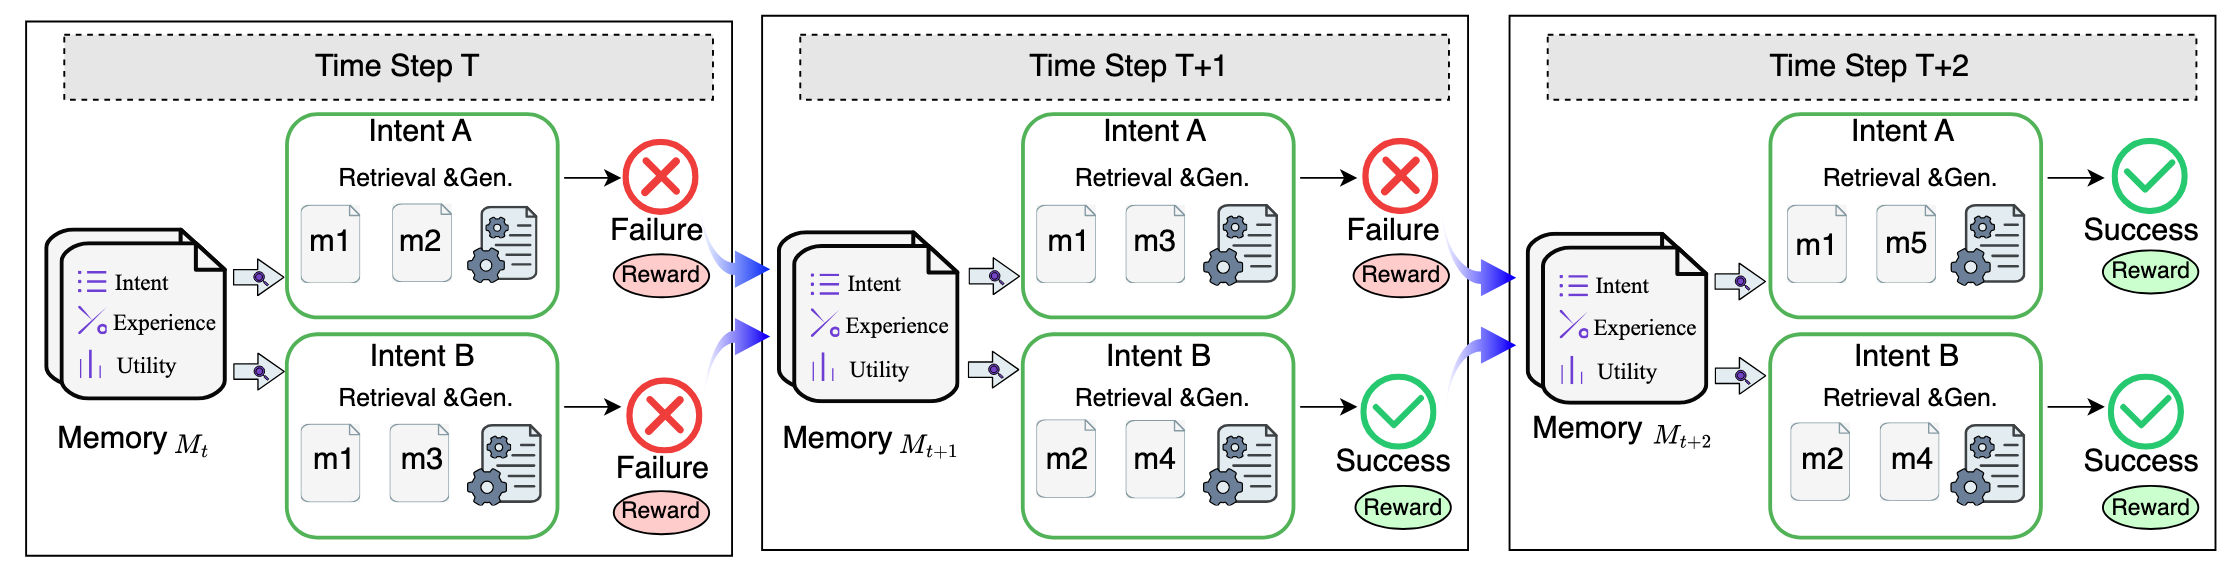
图源:Zhang et al., 2026,Figure 2。
在时间步 t + 1 t+1 t+1,Intent B 产生了一条成功经验并被写入记忆。到了时间步 t + 2 t+2 t+2,另一个任务 Intent A 可以召回这条经验,并利用其中可迁移的策略获得成功。
这说明情景经验不一定只服务于原始任务,也可能被语义相近的其他任务复用。
四、非参数强化学习
传统记忆召回通常根据余弦相似度选择记忆:
当前问题与历史经验越相似
→ 排名越靠前
MemRL 则将记忆召回视为一个价值决策问题。
1. 状态、动作和效用的重新映射
在 MemRL 中:
| 强化学习概念 | MemRL 中的含义 |
|---|---|
| 状态 s s s | 当前用户意图或任务查询 |
| 动作 m m m | 从记忆库中选择某条经验 |
| 奖励 r r r | 使用经验后环境返回的任务结果 |
| Q 值 Q ( s , m ) Q(s,m) Q(s,m) | 在意图 s s s 下使用记忆 m m m 的预期效用 |
这里需要注意,强化学习中的“动作”并不是 Agent 最终执行的环境动作,而是:
检索阶段选择哪条记忆。
Agent 的最终工具调用或自然语言输出,仍然由冻结的大模型生成。
2. 最优检索策略
MemRL 希望选择预期效用最高的记忆:
μ ∗ ( m ∣ s , M ) = arg max m ∈ M Q ( s , m ) \mu^{*}(m\mid s,M)=\arg\max_{m\in M}Q(s,m) μ∗(m∣s,M)=argm∈MmaxQ(s,m)
其中:
- Q ( s , m ) Q(s,m) Q(s,m) 表示在当前意图 s s s 下,使用记忆 m m m 所能获得的预期回报;
- μ ∗ \mu^{*} μ∗ 表示最优记忆检索策略。
这个公式的直观含义是:
不只检索“看起来相似”的记忆,而要选择“过去真正有效”的记忆。
五、MemRL 方法总览
MemRL 的整体框架如 Figure 3 所示。
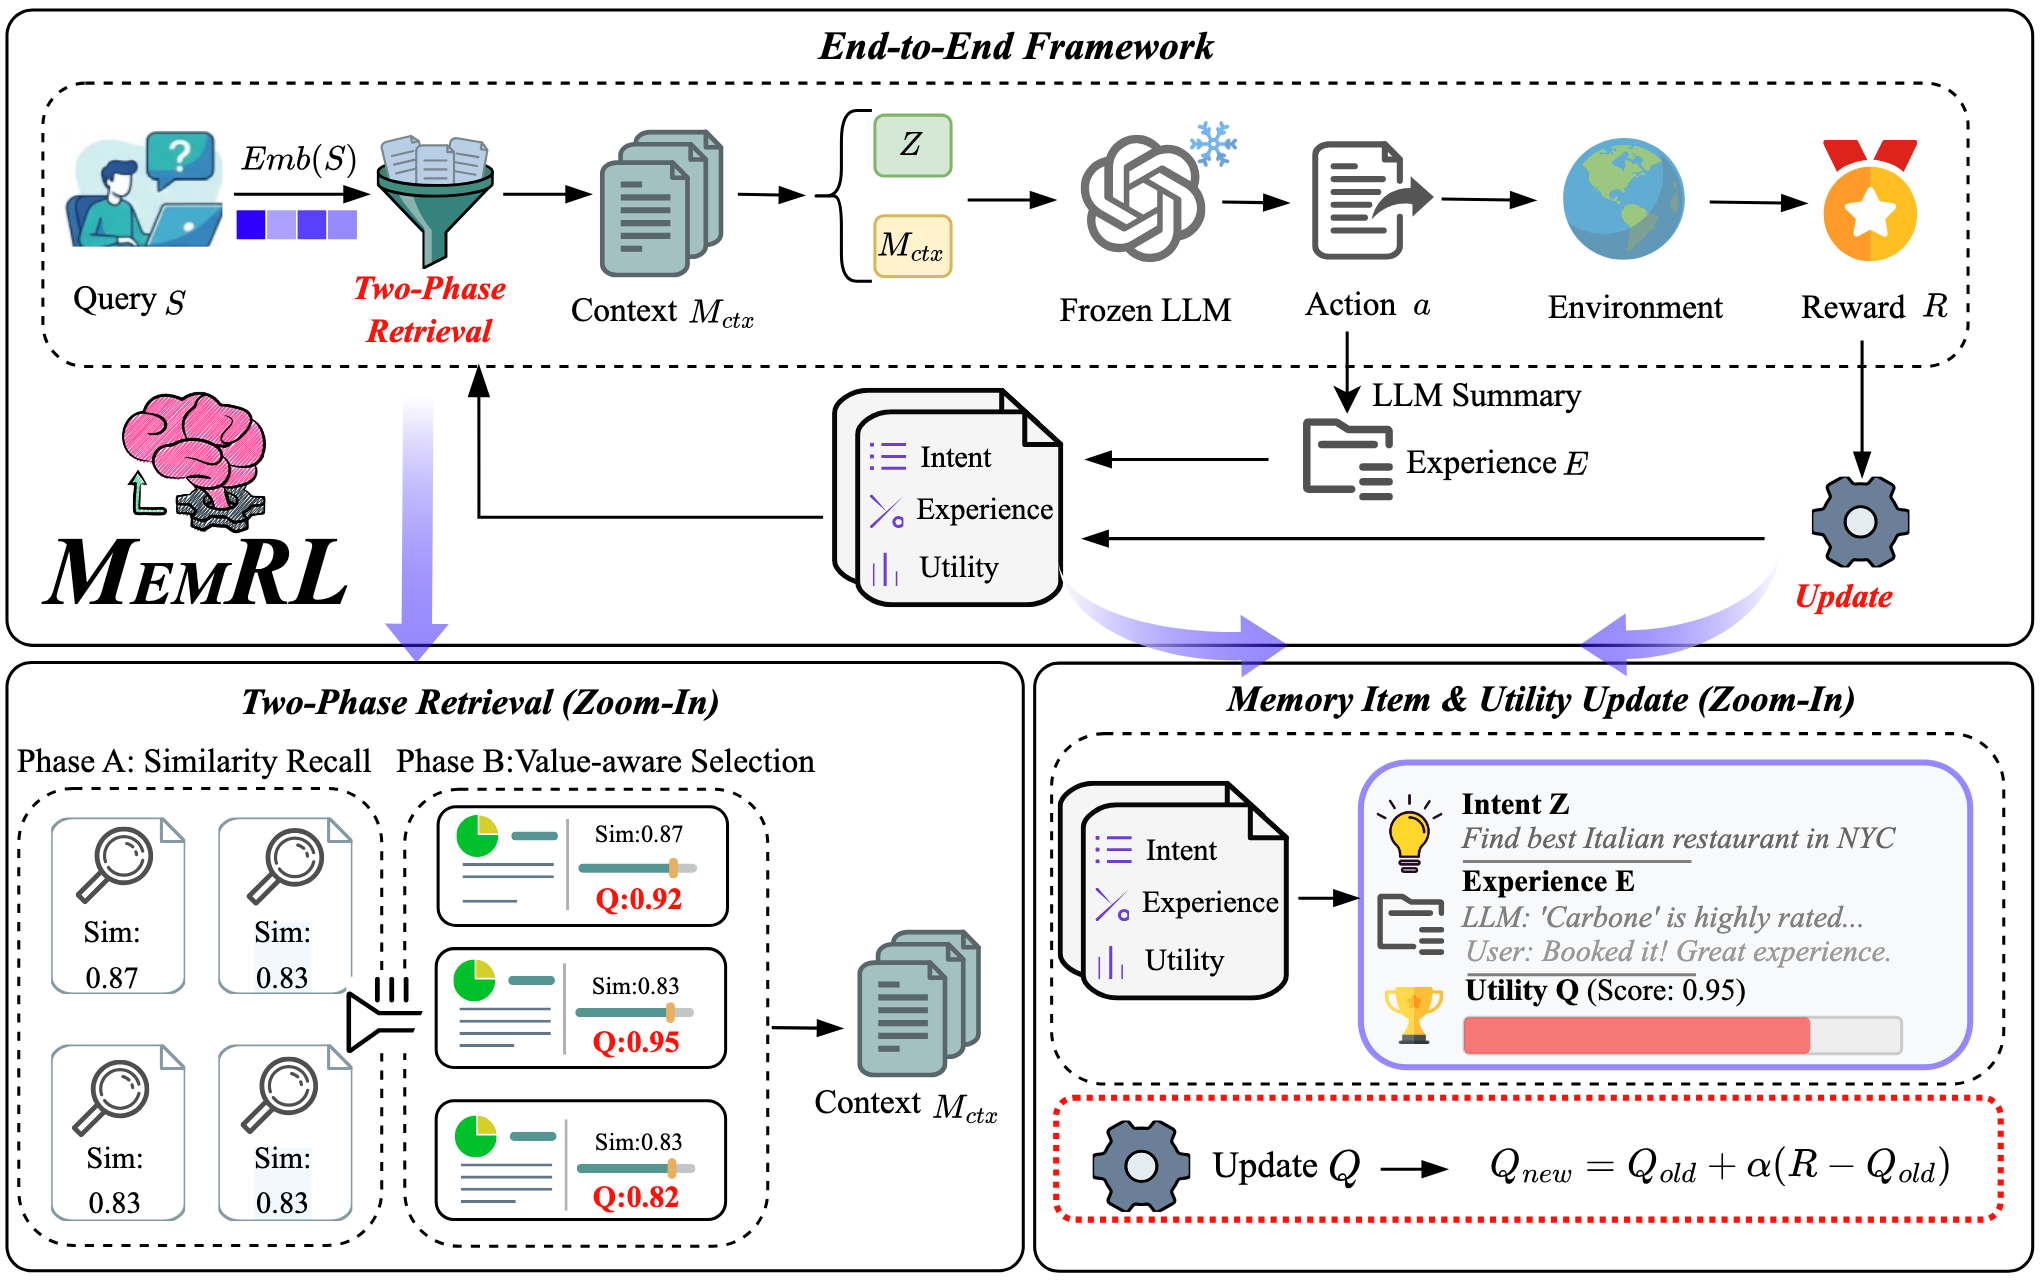
图源:Zhang et al., 2026,Figure 3。
整个运行时学习闭环可以概括为:
接收当前任务
→ 从记忆库召回语义相关候选
→ 根据相似度和 Q 值进行价值感知选择
→ 将选中的经验加入上下文
→ 冻结的大模型生成解决方案
→ 在环境中执行
→ 获得奖励
→ 更新被使用记忆的 Q 值
→ 总结本轮经验并写回记忆库
框架包含三个核心模块:
- Intent-Experience-Utility 三元组记忆
- Two-Phase Retrieval 两阶段召回
- Runtime Utility Update 运行时效用更新
六、意图—经验—效用三元组
传统记忆库可能只保存:
查询 → 回答
或者:
记忆文本 → embedding
MemRL 将每条记忆组织为:
M = { ( z i , e i , Q i ) } i = 1 ∣ M ∣ M=\left\{\left(z_i,e_i,Q_i\right)\right\}_{i=1}^{|M|} M={(zi,ei,Qi)}i=1∣M∣
其中:
- z i z_i zi 表示 Intent,即原任务的意图;
- e i e_i ei 表示 Experience,即解决任务的经验;
- Q i Q_i Qi 表示 Utility,即该经验学习到的效用值。
1. Intent:意图
Intent 描述这条经验最初解决的任务。
例如:
查找数据库中销售额最高的商品。
系统会对 Intent 进行向量化,用于第一阶段的语义召回。
2. Experience:经验
Experience 保存任务执行轨迹的总结。
它可能包括:
- 使用过的工具;
- 关键操作步骤;
- 成功策略;
- 失败原因;
- 代码模板;
- 环境约束;
- 需要避免的错误。
例如:
先查询商品表结构,确认销售额字段名称;
使用 ORDER BY revenue DESC LIMIT 1;
不要只查询 MAX(revenue),否则无法返回商品信息。
相比保存完整轨迹,经验摘要更加紧凑,也更容易迁移到相似任务。
3. Utility:效用
Utility 使用 Q 值表示。
它近似估计:
将经验 e i e_i ei 应用于与意图 z i z_i zi 相似的任务时,能够获得多高的预期回报?
如果一条经验多次帮助 Agent 完成任务,它的 Q 值会逐渐提高。
如果一条经验经常导致失败,它的 Q 值会降低。
因此,记忆不再只是“存在或不存在”,而是具备了一个可以持续学习的价值信号。
七、从语义召回到价值感知选择
MemRL 的检索分成两个阶段:
- 语义候选召回;
- 价值感知选择。
1. 第一阶段:基于相似度的候选召回
对于当前查询 s s s,系统首先根据 Intent embedding 召回语义相似的候选经验。
候选集合可以写为:
C ( s ) = TopK k 1 ( { i ∣ sim ( Emb ( s ) , Emb ( z i ) ) > δ } ) C(s)=\operatorname{TopK}_{k_1}\left(\left\{i\mid\operatorname{sim}\left(\operatorname{Emb}(s),\operatorname{Emb}(z_i)\right)>\delta\right\}\right) C(s)=TopKk1({i∣sim(Emb(s),Emb(zi))>δ})
其中:
- Emb \operatorname{Emb} Emb 表示 embedding 模型;
- sim \operatorname{sim} sim 表示余弦相似度;
- δ \delta δ 是相似度阈值;
- k 1 k_1 k1 是第一阶段召回数量;
- C ( s ) C(s) C(s) 是语义相关的候选记忆集合。
这一阶段解决的是:
哪些历史经验和当前任务大致相关?
如果没有候选记忆超过阈值,系统不会强行使用低相关经验,而是让冻结大模型独立探索。
这一点很重要,因为错误记忆有时比没有记忆更危险。
2. 第二阶段:价值感知选择
从候选集合中,MemRL 使用相似度和 Q 值共同计算最终得分:
score ( s , z i , e i ) = ( 1 − λ ) sim ^ ( s , z i ) + λ Q i ^ \operatorname{score}(s,z_i,e_i)=(1-\lambda)\widehat{\operatorname{sim}}(s,z_i)+\lambda\widehat{Q_i} score(s,zi,ei)=(1−λ)sim (s,zi)+λQi
其中:
- sim ^ \widehat{\operatorname{sim}} sim 是经过标准化的语义相似度;
- Q i ^ \widehat{Q_i} Qi 是经过标准化的记忆效用;
- λ \lambda λ 控制语义相关性和历史效用之间的权重;
- 最终从候选中选择 Top- k 2 k_2 k2 条经验。
这一阶段回答的是:
在语义相关的经验中,哪些经验过去真正帮助 Agent 获得过成功?
3. 为什么要先语义召回,再按价值排序?
如果只按语义相似度:
可能召回内容相关但历史上经常失败的经验。
如果只按 Q 值:
可能召回历史成功率很高、但与当前任务完全无关的经验。
因此,两阶段检索实际上分别承担:
语义相似度:
保证经验与当前任务相关。

Q 值:
保证经验具有实际帮助。
论文将两者之间的关系概括为:
Similarity 保证 relevance,Q-value 保证 helpfulness。
4. 为什么需要标准化?
相似度和 Q 值可能位于不同的数值分布中。
如果直接相加,其中一个数值范围更大的指标可能完全主导排序。
因此,论文使用 z-score 对二者进行标准化,使其具有可比较的尺度。
八、记忆上的非参数强化学习
MemRL 的核心学习发生在记忆空间中。
当 Agent 使用召回经验完成任务后,环境会返回奖励 r r r。
系统只更新实际被加入上下文的记忆,而不是更新整个记忆库。
1. 完整的时序差分更新
理论上,Q 值可以使用时序差分方法更新:
Q ( s , m ) ← Q ( s , m ) + α [ r + γ max m ′ Q ( s ′ , m ′ ) − Q ( s , m ) ] Q(s,m)\leftarrow Q(s,m)+\alpha\left[r+\gamma\max_{m'}Q(s',m')-Q(s,m)\right] Q(s,m)←Q(s,m)+α[r+γm′maxQ(s′,m′)−Q(s,m)]
其中:
- α \alpha α 是学习率;
- r r r 是当前环境奖励;
- γ \gamma γ 是折扣因子;
- s ′ s' s′ 是下一状态;
- m ′ m' m′ 是下一状态下可能选择的记忆。
2. 论文实际使用的简化更新
论文把每个任务视为近似的一步决策过程,因此使用 Monte Carlo 风格的简化规则:
Q n e w = Q o l d + α ( r − Q o l d ) Q_{\mathrm{new}}=Q_{\mathrm{old}}+\alpha\left(r-Q_{\mathrm{old}}\right) Qnew=Qold+α(r−Qold)
这可以写成:
Q n e w = ( 1 − α ) Q o l d + α r Q_{\mathrm{new}}=(1-\alpha)Q_{\mathrm{old}}+\alpha r Qnew=(1−α)Qold+αr
从第二种形式可以更直观地看出:
新的 Q 值,是旧效用估计和本次任务奖励的加权平均。
例如:
旧 Q 值:0.6
本次奖励:1
学习率 α:0.2
更新后:
Qnew = 0.6 + 0.2 × (1 - 0.6)
     = 0.68
如果本次任务失败,奖励为 0:
Qnew = 0.6 + 0.2 × (0 - 0.6)
     = 0.48
随着同一经验被多次使用,Q 值会逐渐逼近它的真实平均回报。
3. 新经验如何写入?
每次任务结束后,系统会让 LLM 总结当前执行轨迹,并生成新的 Experience。
然后将其写入记忆库:
当前任务意图 z
+
执行经验 enew
+
初始效用 Qinit
形成新的三元组:
(z, enew, Qinit)
因此,MemRL 同时进行两种记忆更新:
- 更新被使用旧记忆的 Q 值;
- 将本轮执行轨迹总结成新经验。
这使记忆库能够一边增长,一边学习哪些经验更值得使用。
九、一个简单例子:MemRL 如何学习经验价值?
假设一个操作系统 Agent 需要处理以下任务:
任务:
把 logs 目录中的所有 .txt 文件移动到 backup 目录。
记忆库中存在三条候选经验。
1. 候选经验
经验 A
Intent:移动某类文件到目标文件夹
Experience:
先检查目标目录是否存在;
不存在时使用 mkdir -p 创建;
再执行 mv logs/*.txt backup/。
Q:0.92
经验 B
Intent:移动文件到另一个目录
Experience:
直接执行 mv logs/*.txt backup/。
Q:0.35
经验 C
Intent:复制日志文件
Experience:
使用 cp logs/*.txt backup/。
Q:0.88
2. 第一阶段:语义召回
A、B、C 都与文件迁移任务存在一定语义相似性,因此可能进入候选池。
3. 第二阶段:价值选择
经验 C 的 Q 值很高,但它解决的是“复制”,而不是“移动”,语义相似度相对较低。
经验 B 与当前任务很相似,但历史效用较低。
经验 A 同时具备:
- 较高语义相关性;
- 较高历史效用。
因此,经验 A 最终被选入上下文。
4. 环境反馈
Agent 根据经验 A 成功完成任务,获得奖励:
r = 1
系统进一步提高经验 A 的 Q 值。
同时,本次执行轨迹也会被总结为一条新经验,加入记忆库。
随着类似任务不断出现,系统会越来越倾向于召回带有目录检查和容错步骤的经验。
这就是 MemRL 所说的运行时自我进化:
模型参数没有发生变化,但 Agent 对经验的选择越来越准确。
十、理论稳定性分析
论文不仅给出了经验性结果,还从强化学习角度分析了 Q 值更新的稳定性。
分析依赖两个基本假设:
- 冻结的 LLM 推理策略保持不变;
- 任务分布相对平稳。
对于状态—记忆组合 ( s , m ) (s,m) (s,m),定义真实预期效用:
β ( s , m ) = E [ r t ∣ s , m ] \beta(s,m)=\mathbb{E}[r_t\mid s,m] β(s,m)=E[rt∣s,m]
论文证明,在使用前面的增量更新规则后,当更新次数逐渐增加:
lim t → ∞ E [ Q t ] = β ( s , m ) \lim_{t\to\infty}\mathbb{E}[Q_t]=\beta(s,m) t→∞limE[Qt]=β(s,m)
也就是说:
Q 值的期望会逐渐收敛到使用该记忆时的真实平均回报。
论文还给出了方差上界:
lim sup t → ∞ Var ( Q t ) ≤ α 2 − α Var ( r t ∣ s , m ) \limsup_{t\to\infty}\operatorname{Var}(Q_t)\leq\frac{\alpha}{2-\alpha}\operatorname{Var}(r_t\mid s,m) t→∞limsupVar(Qt)≤2−ααVar(rt∣s,m)
这个公式说明,Q 值估计的波动受到学习率 α \alpha α 和奖励方差的控制。
当学习率较小时:
- Q 值变化更加平稳;
- 对单次异常奖励不那么敏感;
- 但适应新情况的速度较慢。
当学习率较大时:
- 系统适应更快;
- 但 Q 值更容易受到随机奖励影响。
1. 检索分布变化的问题
随着 Q 值不断更新,系统召回记忆的分布也会发生变化。
例如,高 Q 记忆更容易被选中,被选中后又会获得更多反馈。
论文把这一过程解释为一种广义 EM 过程:
策略改进阶段:
根据当前 Q 值优化记忆排序。

价值更新阶段:
根据新奖励更新记忆 Q 值。
论文认为,二者交替进行,可以使全局记忆效用逐渐达到稳定点。
不过,这一理论结论依赖冻结模型、平稳任务分布等假设。在真实开放环境中,任务分布和模型服务版本都可能变化,因此需要谨慎理解其适用范围。
十一、实验设置
1. 数据集
论文在四类不同任务上评估 MemRL。
BigCodeBench
BigCodeBench 用于评估代码生成能力。
任务通常要求模型根据自然语言描述生成可以通过测试用例的 Python 函数。
这类任务可以检验:
- 代码模板复用;
- API 使用经验;
- 错误模式总结;
- 跨代码任务经验迁移。
Lifelong Agent Bench
论文使用其中两类任务:
- OS Task:操作系统交互;
- DB Task:数据库交互。
这类任务需要 Agent:
- 选择工具;
- 执行连续操作;
- 根据环境结果调整策略;
- 复用历史程序性经验。
ALFWorld
ALFWorld 是文本化具身任务环境。
Agent 需要在家庭环境中完成:
- 寻找物品;
- 移动物品;
- 清洁或加热物品;
- 执行多步探索。
这种任务具有较强的探索性,适合检验历史策略能否帮助减少无效尝试。
Humanity’s Last Exam
HLE 包含多领域高难度问题,主要用于评估模型在知识和推理前沿上的能力。
与 OS、DB 和 ALFWorld 相比,HLE 内部任务之间的相似性较低,因此跨任务经验复用更困难。
2. 对比方法
论文对比了:
- No Memory:不使用外部记忆;
- Pass@10:通过多次采样扩大测试时搜索;
- RAG:普通语义检索;
- Self-RAG:带有自我评估和检索控制的 RAG;
- Mem0:基于事实提取和更新的长期记忆;
- MemP:基于程序性记忆的 Agent 方法;
- MemRL:本文方法。
所有方法均在冻结主干模型的条件下进行比较。
3. 两种实验设置
论文分别评估:
Runtime Learning
在相同任务集合上运行多个 epoch,观察 Agent 是否能够在持续交互和记忆反馈中不断提升。
Transferring
在训练任务上积累记忆后,将记忆用于未见过的新任务,评估经验的迁移能力。
4. Backbone
不同数据集使用不同模型,以避免出现:
- 模型太弱,几乎没有成功奖励;
- 模型太强,任务已经达到天花板。
主要包括:
| 数据集 | Backbone |
|---|---|
| BigCodeBench | GPT-4o |
| Lifelong Agent Bench OS | GPT-4o-mini |
| Lifelong Agent Bench DB | GPT-4o-mini |
| ALFWorld | GPT-5-mini |
| HLE | Gemini-3-pro |
5. 评测指标
论文使用两个主要指标。
Success Rate
Success Rate 表示当前 epoch 中成功完成的任务比例。
可以简化表示为:
SR t = 第 t 个 epoch 成功任务数 任务总数 \operatorname{SR}_t=\frac{\text{第 }t\text{ 个 epoch 成功任务数}}{\text{任务总数}} SRt=任务总数第 t 个 epoch 成功任务数
它反映 Agent 当前阶段的即时能力。
Cumulative Success Rate
Cumulative Success Rate 表示截至当前 epoch,至少被成功解决过一次的任务比例。
CSR t = 前 t 个 epoch 中至少成功一次的任务数 任务总数 \operatorname{CSR}_t=\frac{\text{前 }t\text{ 个 epoch 中至少成功一次的任务数}}{\text{任务总数}} CSRt=任务总数前 t 个 epoch 中至少成功一次的任务数
例如,一个任务在第 2 个 epoch 成功、之后又失败:
- 它会继续计入 CSR;
- 但不会计入当前 epoch 的 SR。
因此:
SR:
当前这一轮能解决多少任务。

CSR:
运行到目前为止,系统至少探索出过多少任务的有效解法。
CSR 更适合衡量运行时学习是否不断扩大 Agent 的可解决任务集合。
十二、主要实验结果:运行时学习
论文 Table 1 展示了 10 个 epoch 后的运行时学习结果。
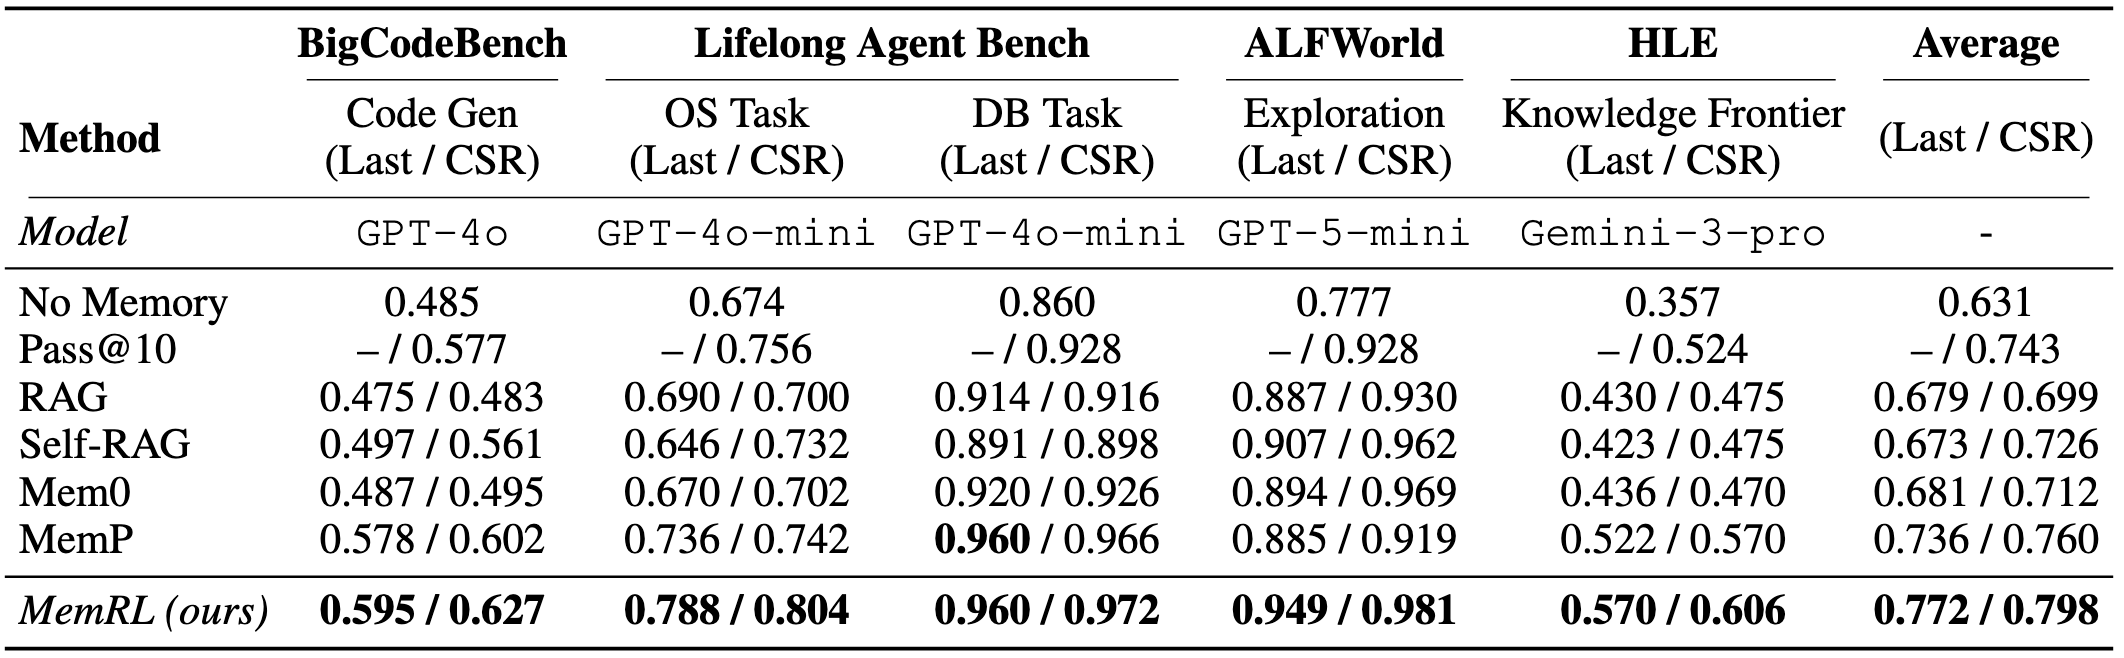
表源:Zhang et al., 2026,Table 1。
| 方法 | BigCodeBench | OS Task | DB Task | ALFWorld | HLE | 平均 CSR |
|---|---|---|---|---|---|---|
| RAG | 0.483 | 0.700 | 0.916 | 0.930 | 0.475 | 0.699 |
| Self-RAG | 0.561 | 0.732 | 0.898 | 0.962 | 0.475 | 0.726 |
| Mem0 | 0.495 | 0.702 | 0.926 | 0.969 | 0.470 | 0.712 |
| MemP | 0.602 | 0.742 | 0.966 | 0.919 | 0.570 | 0.760 |
| MemRL | 0.627 | 0.804 | 0.972 | 0.981 | 0.606 | 0.798 |
表格中展示的是各方法的 CSR,完整原表同时报告最后一个 epoch 的 Success Rate。
1. 平均结果
MemRL 的平均 CSR 为:
0.798
最强 baseline MemP 为:
0.760
绝对提升为:
3.8 个百分点
2. OS Task
MemRL 在 OS Task 上达到:
0.804
MemP 为:
0.742
绝对提升:
6.2 个百分点
操作系统任务内部通常包含相似的文件、目录和命令操作,因此成功经验更容易跨任务迁移。
3. ALFWorld
MemRL 的 CSR 为:
0.981
MemP 为:
0.919
同样提升 6.2 个百分点。
ALFWorld 具有明显的探索性质。过去成功的物品搜索和操作策略,能够帮助 Agent 减少后续任务中的无效尝试。
4. HLE
MemRL 在 HLE 上达到:
0.606
MemP 为:
0.570
提升 3.6 个百分点。
虽然 HLE 内部问题差异较大,但价值感知检索仍然能够过滤部分语义相关但作用有限的经验。
5. Mem0 的表现
Mem0 的平均 CSR 为 0.712,低于 MemRL。
这并不意味着 Mem0 本身是无效的,而是因为两者主要解决的问题不同:
Mem0:
管理长期事实的增、改、删。

MemRL:
学习程序性经验的任务效用。
对于代码、工具调用和环境交互任务,程序性经验和价值反馈更直接。
十三、迁移实验
论文 Table 2 评估将训练过程中积累的记忆用于未见任务的能力。
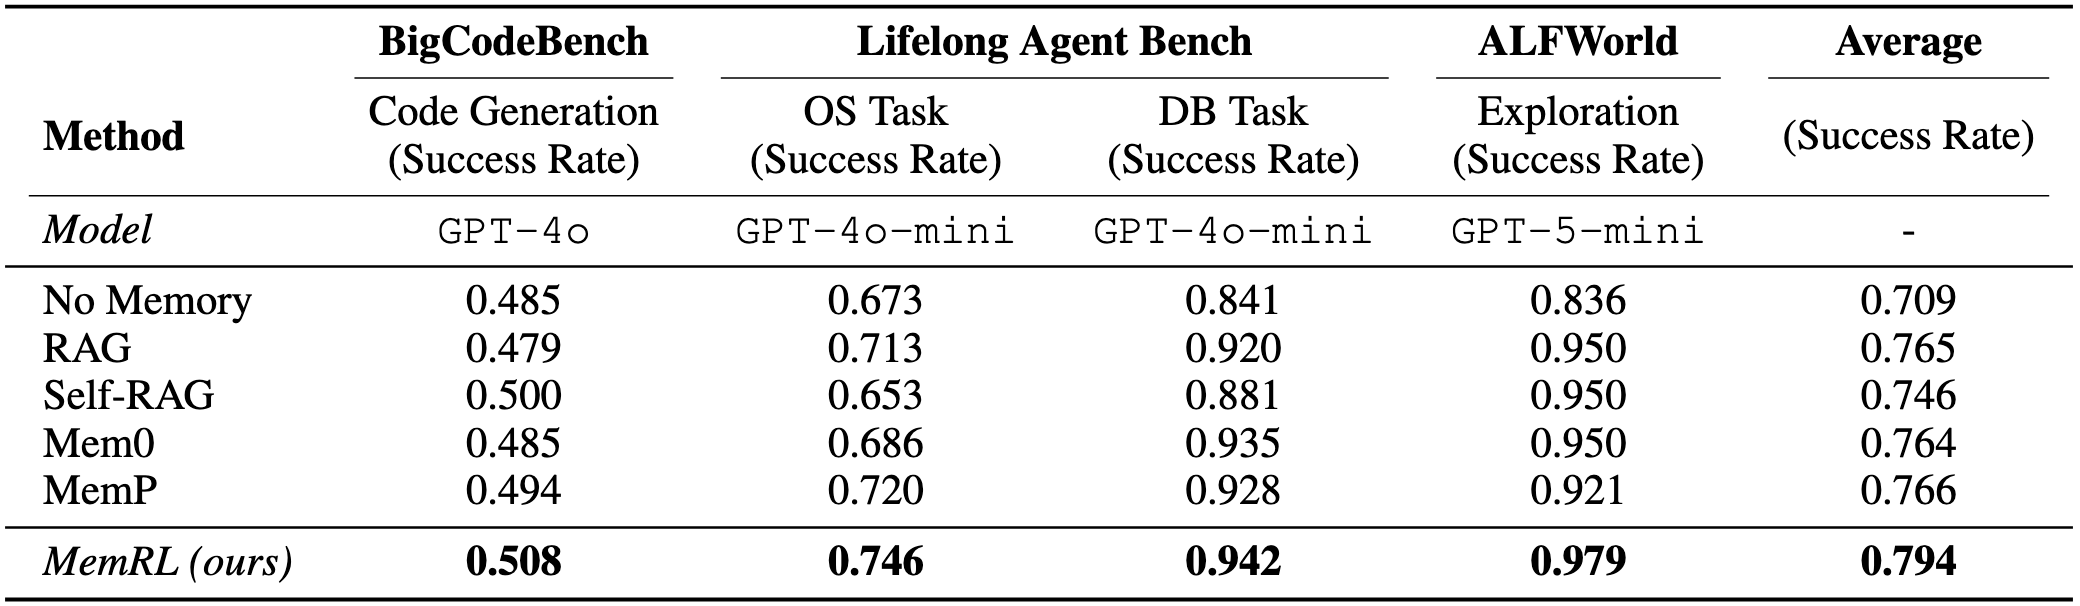
表源:Zhang et al., 2026,Table 2。
| 方法 | BigCodeBench | OS Task | DB Task | ALFWorld | 平均 |
|---|---|---|---|---|---|
| No Memory | 0.485 | 0.673 | 0.841 | 0.836 | 0.709 |
| RAG | 0.479 | 0.713 | 0.920 | 0.950 | 0.765 |
| Self-RAG | 0.500 | 0.653 | 0.881 | 0.950 | 0.746 |
| Mem0 | 0.485 | 0.686 | 0.935 | 0.950 | 0.764 |
| MemP | 0.494 | 0.720 | 0.928 | 0.921 | 0.766 |
| MemRL | 0.508 | 0.746 | 0.942 | 0.979 | 0.794 |
MemRL 在四个任务上都取得了最高结果。
这说明它学到的不只是对原始任务的答案缓存,还包含一定可迁移的策略,例如:
- 代码结构;
- 工具调用顺序;
- 数据库查询模式;
- 环境探索步骤;
- 常见失败规避方法。
十四、消融实验:运行时强化学习是否有效?
论文 Figure 4 对比了带有运行时 RL 的 MemRL 和普通记忆方法。
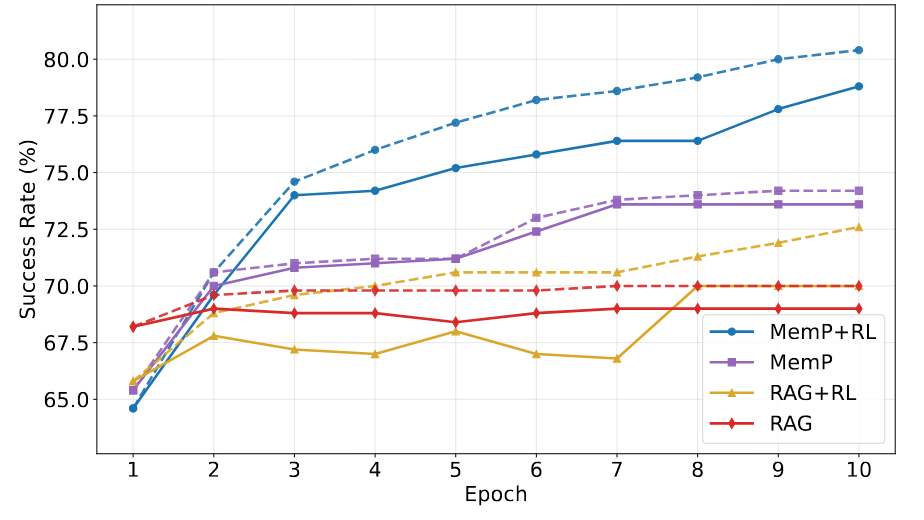
图源:Zhang et al., 2026,Figure 4。
实验中:
- MemRL 与 MemP 对比;
- 带 Q 值更新的 RAG 变体与普通 RAG 对比。
在初始阶段,各方法表现接近。
随着 epoch 增加:
- MemRL 的成功率逐渐提高;
- CSR 差距持续扩大;
- 学习曲线更加平稳。
这说明性能提升不是单纯来自“存了更多经验”,而是来自:
环境反馈逐渐改变了记忆的价值排序。
普通记忆系统虽然也不断积累内容,却无法区分哪些经验真正有效,因此记忆增加也可能增加噪声。
十五、Q 值权重的影响
论文使用 λ \lambda λ 控制语义相似度与 Q 值的权重:
score = ( 1 − λ ) sim ^ + λ Q ^ \operatorname{score}=(1-\lambda)\widehat{\operatorname{sim}}+\lambda\widehat{Q} score=(1−λ)sim +λQ
论文测试:
λ = 0
λ = 0.25
λ = 0.5
λ = 0.75
λ = 1
结果如 Figure 5 所示。
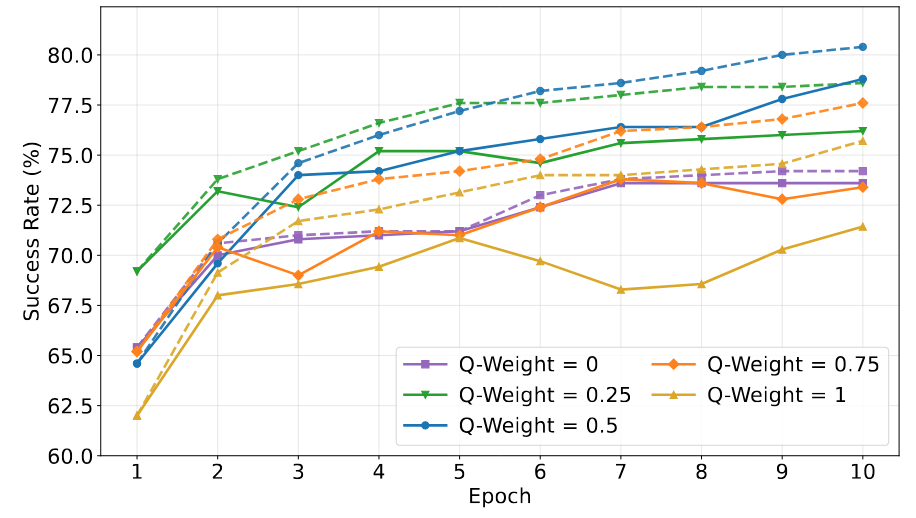
图源:Zhang et al., 2026,Figure 5。
结果整体呈倒 U 型, λ = 0.5 \lambda=0.5 λ=0.5 表现最好。
1. λ = 0
此时系统只考虑语义相似度:
score = similarity
系统无法过滤“语义相关但历史上无效”的经验,因此性能较早进入平台期。
2. λ = 1
此时系统只考虑 Q 值:
score = Q
高 Q 记忆可能与当前任务不够相关,导致上下文脱离当前意图,并带来较大波动。
3. λ = 0.5
相似度和效用具有相同权重,实现了:
相关性
+
历史有效性
之间的平衡。
这项实验说明,Q 值不能完全替代语义检索,它更适合被视为第二阶段的价值校正信号。
十六、跨任务优化与单任务反思
论文 Table 3 比较了:
- Single-Task Reflection:只利用当前任务自己的历史反馈;
- MemRL Cross-Task:允许从其他相似任务中召回经验。
| 设置 | BigCodeBench | OS | DB | ALFWorld | HLE | 平均 |
|---|---|---|---|---|---|---|
| Single-Task Reflection | 0.614 | 0.714 | 0.938 | 0.930 | 0.610 | 0.761 |
| MemRL Cross-Task | 0.627 | 0.804 | 0.972 | 0.981 | 0.606 | 0.798 |
1. OS Task
跨任务记忆从:
0.714 → 0.804
绝对提升 9 个百分点。
这说明不同操作系统任务之间存在可复用的程序性策略。
2. ALFWorld
跨任务记忆提升:
0.930 → 0.981
绝对提升 5.1 个百分点。
环境探索、物品定位和动作顺序具有较强的可迁移性。
3. HLE
Single-Task Reflection 为:
0.610
MemRL 为:
0.606
两者基本持平,单任务反思还略高。
论文认为,HLE 内部问题平均语义相似度较低,不同问题之间很难共享经验。
因此,MemRL 的跨任务优势具有一个重要前提:
任务分布中必须存在足够多可以复用的结构或策略。
如果任务之间完全无关,MemRL 会逐渐退化为类似单任务反思的方法。
十七、召回数量的敏感度
论文测试了三组召回配置:
稀疏:
k1 = 3,k2 = 1

中等:
k1 = 5,k2 = 3

密集:
k1 = 10,k2 = 5
其中:
- k 1 k_1 k1 是第一阶段召回的候选数量;
- k 2 k_2 k2 是第二阶段最终加入上下文的经验数量。
结果如 Figure 6 所示。
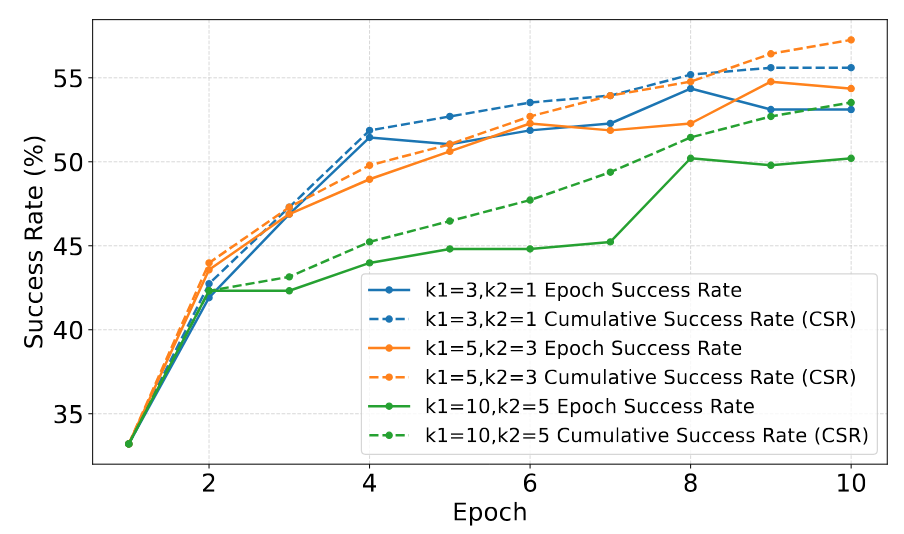
图源:Zhang et al., 2026,Figure 6。
结果同样呈倒 U 型:
- 召回过少,经验不足;
- 召回过多,上下文噪声增加;
- 中等配置表现最好。
最优配置为:
k1 = 5
k2 = 3
这说明:
记忆系统的效果并不随着召回数量单调增加。
关键是提高有用信息与噪声之间的比例,而不是把尽可能多的历史经验塞进上下文。
十八、Q Critic 是否真的能够预测任务成功?
Q 值的核心作用是估计一条记忆未来是否有用。
如果 Q 值与真实成功率无关,那么价值感知检索就没有意义。
论文 Figure 7 将记忆按 Q 值分组,并统计每组经验对应的下游任务成功率。
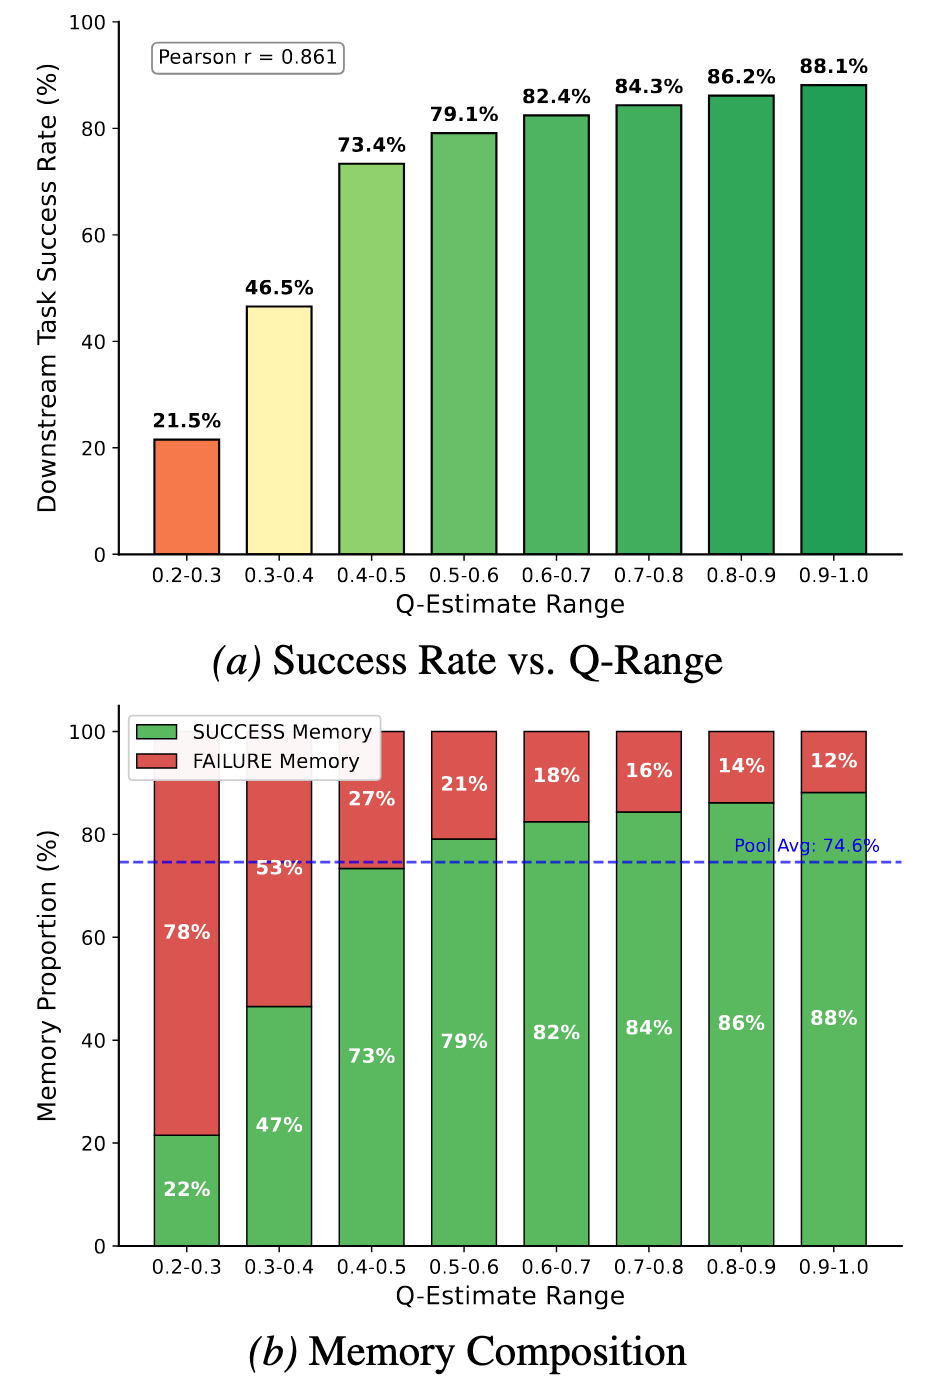
图源:Zhang et al., 2026,Figure 7。
1. Q 值和成功率高度相关
最低 Q 值区间的任务成功率为:
21.5%
最高 Q 值区间为:
88.1%
Pearson 相关系数为:
r = 0.861
这说明 Q 值与真实成功概率存在较强正相关。
因此,Q Critic 确实能够用于区分高效用和低效用经验。
2. 高 Q 记忆中仍然存在失败经验
在最高 Q 值区间中,大约仍有:
12%
的记忆来自失败任务。
这说明 Q 值并不是简单记录:
成功经验 = 1
失败经验 = 0
部分失败轨迹虽然没有直接完成任务,但可能包含有用信息,例如:
- 找到了正确的工具;
- 排除了错误路径;
- 暴露了关键环境约束;
- 只在最后一步出错;
- 提供了可以迁移的局部策略。
因此,失败经验也可能具有较高的程序性价值。
十九、MemRL 的稳定性与遗忘
论文从 Success Rate 和 CSR 的差距分析记忆系统的稳定性。
如果某种方法的 CSR 不断提高,但当前 Success Rate 明显下降,说明:
系统过去曾解决过这些任务,
但当前已经无法再次完成。
这可以被视为一种遗忘。
论文 Figure 8 比较了 MemRL 和 MemP 在 HLE 上的长期曲线。
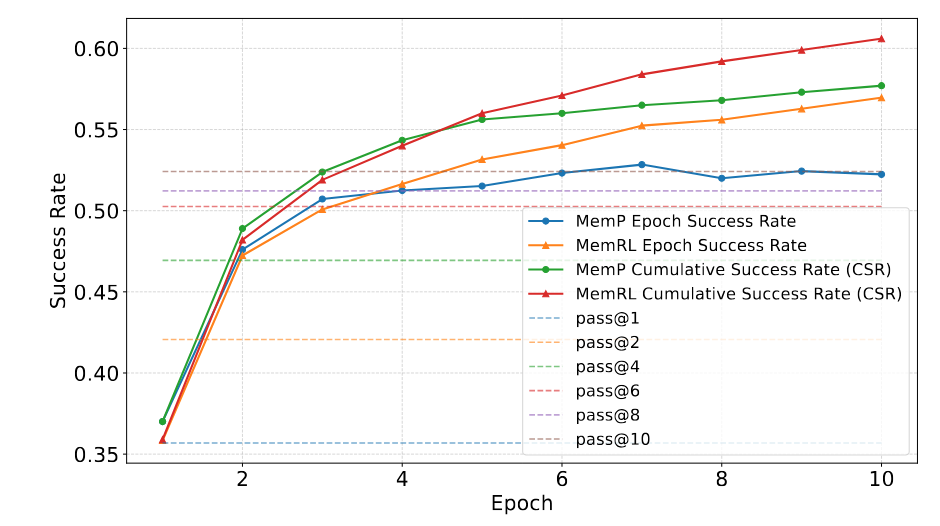
图源:Zhang et al., 2026,Figure 8。
MemP 的 CSR 和当前成功率之间逐渐出现更大差距,而 MemRL 的两条曲线增长更加同步。
论文还定义了遗忘率:
FR = N l o s t N f a i l \operatorname{FR}=\frac{N_{\mathrm{lost}}}{N_{\mathrm{fail}}} FR=NfailNlost
其中:
- N l o s t N_{\mathrm{lost}} Nlost 表示此前成功、当前变为失败的任务数量;
- N f a i l N_{\mathrm{fail}} Nfail 表示当前 epoch 中失败任务总数。
实验结果为:
MemRL:0.041
MemP:0.051
移除 z-score 标准化和相似度门控后,遗忘率上升到:
0.073
这说明以下两项设计对稳定性很重要:
- 先用严格语义阈值过滤无关经验;
- 标准化相似度和 Q 值,防止某个信号异常主导排序。
二十、跨模型记忆迁移
论文附录还进行了一个很有意思的实验:
用强模型积累经验,再把记忆库直接交给其他模型使用。
研究者首先用 Gemini-3-pro 在 HLE 上运行 10 个 epoch,得到成熟记忆库。
随后,不进行任何微调,直接把这份记忆交给三个不同模型。
| 推理模型 | 原始得分 | 使用迁移记忆 | 绝对提升 |
|---|---|---|---|
| Qwen3-235B | 0.150 | 0.531 | +0.381 |
| Gemini-3-flash | 0.347 | 0.583 | +0.236 |
| GPT-5.2 High | 0.354 | 0.571 | +0.217 |
Qwen3-235B 的结果提升超过三倍,Gemini-3-flash 接近翻倍。
这说明 MemRL 记忆中保存的并不完全是特定模型的输出习惯,而可能包含相对通用的:
- 解题模板;
- 代码框架;
- 推理策略;
- 问题拆解方式;
- 常见错误规避方案。
从工程角度看,记忆库可以成为一种可迁移的外部能力模块:
强模型负责探索并积累经验
→ 弱模型通过召回继承这些经验
不过,不同模型对经验格式和指令的理解能力仍然不同,迁移效果不一定在所有任务中都如此明显。
二十一、MemRL 的优势
1. 不需要更新模型参数
运行时学习发生在外部记忆中,不需要:
- 反向传播;
- 保存优化器状态;
- 在线微调;
- 修改推理模型。
因此,它更容易接入闭源 API 模型。
2. 能够利用环境反馈
MemRL 不只保存任务轨迹,还利用成功或失败奖励学习经验价值。
这让系统可以逐渐区分:
看起来相关
和:
实际有帮助
3. 支持跨任务经验迁移
相似任务可以共享程序性经验,尤其适合:
- 操作系统任务;
- 数据库任务;
- 代码任务;
- 环境探索任务。
4. 可以保留模型稳定性
模型权重保持冻结,因此不会因为记忆更新直接破坏模型已有能力。
5. 记忆库具有一定可移植性
一套由强模型积累的经验,可以被其他推理模型复用。
6. 能学习失败经验的潜在价值
Q 值并不是简单的成功标签,还能识别具有局部价值的失败轨迹。
二十二、局限性
1. 单步 Q 值更新可能存在较高方差
当前方法主要根据单次任务结果更新经验:
Q n e w = Q o l d + α ( r − Q o l d ) Q_{\mathrm{new}}=Q_{\mathrm{old}}+\alpha(r-Q_{\mathrm{old}}) Qnew=Qold+α(r−Qold)
在长轨迹任务中,最终奖励可能受到很多步骤共同影响。
如果只根据最终成功或失败更新所有被召回经验,容易产生噪声。
未来可以考虑:
- 多步 TD 更新;
- 周期性记忆巩固;
- 更平滑的奖励估计;
- 根据轨迹阶段分配奖励。
2. 多条记忆之间存在信用分配问题
如果一次任务同时召回三条经验,并最终成功,很难准确判断:
是哪一条经验真正发挥了作用?
当前方法会更新所有被加入上下文的记忆,可能把奖励错误分配给无关经验。
论文提出未来可以使用:
- Shapley Value;
- 价值分解;
- 多智能体强化学习中的信用分配方法。
3. 依赖可获得的环境奖励
MemRL 需要知道任务是否成功。
这在以下任务中比较容易:
- 单元测试;
- 数据库执行;
- 文件操作;
- ALFWorld 环境任务。
但在开放式对话中,奖励不容易定义:
这次建议究竟算成功还是失败?
用户是否真的满意?
一段回答的长期价值如何判断?
因此,MemRL 更适合具有明确反馈信号的任务环境。
4. 任务相似度较低时,跨任务学习有限
HLE 实验表明,当任务之间缺少共享结构时,跨任务记忆的优势明显减弱。
这意味着 MemRL 不是在任意任务分布下都能持续获得同样幅度的提升。
5. 记忆库会持续增长
每次任务都会生成新的经验三元组。
长期运行后可能出现:
- 重复经验;
- 相似策略;
- 低价值记忆积累;
- 检索成本增加;
- Q 值更新次数不均衡。
论文尚未系统解决长期记忆合并、压缩和淘汰问题。
6. 理论分析依赖较强假设
稳定性分析主要假设:
- 推理模型冻结;
- 任务分布平稳;
- 奖励分布相对稳定。
现实 Agent 环境中可能存在:
- 模型 API 升级;
- 用户行为变化;
- 工具接口变化;
- 任务分布漂移;
- 奖励标准变化。
这些因素都可能影响 Q 值的长期有效性。
7. 低 Q 不一定意味着记忆应被删除
某条经验可能只对少数特殊任务有效。
如果它在多数任务上表现较差,Q 值可能偏低,但这不代表它没有保留价值。
更细粒度的方案可能需要学习:
Q(intent, experience)
而不是为每条经验维护过于全局化的单一效用。
二十三、和 Memory-R1、AgeMem、Mem0、A-Mem 的区别
| 方法 | 学习对象 | 是否更新模型权重 | 核心机制 |
|---|---|---|---|
| Memory-R1 | 记忆写入和利用策略 | 是 | 强化学习训练记忆管理策略 |
| AgeMem | STM/LTM 工具调用策略 | 是 | 渐进式 RL 统一记忆动作 |
| Mem0 | 事实记忆生命周期 | 否 | ADD、UPDATE、DELETE、NOOP |
| A-Mem | 记忆链接与结构 | 否 | 动态建链和记忆演化 |
| MemRL | 记忆的任务效用和召回策略 | 否 | Q 值更新与两阶段价值召回 |
1. MemRL 和 Memory-R1
Memory-R1 通过强化学习训练模型,使其学会:
- 写入哪些记忆;
- 如何更新记忆;
- 如何利用已有记忆。
强化学习结果进入模型参数。
MemRL 则保持模型参数冻结,只更新外部记忆的 Q 值。
Memory-R1:
学习发生在模型参数中。

MemRL:
学习发生在记忆效用中。
2. MemRL 和 AgeMem
AgeMem 将添加、更新、删除、总结、过滤和召回等操作暴露为工具,让 Agent 通过强化学习学会何时操作短期和长期记忆。
MemRL 不重点学习完整的记忆操作流程,而是聚焦:
在已有经验中应该选择哪几条?
因此,AgeMem 更偏记忆管理策略,MemRL 更偏经验价值学习。
3. MemRL 和 Mem0
Mem0 主要处理自然语言事实:
用户喜欢什么?
用户在哪里工作?
哪些事实已经变化?
MemRL 主要处理程序性经验:
这个任务应该怎样完成?
哪套策略过去更有效?
某类环境应该使用什么操作顺序?
可以简单理解为:
Mem0:
记住“是什么”。

MemRL:
记住“怎么做”,并学习哪种做法更有效。
4. MemRL 和 A-Mem
A-Mem 通过关键词、标签和动态链接组织记忆,使记忆网络能够不断演化。
MemRL 不重点构建复杂关系图,而是为记忆增加可学习的效用信号。
二者可以结合:
A-Mem:
负责结构化关联和多跳扩展。

MemRL:
负责根据环境反馈学习每条经验的价值。
二十四、我的理解和启发
这篇论文给我的最大启发是:
Agent 记忆系统不应该只学习“记住什么”,还应该学习“哪些记忆值得相信和复用”。
1. 相似度不等于有效性
自己做记忆系统时,通常会使用:
- 向量相似度;
- BM25;
- 标签匹配;
- 规则召回。
这些方法主要衡量相关性,却没有衡量使用结果。
可以为每条程序性记忆增加:
success_count
failure_count
utility_score
last_reward
usage_count
last_used_at
让检索排序同时考虑:
语义相关度
+
历史成功率
+
使用次数
+
最近表现
2. 事实记忆和经验记忆应该分开
自己的 Agent 记忆可以区分:
事实记忆
用户目标岗位是 AI Agent 开发。
项目使用 BM25 和向量混合召回。
适合使用 Mem0 式增改删。
经验记忆
修改大型代码库前先读取入口文件和依赖关系;
工具结果过长时应先落盘再保留引用;
处理 Redis 连接错误时先检查服务和端口。
适合使用 MemRL 式效用学习。
二者的更新逻辑不应该完全相同。
3. 可以为工具调用经验增加奖励
在代码 Agent 中,可以使用自然反馈作为奖励:
| 环境反馈 | 奖励示例 |
|---|---|
| 测试全部通过 | 1.0 |
| 部分测试通过 | 0.5 |
| 编译失败 | 0 |
| 工具调用报错 | 0 |
| 用户接受修改 | 1.0 |
| 用户要求回滚 | 0 |
然后更新实际使用经验的效用值。
4. 两阶段召回值得直接借鉴
可以把自己的混合检索改成:
第一阶段:
BM25 + 向量检索,获得语义相关候选。

第二阶段:
综合相关性、历史成功率和置信度重排。
例如:
score = w 1 ⋅ similarity + w 2 ⋅ utility + w 3 ⋅ confidence \operatorname{score}=w_1\cdot\operatorname{similarity}+w_2\cdot\operatorname{utility}+w_3\cdot\operatorname{confidence} score=w1⋅similarity+w2⋅utility+w3⋅confidence
为了适配 CSDN 和工程实现,这里使用简化表达。
5. 不要简单删除失败经验
失败经验可能包含:
- 已经验证无效的方案;
- 需要避免的参数;
- 某个工具的限制;
- 失败发生的位置;
- 可以复用的前半段步骤。
因此,可以将经验总结为:
有效步骤
失败原因
适用条件
不可用条件
而不是只保留成功轨迹。
6. 需要处理多记忆信用分配
如果一次任务使用了多条经验,可以先使用简单方法:
被直接引用的核心经验:
获得完整奖励。

仅作为辅助背景的经验:
获得折扣奖励。

未被模型实际采用的经验:
不更新。
后续可以根据模型生成内容与经验之间的引用关系,做更精细的价值归因。
7. 可以与现有记忆模块组合
结合前面阅读的论文,可以设计:
Mem0:
维护用户事实的新增、更新和删除。

Zep:
保存关系和时间变化。

GAM:
在语义边界后再固化长期记忆。

A-Mem:
建立经验之间的结构化关联。

MemRL:
利用环境反馈更新经验的效用值。

LightMem:
离线合并、压缩和清理低价值记忆。
这几个方法分别作用于记忆生命周期的不同阶段,并不互相冲突。
二十五、未来可以如何改造自己的项目?
可以在当前结构化记忆系统中,为经验记忆增加如下结构:
{
  "intent": "修复 Redis 连接失败",
  "experience": {
    "strategy": "先检查 redis-server 是否运行,再检查端口和配置文件",
    "successful_steps": [
      "使用 ps 或 brew services 检查 Redis 状态",
      "使用 lsof 检查端口占用",
      "确认客户端连接地址"
    ],
    "failure_notes": [
      "只修改代码无法解决服务未启动的问题"
    ]
  },
  "utility": 0.72,
  "usage_count": 5,
  "success_count": 4,
  "failure_count": 1,
  "source_task": "redis_connection_error",
  "embedding": "..."
}
召回可以分成:
Query
→ Intent embedding 召回 Top-5
→ 相似度阈值过滤
→ 相似度与 utility 联合排序
→ 选择 Top-3
→ 加入 Agent 上下文
任务结束后:
自动测试 / 工具反馈 / 用户确认
→ 生成 reward
→ 更新 utility
→ 总结本轮新经验
→ 写入记忆库
这种改造不需要训练模型参数,比较适合本地 Agent 项目。
二十六、总结
本文提出了 MemRL,一种通过情景记忆上的非参数强化学习实现 Agent 运行时自我进化的方法。
现有记忆系统通常使用语义相似度召回经验,但“语义相关”并不等于“实际有用”。MemRL 为每条经验增加 Q 值,根据环境反馈持续学习经验的任务效用。
MemRL 将记忆表示为:
Intent
+
Experience
+
Utility
其中:
- Intent 描述经验对应的原始任务;
- Experience 保存解决策略或执行轨迹;
- Utility 使用 Q 值表示经验的预期任务回报。
在召回阶段,MemRL 使用两阶段策略:
- 根据语义相似度召回候选经验;
- 根据相似度和 Q 值联合排序,选择真正有用的记忆。
在任务结束后,系统根据环境奖励更新被使用经验的 Q 值:
Q n e w = Q o l d + α ( r − Q o l d ) Q_{\mathrm{new}}=Q_{\mathrm{old}}+\alpha(r-Q_{\mathrm{old}}) Qnew=Qold+α(r−Qold)
同时,当前执行轨迹会被总结成新经验写入记忆库。
实验结果表明:
- MemRL 在四类任务上的平均 CSR 达到 0.798;
- 相比最强 baseline MemP 提升 3.8 个百分点;
- 在 OS 和 ALFWorld 上均提升 6.2 个百分点;
- 迁移任务平均成功率达到 0.794;
- 相似度和 Q 值各占一半时效果最好;
- 中等召回规模 k 1 = 5 , k 2 = 3 k_1=5,k_2=3 k1=5,k2=3 表现最好;
- Q 值与下游成功率的 Pearson 相关系数达到 0.861;
- MemRL 的平均遗忘率为 0.041,低于 MemP 的 0.051;
- 强模型积累的记忆可以直接迁移给其他模型使用。
整体来看,MemRL 的核心价值在于:
它把强化学习从模型参数空间转移到了外部记忆空间。
Agent 不需要频繁微调模型,也可以通过持续交互逐渐学习:
- 哪些经验值得复用;
- 哪些经验只是语义相似的噪声;
- 哪些失败轨迹仍然包含有价值的策略;
- 哪些经验能够迁移到其他任务和模型。
这为 Agent 运行时持续学习提供了一条相对轻量的路径:
模型保持稳定,记忆持续进化。
参考资料
- Zhang S, Wang J, Zhou R, et al. MemRL: Self-Evolving Agents via Runtime Reinforcement Learning on Episodic Memory. arXiv preprint, 2026.
- 代码仓库:https://github.com/MemTensor/MemRL
Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐
 21
 0
- 0


 已为社区贡献17条内容

所有评论(0)