【Python系列课程】NumPy数组计算(下):向量化运算、广播机制与聚合函数
17 NumPy数组计算(下):向量化运算、广播机制与聚合函数
上篇我们讲了NumPy数组的创建、索引切片和基本属性。本篇继续深入,把NumPy真正"用起来"——向量化运算让你摆脱for循环,广播机制让你用不同形状的数组直接做运算,聚合函数让你一行代码完成统计摘要。这三板斧,是NumPy在数据分析里真正的杀手锏。
一、为什么NumPy运算比Python快?
先来回答这个根本问题。Python的列表做运算,本质上是逐个元素循环,速度慢得可怜。NumPy的数组运算是向量化(Vectorization) 的——底层用C/Fortran实现,一次指令处理整块数据,速度快几十倍甚至上百倍。
import numpy as np
import time

# Python列表:要计算100万元素的平方
lst = list(range(1000000))
start = time.time()
result = [x**2 for x in lst]
print(f"列表推导耗时: {time.time() - start:.4f}秒")

# NumPy数组:同样的操作
arr = np.arange(1000000)
start = time.time()
result = arr ** 2
print(f"NumPy向量化耗时: {time.time() - start:.4f}秒")
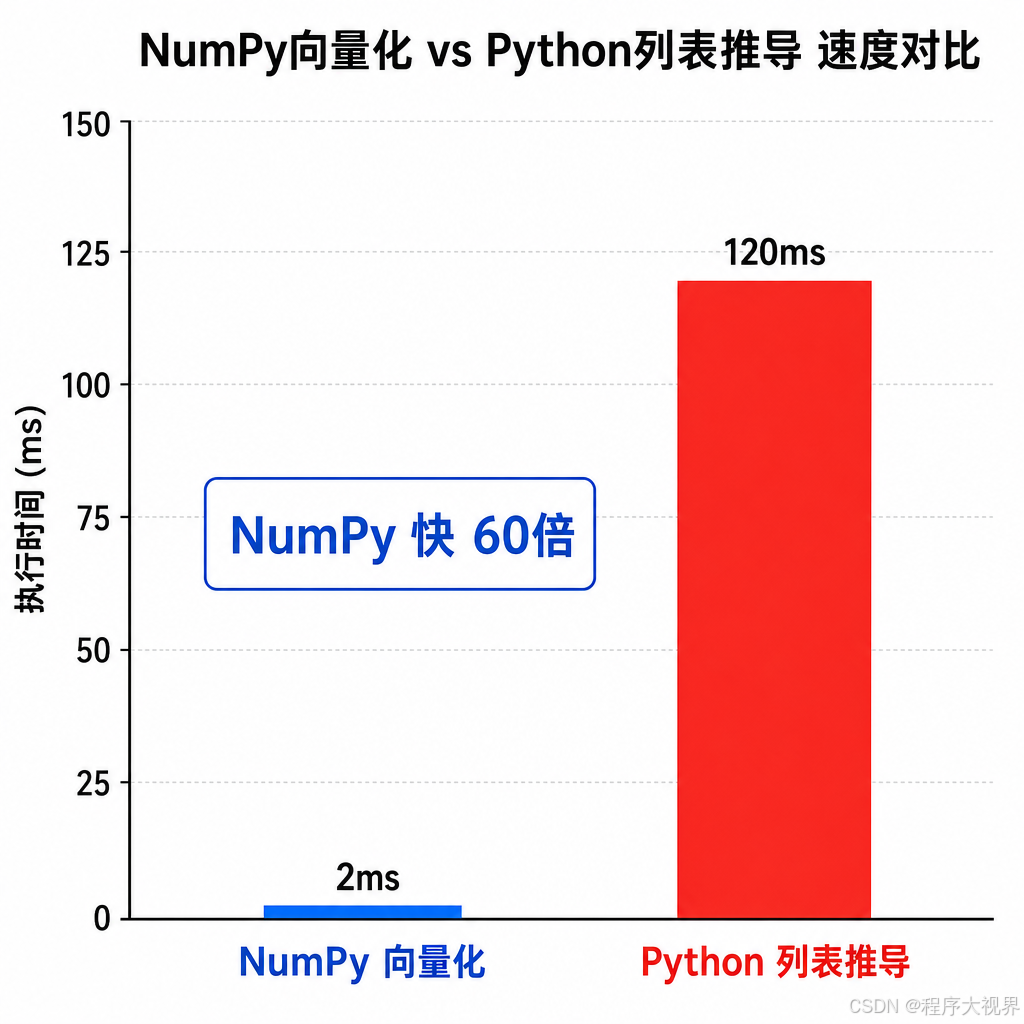
运行一下你就明白差距了。在笔者的机器上,列表推导大约需要120ms,而NumPy几乎瞬间完成(约2-3ms)。这不是10%的提升,是两个数量级的差距。
二、向量化运算:告别for循环
2.1 算术运算直接写
NumPy数组的算术运算符(+ - * / ** % //)都是逐元素(element-wise) 操作的,不需要写循环:
import numpy as np

a = np.array([1, 2, 3, 4, 5])
b = np.array([10, 20, 30, 40, 50])

print(a + 2)      # [ 3  4  5  6  7]  每个元素加2
print(a * 3)       # [ 3  6  9 12 15]  每个元素乘3
print(a ** 2)      # [ 1  4  9 16 25]  每个元素平方
print(a + b)        # [11 22 33 44 55]  逐元素相加
print(a * b)        # [10 40 90 160 250] 逐元素相乘
print(b / a)        # [10. 10. 10. 10. 10.] 逐元素相除
print(b % a)        # [ 0  0  0  0  0]  逐元素取余
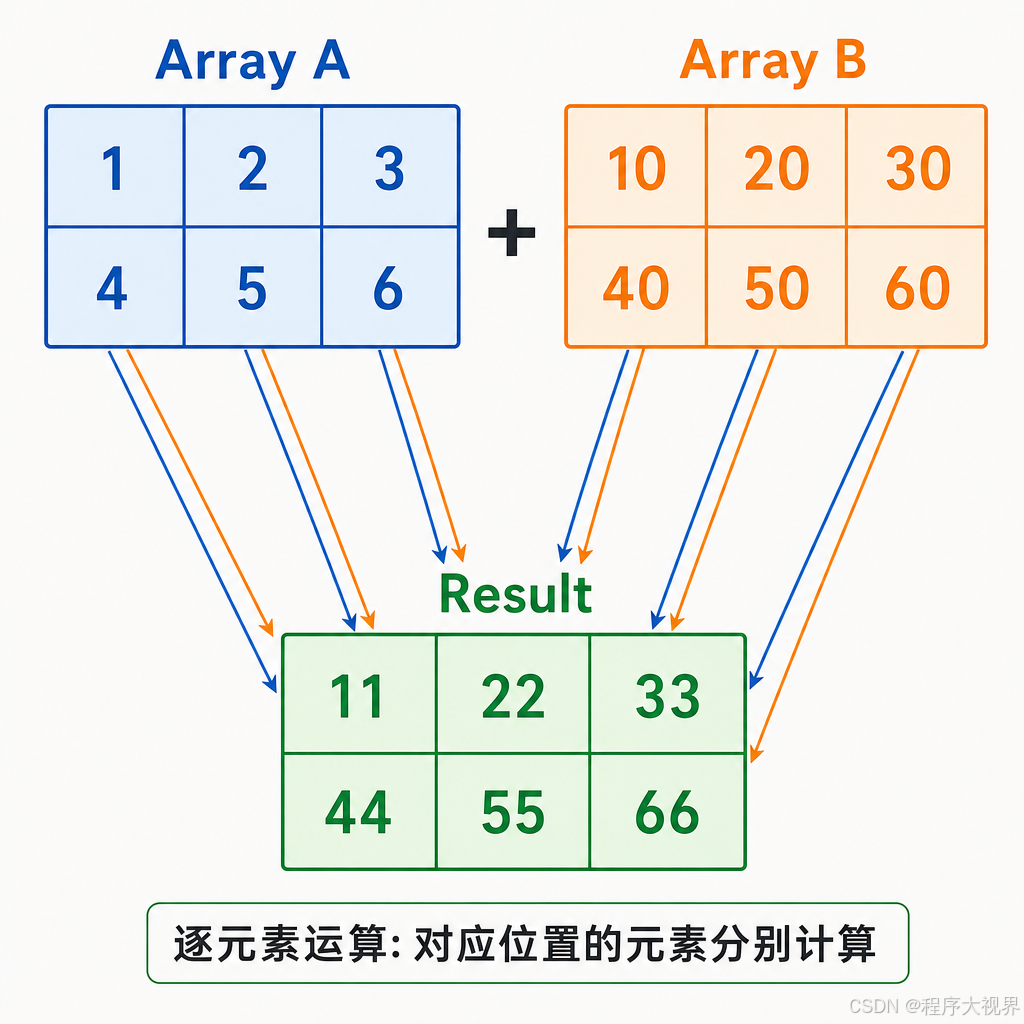
注意:* 是逐元素乘法,不是矩阵乘法!矩阵乘法用 @ 或 np.matmul(),这个后面会讲。
2.2 比较运算也返回数组
比较运算符(> < >= <= == !=)对数组使用时,返回的是布尔数组,这在数据筛选时极其有用:
scores = np.array([85, 92, 78, 55, 98, 61, 73])

print(scores > 80)
# [ True  True False False  True False False]

print(scores == 98)
# [False False False False  True False False]

# 结合布尔索引,一行代码筛选出所有及格分数
passed = scores[scores >= 60]
print(passed)   # [85 92 78 98 61 73]
这张表总结了所有可用的逐元素比较函数:
| 函数 | 运算符 | 说明 |
|---|---|---|
np.greater(a, b) | a > b | 大于 |
np.greater_equal(a, b) | a >= b | 大于等于 |
np.less(a, b) | a < b | 小于 |
np.less_equal(a, b) | a <= b | 小于等于 |
np.equal(a, b) | a == b | 等于 |
np.not_equal(a, b) | a != b | 不等于 |
2.3 通用函数(ufunc):NumPy的运算引擎
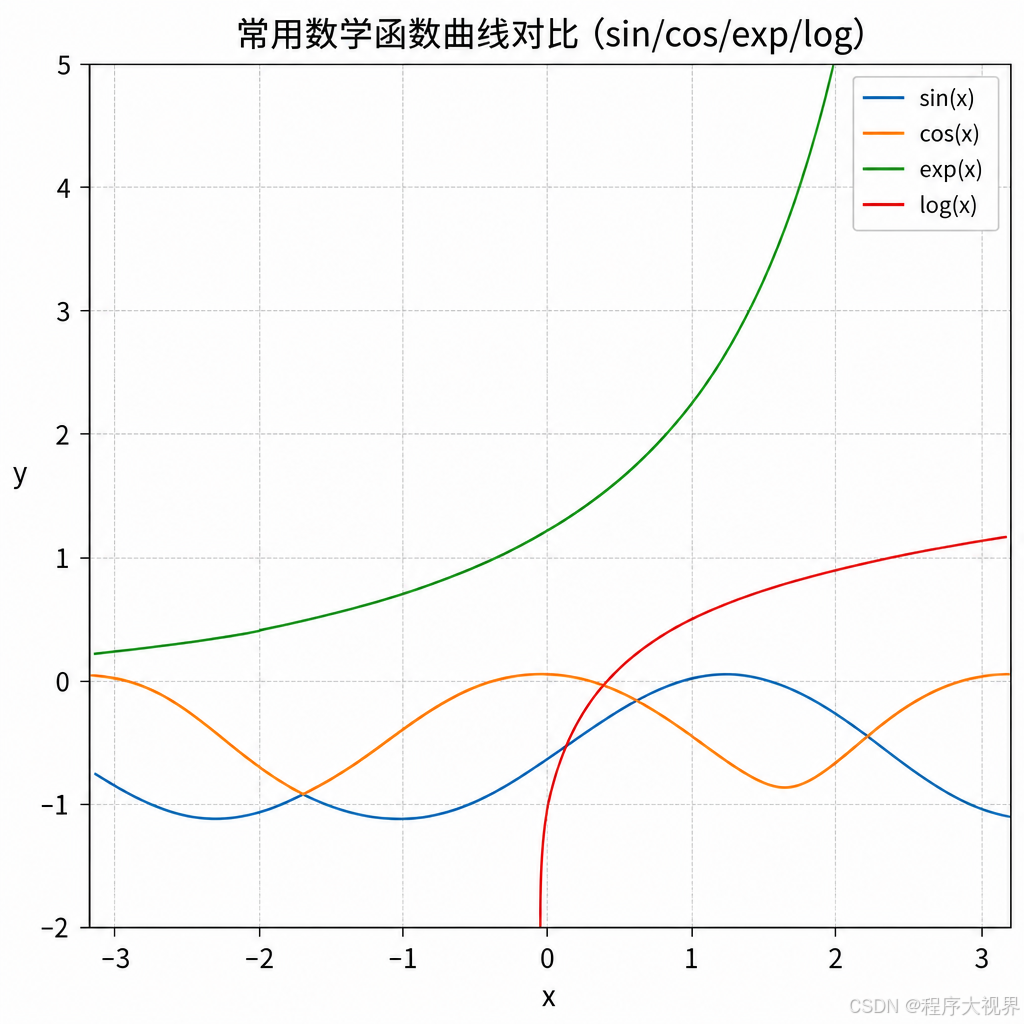
NumPy里所有逐元素操作,底层都是通用函数(ufunc = universal function)。它们对ndarray的每个元素独立操作,支持广播(下一节讲)。常用的ufunc分两类:
数学函数:
x = np.array([0, np.pi/2, np.pi, np.pi*3/2])

print(np.sin(x))    # 正弦函数
print(np.cos(x))    # 余弦函数
print(np.tan(x))    # 正切函数
print(np.arcsin(np.array([0, 0.5, 1])))  # 反正弦
取整函数:
a = np.array([-1.7, -1.5, -0.2, 0.2, 1.5, 1.7, 2.0])

print(np.floor(a))  # 向下取整: [-2. -2. -1.  0.  1.  1.  2.]
print(np.ceil(a))   # 向上取整: [-1. -1. -0.  1.  2.  2.  2.]
对数函数:
print(np.exp(1))        # e的1次方: 2.718...
print(np.log(10))       # 自然对数: 2.302...
print(np.log2(8))      # 以2为底: 3.0
print(np.log10(100))    # 以10为底: 2.0
三、广播机制(Broadcasting):不同形状也能运算
这是NumPy最容易让初学者困惑、但也最强大的特性之一。
3.1 什么是广播?
广播指的是:当两个数组形状不同时,NumPy会自动"扩展"较小数组的形状,使其与较大数组兼容,然后再做运算。这个扩展是虚拟的(不占用额外内存)。
规则只有两条,记住就够用:
规则1:如果两个数组的后缘维度(trailing dimension) 相同,或者其中一个为1,则可以广播。
规则2:如果两个数组的维度数量不同,较小数组会在前面补1,使其维度数量一致。
说人话就是:从后往前比,要么相等,要么其中一个是1,就能运算。
3.2 广播实战
import numpy as np

# 案例1:数组 + 标量(最基础的广播)
arr = np.array([[1, 2, 3],
                [4, 5, 6]])
print(arr + 10)
# 标量10被广播成 [[10,10,10], [10,10,10]],然后逐元素相加
# 结果: [[11 12 13], [14 15 16]]

# 案例2:(3,3) 数组 + (3,) 数组
a = np.array([[1, 2, 3],
              [4, 5, 6],
              [7, 8, 9]])
b = np.array([10, 20, 30])   # shape: (3,)
print(a + b)
# b被广播成 [[10,20,30], [10,20,30], [10,20,30]]
# 结果: [[11 22 33], [14 25 36], [17 28 39]]

# 案例3:(2,3) 数组 + (3,) 数组
a = np.array([[1, 2, 3],
              [4, 5, 6]])   # shape: (2,3)
b = np.array([10, 20, 30])  # shape: (3,)
print(a + b)  # ✅ 可以运算,b沿着行方向广播

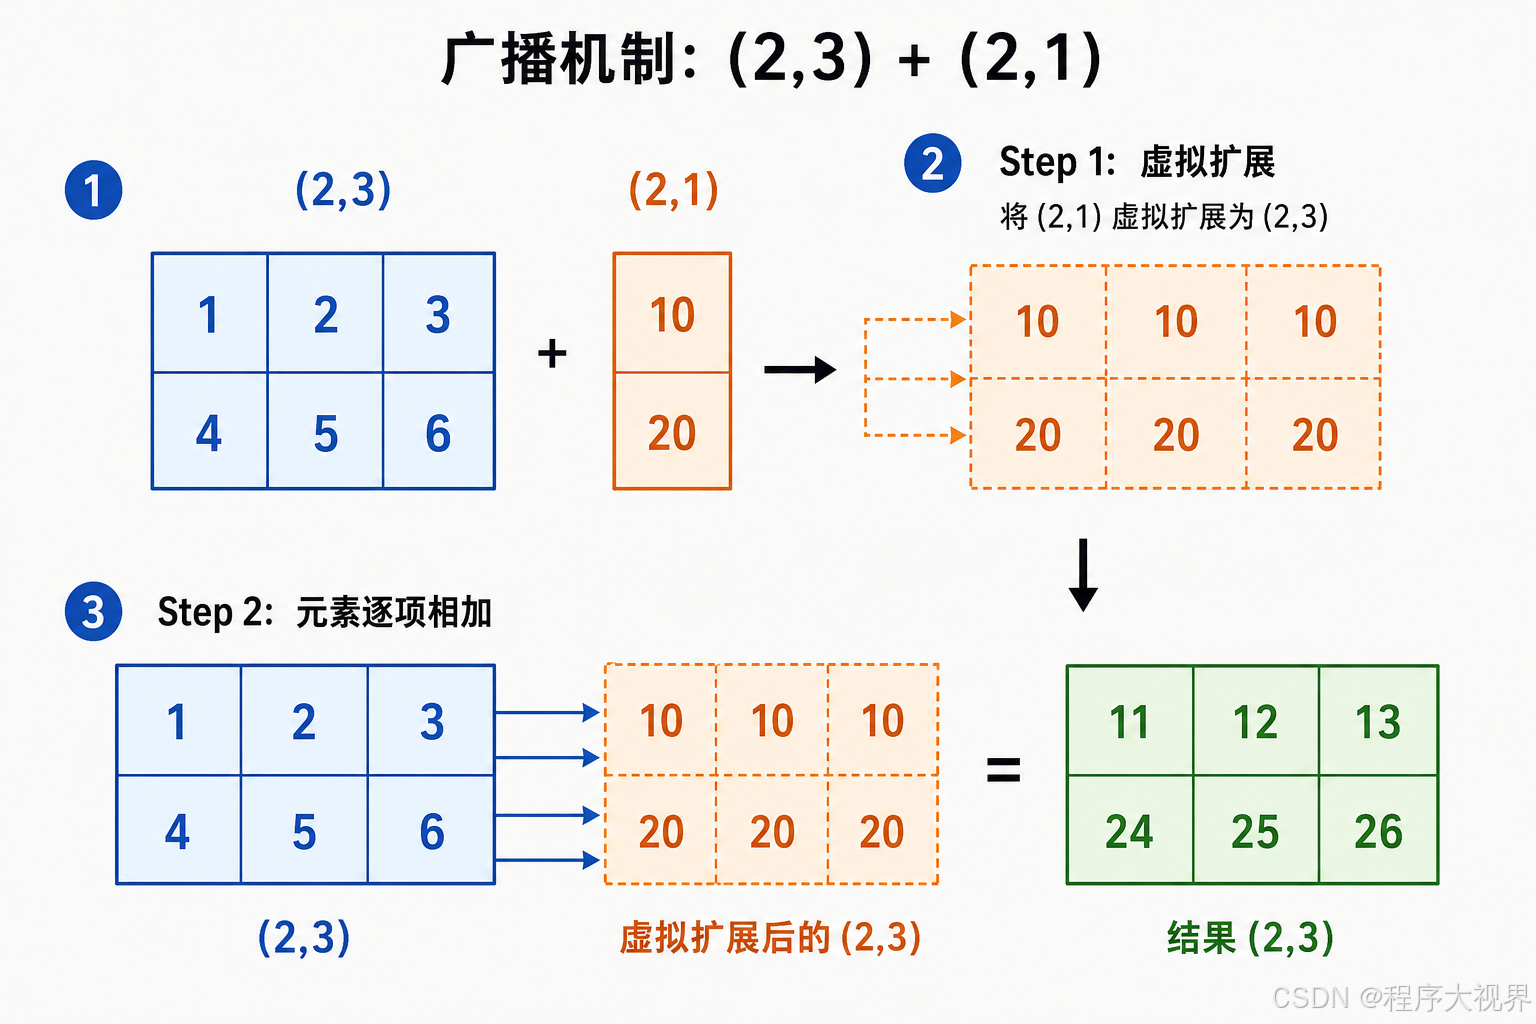
# 案例4:(2,3) 数组 + (2,1) 数组
a = np.array([[1, 2, 3],
              [4, 5, 6]])   # shape: (2,3)
b = np.array([[10],
              [20]])        # shape: (2,1)
print(a + b)
# b被广播成 [[10,10,10], [20,20,20]]
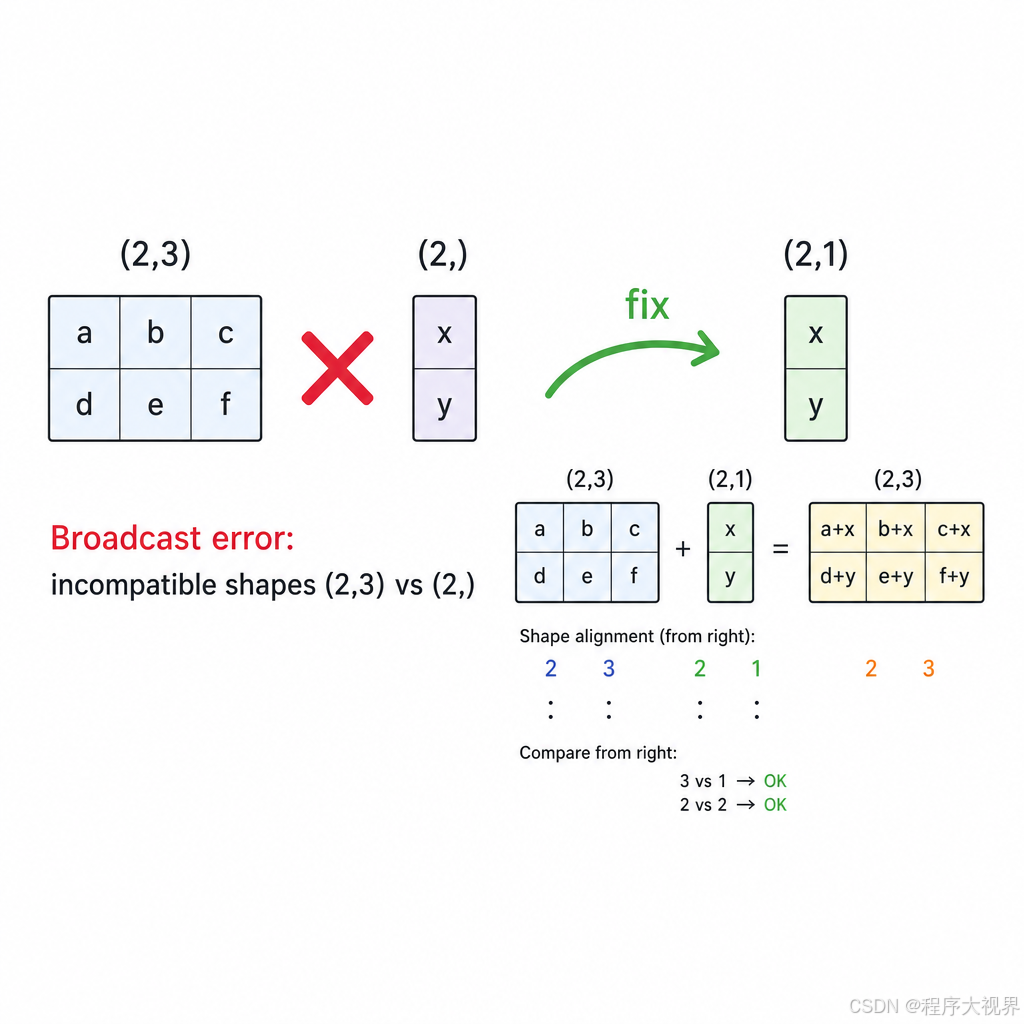
3.3 广播失败的典型错误
a = np.array([[1, 2, 3],
              [4, 5, 6]])   # shape: (2,3)
b = np.array([10, 20])       # shape: (2,) —— 后缘维度 2≠3,不能广播!

# print(a + b)  # ❌ ValueError: operands could not be broadcast together
解决方法:用 np.newaxis 或 reshape 手动调整形状:
b = np.array([10, 20])       # shape: (2,)
b_reshaped = b[:, np.newaxis] # shape: (2,1) —— 现在可以广播了!
print(a + b_reshaped)
3.4 广播规则速查表
| 数组A的shape | 数组B的shape | 能否广播 | 结果shape |
|---|---|---|---|
(2, 3) | (3,) | ✅ | (2, 3) |
(2, 3) | (2, 1) | ✅ | (2, 3) |
(3, 1) | (3,) | ✅ | (3, 3) |
(2, 3) | (2,) | ❌ | — |
(2, 3, 4) | (3, 4) | ✅ | (2, 3, 4) |
(2, 3, 4) | (1, 4) | ✅ | (2, 3, 4) |
四、聚合函数:一行代码搞定统计摘要
数据分析里最常见的需求是什么?算总和、平均值、最大最小值、标准差。NumPy把这些都封装成了聚合函数,而且比Python原生快得多。
4.1 基础聚合函数
import numpy as np

scores = np.array([[85, 92, 78],
                   [55, 98, 61],
                   [73, 88, 91]])

print(np.sum(scores))      # 全体总分: 721
print(np.mean(scores))     # 全体平均分: 80.11...
print(np.max(scores))      # 最高分: 98
print(np.min(scores))      # 最低分: 55
print(np.std(scores))      # 标准差: 约12.47
print(np.var(scores))      # 方差: 约155.58
print(np.prod(scores))     # 所有元素乘积(注意:结果会非常大!)
4.2 沿指定轴聚合(重点!)
这是最容易搞混的地方。axis=0 是沿着行方向(跨行计算,结果压缩行),axis=1 是沿着列方向(跨列计算,结果压缩列)。
scores = np.array([[85, 92, 78],   # 三个学生,三门课
                   [55, 98, 61],
                   [73, 88, 91]])

# axis=0:跨行计算(压缩行)→ 得到每列的统计值
print(np.sum(scores, axis=0))   # [213 278 230]  → 每门课的总分
print(np.mean(scores, axis=0))  # [71.0 92.7 76.7] → 每门课的平均分

# axis=1:跨列计算(压缩列)→ 得到每行的统计值
print(np.sum(scores, axis=1))   # [255 214 252]  → 每个学生的总分
print(np.mean(scores, axis=1))  # [85.0 71.3 84.0] → 每个学生的平均分
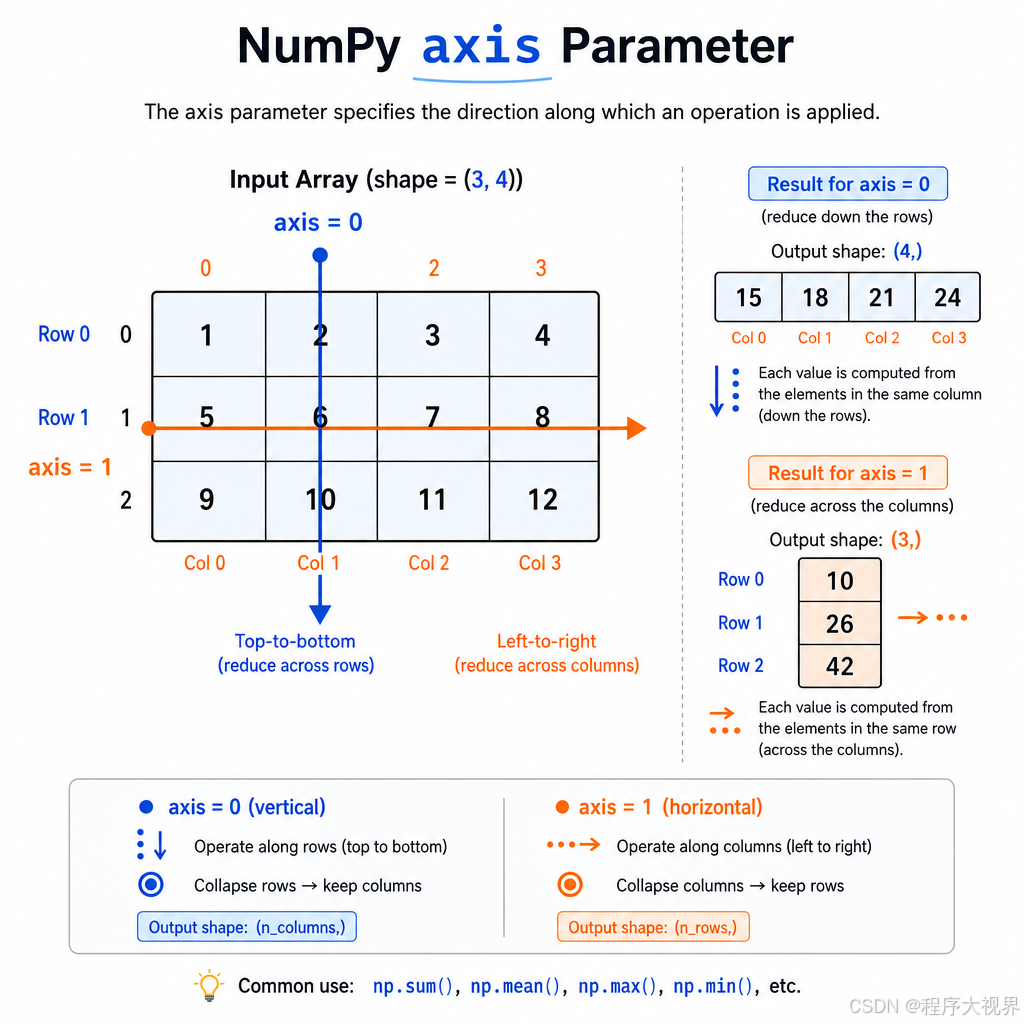
记忆口诀:axis=N 表示沿着第N个轴的方向计算,结果里第N维消失。
4.3 更多实用聚合函数
a = np.array([[3, 0, 7, 3],
              [4, 9, 6, 2],
              [8, 5, 11, 10]])

# 返回最大/最小值的索引(而不是值本身)
print(np.argmax(a, axis=0))  # [2 1 2 2] → 每列最大值的行索引
print(np.argmin(a, axis=1))  # [1 3 0]   → 每行最小值的列索引

# 返回非零元素的索引
print(np.nonzero(a > 5))
# (array([0, 1, 1, 2, 2, 2]), array([2, 1, 2, 0, 2, 3]))
# 解读:a>5 为True的位置是(0,2),(1,1),(1,2),(2,0),(2,2),(2,3)

# where:条件筛选的神器
# 只传condition:返回符合条件的元素索引(同nonzero)
print(np.where(a > 5))

# 传三个参数:condition成立返回x,不成立返回y
print(np.where(a > 5, "大", "小"))
# [['小' '小' '大' '小']
#  ['小' '大' '大' '小']
#  ['大' '小' '大' '大']]
4.4 聚合函数速查表
| 函数 | 说明 | 示例 |
|---|---|---|
np.sum(arr, axis) | 求和 | np.sum(arr, axis=0) |
np.mean(arr, axis) | 平均值 | np.mean(arr, axis=1) |
np.max(arr, axis) | 最大值 | np.max(arr) |
np.min(arr, axis) | 最小值 | np.min(arr, axis=0) |
np.std(arr, axis) | 标准差 | np.std(arr) |
np.var(arr, axis) | 方差 | np.var(arr, axis=1) |
np.argmax(arr, axis) | 最大值索引 | np.argmax(arr, axis=1) |
np.argmin(arr, axis) | 最小值索引 | np.argmin(arr) |
np.cumsum(arr, axis) | 累加(保留中间结果) | np.cumsum([1,2,3]) → [1,3,6] |
np.cumprod(arr, axis) | 累乘 | np.cumprod([1,2,3]) → [1,2,6] |
五、线性代数操作
NumPy内置了完整的线性代数工具(np.linalg 模块),对于数据分析来说,下面这些是最常用的。
5.1 矩阵乘法(划重点)
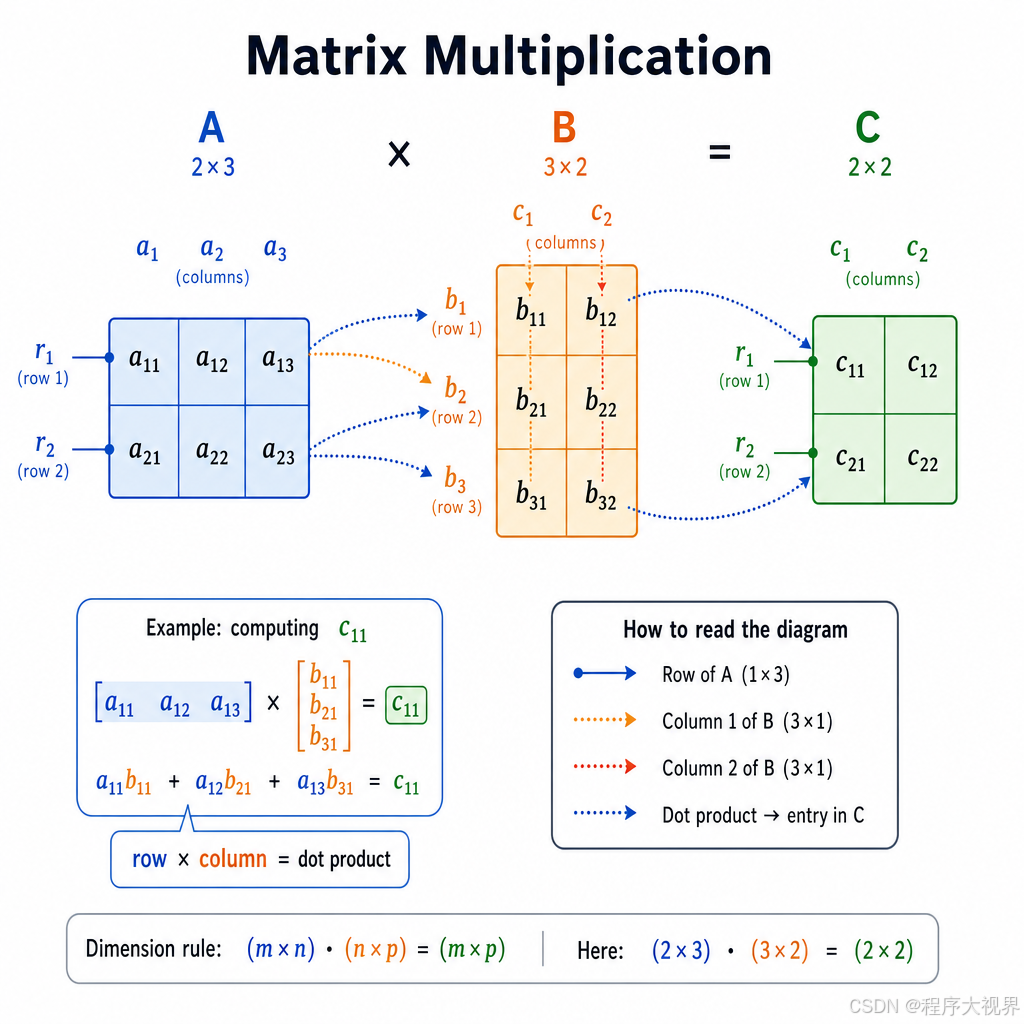
不要用 * 做矩阵乘法! * 是逐元素乘法。矩阵乘法要用 @ 或 np.dot() 或 np.matmul():
import numpy as np

A = np.array([[1, 2],
              [3, 4]])
B = np.array([[5, 6],
              [7, 8]])

# 逐元素乘法(Hadamard积)
print(A * B)
# [[ 5 12]
#  [21 32]]

# 矩阵乘法(点积)
print(A @ B)
# [[19 22]
#  [43 50]]
# 计算方式:第i行 × 第j列 求和

print(np.dot(A, B))      # 同上,经典写法
print(np.matmul(A, B))   # 同上,语义更清晰
5.2 矩阵转置与形状变换
A = np.array([[1, 2, 3],
              [4, 5, 6]])   # shape: (2,3)

print(A.T)   # 转置,shape变成 (3,2)
# [[1 4]
#  [2 5]
#  [3 6]]

# reshape:改变形状,元素总数不变
print(A.reshape(3, 2))  # shape: (3,2)
print(A.reshape(6, -1))  # -1表示自动推断,这里是(6,1)
print(A.reshape(-1))      # 扁平化成一维: [1 2 3 4 5 6]
print(A.flatten())        # 同上,扁平化成一维
5.3 常用线性代数函数
import numpy as np
import numpy.linalg as LA

A = np.array([[1, 2],
              [3, 4]])

print(LA.det(A))     # 行列式: -2.0
print(LA.eig(A))     # 特征值与特征向量(返回两个数组)
print(LA.inv(A))     # 逆矩阵
print(LA.norm(A))    # 矩阵范数(默认Frobenius范数)
print(np.trace(A))    # 迹(对角线元素之和): 1 + 4 = 5

# 解线性方程组 Ax = b
# 比如: 1x + 2y = 5, 3x + 4y = 11
A = np.array([[1, 2], [3, 4]])
b = np.array([5, 11])
x = LA.solve(A, b)
print(x)  # [1. 2.] → x=1, y=2
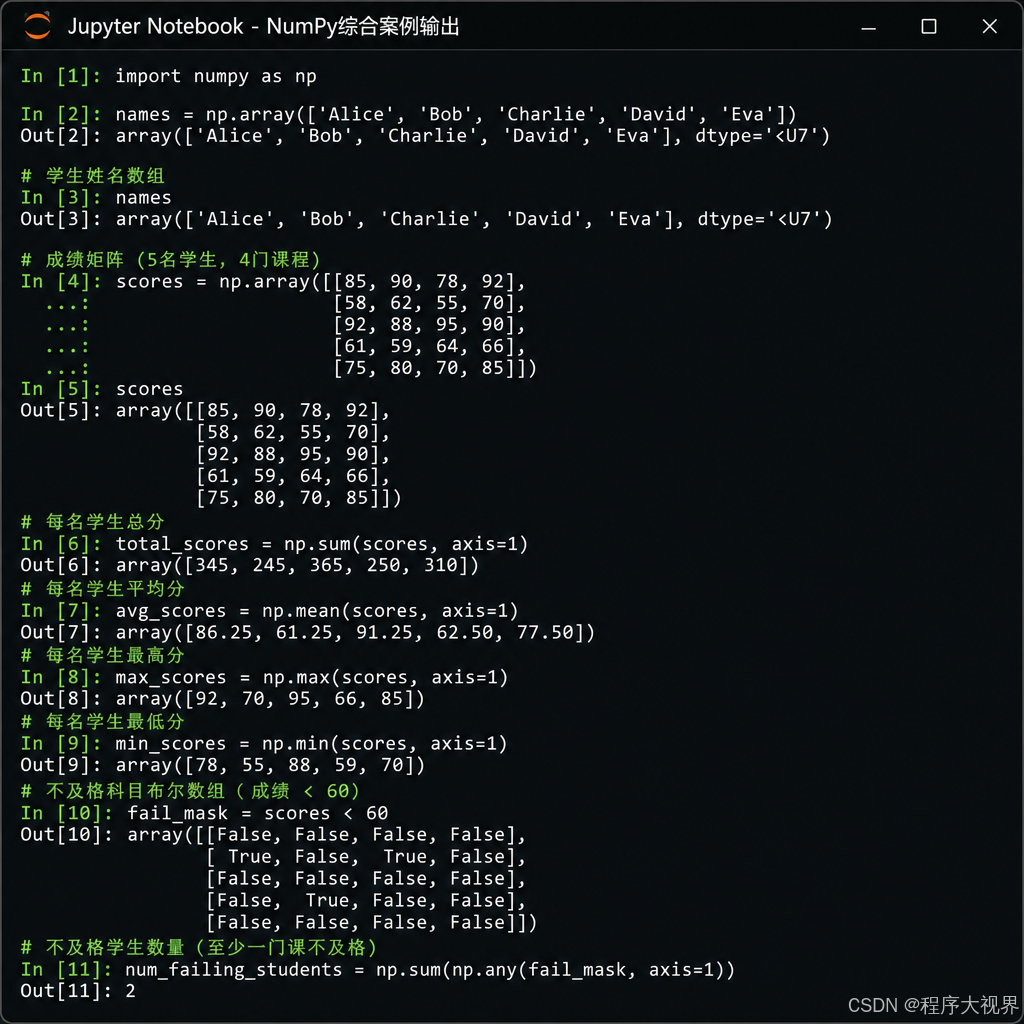
六、综合案例:用NumPy分析学生成绩数据
把上面学的所有知识串起来,做一个完整的小项目。
需求:有一个班级的成绩数据(3个班级,每班5个学生,4门课),需要:
- 计算每个学生的总分和平均分
- 计算每门课的平均分
- 找出每门课的最高分学生
- 将所有成绩标准化(减去均值,除以标准差)
- 找出所有不及格(<60)的成绩位置
import numpy as np

# 设置随机种子,保证结果可复现
np.random.seed(42)

# 模拟数据:3个班级,每班5个学生,4门课(语数英物)
# 成绩服从正态分布,均值75,标准差12,限制在0-100之间
raw = np.random.normal(75, 12, size=(3, 5, 4))
scores = np.clip(raw, 0, 100).round(1)  # 限制范围并保留1位小数

print("原始成绩数据:")
print(scores)
print(f"数据形状: {scores.shape}  →  3个班级 × 5个学生 × 4门课")

# 1. 每个学生的总分和平均分(沿着课的维度,即axis=2)
total_by_student = np.sum(scores, axis=2)   # shape: (3,5)
mean_by_student = np.mean(scores, axis=2)   # shape: (3,5)
print("\n各班级学生总分:")
print(total_by_student)
print("\n各班级学生平均分:")
print(mean_by_student)

# 2. 每门课的平均分(沿着学生维度,即axis=1)
mean_by_course = np.mean(scores, axis=1)    # shape: (3,4)
print("\n各班级各门课平均分:")
print(mean_by_course)

# 3. 每门课最高分的学生(在每个班级内,沿着学生维度找)
for class_idx in range(3):
    class_data = scores[class_idx]  # shape: (5,4)
    # 计算每个学生总分
    student_total = np.sum(class_data, axis=1)  # shape: (5,)
    top_student = np.argmax(student_total)
    print(f"\n班级{class_idx+1}最高分学生:学生{top_student+1},总分{student_total[top_student]:.1f}")

# 4. 成绩标准化(Z-score normalization)
# 对所有成绩: (x - mean) / std
scores_mean = np.mean(scores)
scores_std = np.std(scores)
scores_normalized = (scores - scores_mean) / scores_std
print("\n标准化后的成绩(前5个):")
print(scores_normalized.flatten()[:5])

# 5. 找出所有不及格成绩的位置
fail_mask = scores < 60
fail_positions = np.argwhere(fail_mask)
print(f"\n不及格成绩数量: {np.sum(fail_mask)}")
print("不及格成绩位置(班级, 学生, 课程):")
for pos in fail_positions:
    class_id, student_id, course_id = pos
    print(f"  班级{class_id+1}-学生{student_id+1}-课程{course_id+1}: {scores[tuple(pos)]}")
七、NumPy常见坑点与调试技巧
坑点1:视图(view)vs 副本(copy)
a = np.array([1, 2, 3, 4, 5])
b = a[::2]      # 切片返回视图,b和a共享内存!
b[0] = 999
print(a)  # [999   2   3   4   5]  ← a也被改了!

# 如果你不想要这种共享行为,用copy()
c = a[::2].copy()
c[0] = 111
print(a)  # [999   2   3   4   5]  ← a没变,安全!
坑点2:整数除法在Python 3里是正常的
Python 3里 / 就是真除法(结果是浮点数),// 才是整除。这点上NumPy和Python一致,不用担心。
坑点3:axis 参数搞不清
回到那句口诀:axis=N 沿着第N个轴的方向计算,结果里第N维消失。
或者更直观:在纸上把数组写出来,axis=0 是往下看(跨行),axis=1 是往右看(跨列)。
八、本文总结
| 知识点 | 核心要点 |
|---|---|
| 向量化运算 | 数组运算是逐元素的,无需for循环,速度极快 |
| 广播机制 | 形状不同也能运算,规则:从后往前比,相等或其中一个为1 |
| 聚合函数 | sum/mean/max/min/std/var,注意axis参数的含义 |
| 矩阵乘法 | 用@或np.dot(),不要用* |
| 布尔索引 | arr[arr > 60] 一行代码完成筛选 |
| 视图vs副本 | 切片返回视图(共享内存),.copy() 创建副本 |
NumPy的内容到这里就告一段落了。下一篇开始进入Pandas——Python数据分析的真正的"主力工具"。如果你觉得NumPy的数组操作已经很强大了,那Pandas会让你觉得"这才是我要的东西"。
动手练习
-
创建一个 shape 为
(5, 5)的随机整数数组(范围1-100),然后计算:(a)每列的平均值;(b)每行的最大值索引;(c)找出所有大于50的元素位置。 -
有两个数组
A = np.array([1,2,3])和B = np.array([[10],[20]]),预测A + B的结果形状,然后验证你的预测。 -
用NumPy模拟抛10000次硬币(用
np.random.randint(0, 2, 10000)表示正面反面),计算正面的比例,并与理论值0.5比较。 -
创建一个
(3, 4)的数组,用np.where把所有大于平均值的数标记为1,小于等于平均值的标记为0。
下一篇预告:《18 Pandas(一):Series与DataFrame详解——数据分析的真正的入口》
Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐
 0
 0
- 0


 已为社区贡献10条内容

所有评论(0)