『C++成长记』一颗会搜索的二叉树
🔥博客主页:小王又困了
📚系列专栏:C++
🌟人之为学,不日近则日退
❤️感谢大家点赞👍收藏⭐评论✍️
目录
一、二叉搜索树的概念
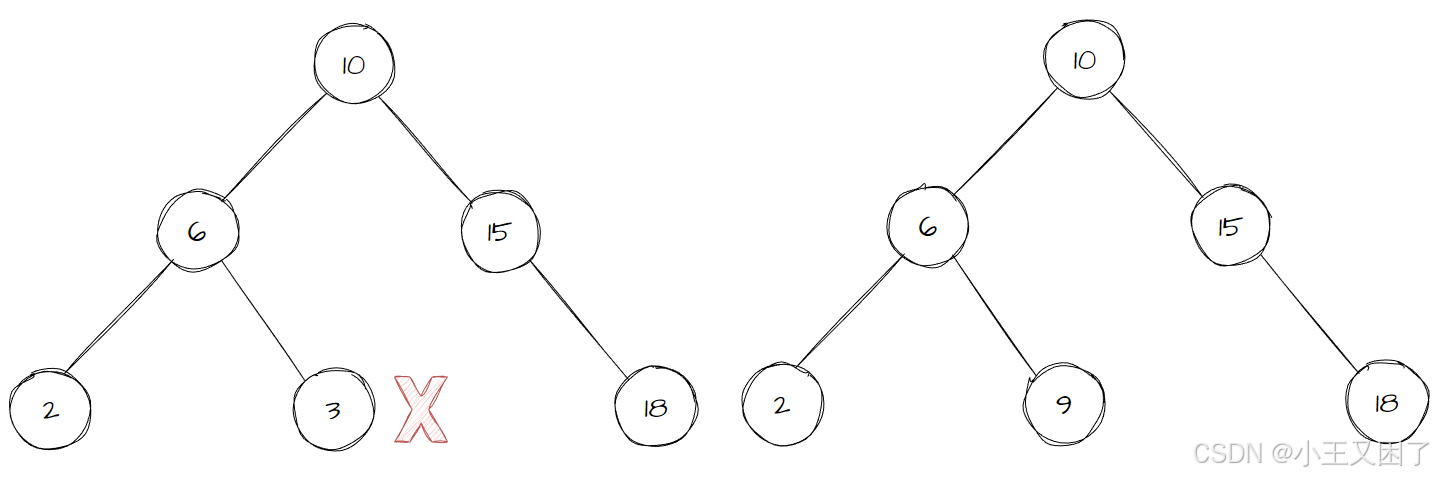
二叉搜索树又称二叉排序树,它或者是一棵空树,或者是具有以下性质的二叉树:
- 若它的左子树不为空,则左子树上所有节点的值都小于根节点的值
- 若它的右子树不为空,则右子树上所有节点的值都大于根节点的值
- 它的左右子树也分别为二叉搜索树
二、二叉搜索树的操作
📒2.1二叉搜索树的查找
- 从根开始比较,比根大则往右边走查找,比根小则往左边走查找。
- 最多查找高度次,走到到空,还没找到,这个值不存在。
小Tips:这里最多查找高度次的时间复杂度并不是O(logN),这是在理想的情况下,即这颗二叉树是一颗满二叉树或者完全二叉树。在极端情况下,这棵二叉树只有一条路径,此时最多查找高度次的时间复杂度就是O(N)。
📒2.2二叉搜索树的插入
插入的具体过程如下:
- 树为空:直接新增节点,赋值给 root 指针
- 树不空:按二叉搜索树性质查找插入位置,插入新节点。
📒2.3 二叉搜索树的删除
首先查找元素是否在二叉搜索树中,如果不存在,则返回,否则要删除的结点可能分下面四种情况:
-
要删除的结点没有孩子结点。
-
要删除的结点只有左孩子结点。
-
要删除的结点只有右孩子结点。
-
要删除的结点有左、右孩子节点。
看起来待删除节点有4中情况,实际情况 a 可以与情况 b 或者 c 合并起来,我们可以分为有 0或1个孩子 和 有2个孩子 这两种情况。因此真正的删除过程如下:
- 情况一(要删除的结点只有左孩子):删除该结点,让被删除节点的双亲结点指向被删除节点的左孩子结点--直接删除
- 情况二(要删除的结点只有又孩子):删除该结点,让被删除节点的双亲结点指向被删除结点的右孩子结点--直接删除
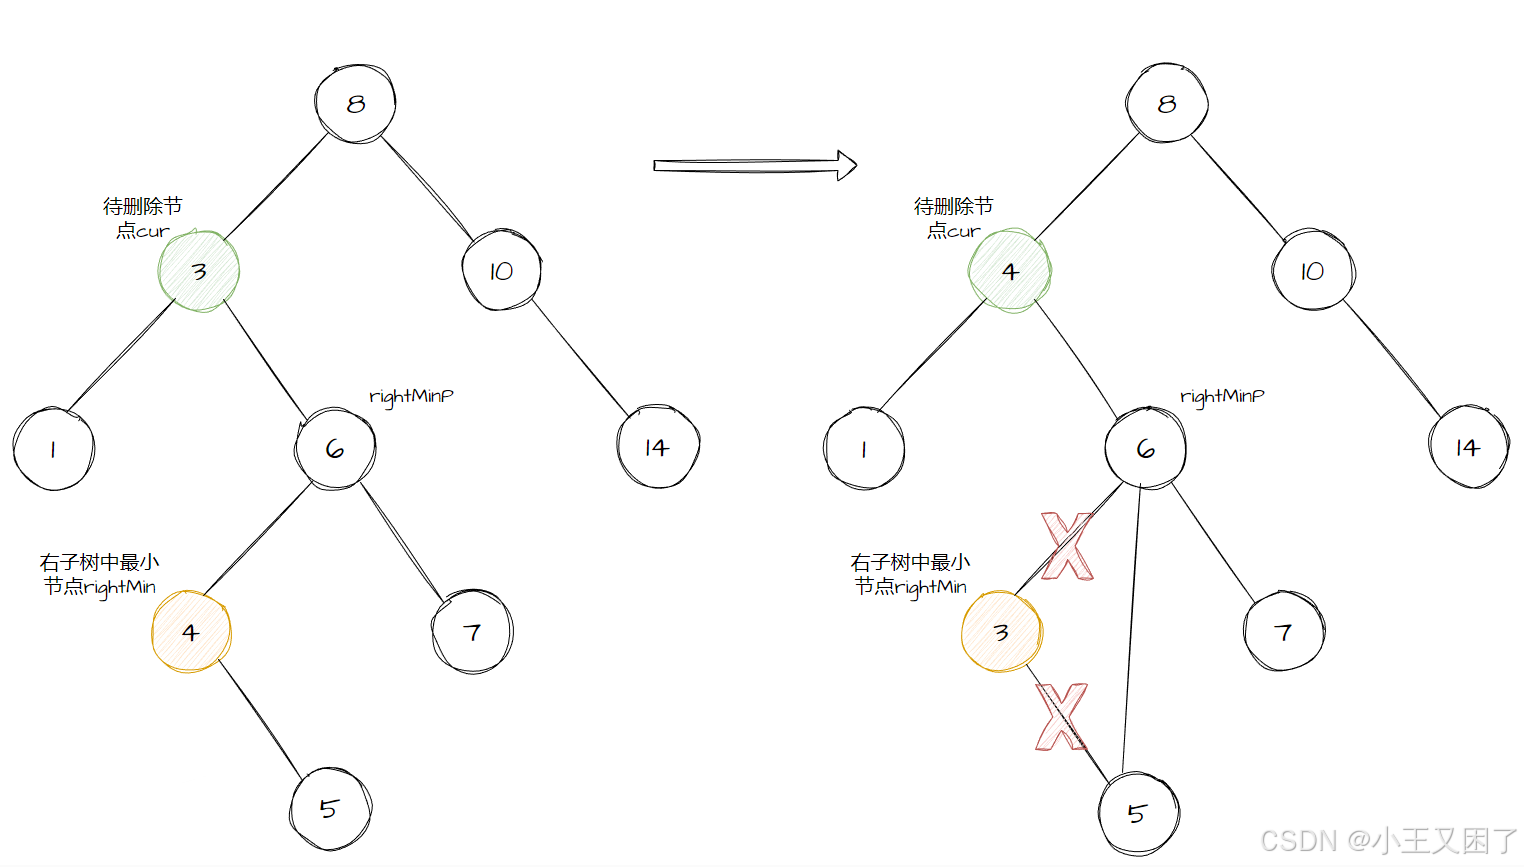
- 情况三(要删除的结点有两个孩子):在它的右子树中寻找中序下的第一个结点(关键码最小),用它的值填补到被删除节点中,再来处理该结点的删除问题--替换法删除
三、二叉搜索树的实现
二插搜索树只是一种结构,它本质上是由一个个结点链接而成,因此我们首先需要定义一个结点类,这个结点用来存储数据。有了结点类之后就需要定义一个二叉搜索树的类,这个类主要是用来维护结构的,实现增删查改等功能。
📒3.1 BSTNode(结点类)
template<class K>
struct BSTNode
{
	K _key;
	BSTNode<K>* _left;
	BSTNode<K>* _right;

	BSTNode(const K& key)
		: _key(key)
		, _left(nullptr)
		, _right(nullptr)
	{}
};
📒3.2 BSTree(二叉搜索树类)
🗒️3.2.1框架
template<class K>
class BSTree
{
	typedef BSTNode<K> Node;
public:
    BinarySearckTree()
	    :_root(nullptr)
	{}
private:
	Node* _root;
};
🗒️3.2.2 插入
bool Insert(const K& key)
{
	if (_root == nullptr)
	{
	    _root = new Node(key);
		return true;
	}

	Node* parent = nullptr;
	Node* cur = _root;
	while (cur)
	{
		if (cur->_key < key)
		{
			parent = cur;
			cur = cur->_right;
		}
		else if (cur->_key > key)
		{
			parent = cur;
			cur = cur->_left;
		}
		else
		{
			return false;//相等就说明树中已经有了,就应该插入失败
		}
	}

	cur = new Node(key);
	//判断一下插在左还是右
	if (parent->_key < key)
	{
		parent->_right = cur;
	}
	else
	{
		parent->_left = cur;
	}
	return true;
}
小Tips:我们要单独考虑根节点为空的情况。用 cur 找到该结点应该要插入的位置,用 parent 指向该位置的双亲结点,以实现链接关系。最后还需要判断插入到双亲结点的左侧还是右侧。我们实现的这个二叉搜索树相同的值只能插入一次,因此当插入一个值 key 的时候,如果检测到树中已经有一个结点存的是 key,那么就应该返回 false,表明插入失败。
🗒️3.2.3 查找
bool Find(const K& key)
{
	Node* cur = _root;
	while (cur)
	{
		if (cur->_key < key)
		{
			cur = cur->_right;
		}
		else if (cur->_key > key)
		{
			cur = cur->_left;
		}
		else
		{
			return true;
		}
	}
	return false;
}
🗒️3.2.4 中序遍历
public:
	void InOrder()
	{
		_InOrder(_root);
		cout << endl;
	}

private:
	void _InOrder(Node* root)
	{
		if (root == nullptr)
		{
			return;
		}

		_InOrder(root->_left);
		cout << root->_key << " ";
		_InOrder(root->_right);
}小Tips:这里的中序遍历是用递归的方式来实现的,但是递归函数是要传递参数的,所以我们要把根节点 _root 传给这个函数,但是根节点 _root 是私有的成员变量,用户是访问不到的,因此我们不能直接提供中序遍历函数给用户。正确的做法是,虽然用户访问不到根结点,但是类里面可以访问,所以我们在类里面实现一个中序遍历的子函数 _InOrder,在这个子函数中实现中序遍历的逻辑,然后我们再去给用户提供一个中序遍历的函数接口 InOrder,由它去调用 _InOrder。这样以来用户就可以正常去使用中序遍历啦。
🗒️3.2.5删除
bool Erase(const K& key)
{
	Node* parent = nullptr;
	Node* cur = _root;
    //找到要删除的节点
	while (cur)
	{
		if (cur->_key < key)
		{
			parent = cur;
			cur = cur->_right;
		}
		else if (cur->_key > key)
		{
			parent = cur;
			cur = cur->_left;
		}
		else
		{
			// 删除
			// 0-1个孩子的情况
			if (cur->_left == nullptr)//如果cur只有右孩子
			{
				if (parent == nullptr)//删除根结点
				{
					_root = cur->_right;
				}
				else
				{
					if (parent->_left == cur)
						parent->_left = cur->_right;
					else
						parent->_right = cur->_right;
				}

				delete cur;
				return true;
			}
			else if (cur->_right == nullptr)//如果cur只有左孩子
			{
				if (parent == nullptr)//删除根结点
				{
					_root = cur->_left;
				}
				else
				{
					if (parent->_left == cur)
						parent->_left = cur->_left;
					else
						parent->_right = cur->_left;
				}

				delete cur;
				return true;
			}
			else
			{
				// 2个孩子的情况
				// 右子树的最小节点作为替代节点
				Node* rightMinP = cur;
				Node* rightMin = cur->_right;
				while (rightMin->_left)
				{
					rightMinP = rightMin;
					rightMin = rightMin->_left;
				}

				cur->_key = rightMin->_key;

				if (rightMinP->_left == rightMin)
					rightMinP->_left = rightMin->_right;
				else
					rightMinP->_right = rightMin->_right;

				delete rightMin;
				return true;
			}
		}
	}
	return false;
}小Tips:删除节点有两个孩子时,我们要先找到右子树的最小节点 rightMin ,同时也要记录 rightMinP ,从 cur 的右子树向左一直找即可。找到后交换 cur 和 rightMin 的值,这时我们就将问题转换为删除 rightMin 节点。
🗒️3.2.6析构
private:
    void Destroy(Node* root)
	{
		if (root == nullptr)
			return;

		Destroy(root->_left);
		Destroy(root->_right);
		delete root;
	}
public:
    ~BSTree()
	{
		Destroy(_root);
		_root = nullptr;
}小Tips:这里析构使用后序遍历,先去释放左孩子和右孩子的空间资源,最后释放根节点。
🗒️3.2.7拷贝构造
private:
	Node* Copy(Node* root)
	{
		if (root == nullptr)
			return nullptr;

		Node* newRoot = new Node(root->_key);
		newRoot->_left = Copy(root->_left);
		newRoot->_right = Copy(root->_right);

		return newRoot;
	}
public:
    BSTree(const BSTree<K>& t)
    {
	    _root = Copy(t._root);
    }
四、二叉搜索树的应用
📒4.1K模型
K模型即只有一个 Key 作为关键码,结构中只需要存储 Key 即可,关键码即为需要搜索到的值。比如:给一个单词 word,判断该单词是否拼写正确,具体方式如下:
- 以词库中所有单词集合中的每个单词作为 Key,构建一颗二叉搜索树。
- 在二叉搜索树中检索该单词是否存在,存在则拼写正确,不存在则拼写错误。
上面这颗二叉搜索树就是 Key 模型,因为这颗树的结点里面只能存储一个值,这个值就是 Key。
📒4.2KV模型
KV 模型即每一个关键码 Key,都有与之对应的的值 Value,即 <Key,Value> 的键值对。这种方式在现实生活中十分常见:
- 比如英汉词典就是英文与中文的对应关系,通过英文可以快速找到与其对应的中文,英文单词与其对应的中文 <word,Chinese> 就构成一种键值对。
- 再比如统计单词次数,统计成功后,给定单词就可以快速找到其出现的次数,单词与其出现次数就是 <word,count> 就构成一种键值对。
namespace keyValue
{
	template<class K, class V>
	struct BSTNode
	{
		// pair<K, V> _kv;
		K _key;
		V _value;
		BSTNode<K, V>* _left;
		BSTNode<K, V>* _right;

		BSTNode(const K& key, const V& value)
			:_key(key)
			, _value(value)
			, _left(nullptr)
			, _right(nullptr)
		{}
	};

	template<class K, class V>
	class BSTree
	{
		typedef BSTNode<K, V> Node;
	public:
		BSTree() = default;

		BSTree(const BSTree<K, V>& t)
		{
			_root = Copy(t._root);
		}

		~BSTree()
		{
			Destroy(_root);
			_root = nullptr;
		}

		bool Insert(const K& key, const V& value)
		{
			if (_root == nullptr)
			{
				_root = new Node(key, value);
				return true;
			}

			Node* parent = nullptr;
			Node* cur = _root;
			while (cur)
			{
				if (cur->_key < key)
				{
					parent = cur;
					cur = cur->_right;
				}
				else if (cur->_key > key)
				{
					parent = cur;
					cur = cur->_left;
				}
				else
				{
					return false;
				}
			}

			cur = new Node(key, value);
			if (parent->_key < key)
			{
				parent->_right = cur;
			}
			else
			{
				parent->_left = cur;
			}

			return true;
		}

		Node* Find(const K& key)
		{
			Node* cur = _root;
			while (cur)
			{
				if (cur->_key < key)
				{
					cur = cur->_right;
				}
				else if (cur->_key > key)
				{
					cur = cur->_left;
				}
				else
				{
					return cur;
				}
			}

			return nullptr;
		}

		bool Erase(const K& key)
		{
			Node* parent = nullptr;
			Node* cur = _root;
			while (cur)
			{
				if (cur->_key < key)
				{
					parent = cur;
					cur = cur->_right;
				}
				else if (cur->_key > key)
				{
					parent = cur;
					cur = cur->_left;
				}
				else
				{
					// 删除
					// 0-1个孩子的情况
					if (cur->_left == nullptr)
					{
						if (parent == nullptr)
						{
							_root = cur->_right;
						}
						else
						{
							if (parent->_left == cur)
								parent->_left = cur->_right;
							else
								parent->_right = cur->_right;
						}

						delete cur;
						return true;
					}
					else if (cur->_right == nullptr)
					{
						if (parent == nullptr)
						{
							_root = cur->_left;
						}
						else
						{
							if (parent->_left == cur)
								parent->_left = cur->_left;
							else
								parent->_right = cur->_left;
						}

						delete cur;
						return true;
					}
					else
					{
						// 2个孩子的情况
						// 右子树的最小节点作为替代节点
						Node* rightMinP = cur;
						Node* rightMin = cur->_right;
						while (rightMin->_left)
						{
							rightMinP = rightMin;
							rightMin = rightMin->_left;
						}

						cur->_key = rightMin->_key;

						if (rightMinP->_left == rightMin)
							rightMinP->_left = rightMin->_right;
						else
							rightMinP->_right = rightMin->_right;

						delete rightMin;
						return true;
					}
				}
			}

			return false;
		}

		void InOrder()
		{
			_InOrder(_root);
			cout << endl;
		}
	private:
		void _InOrder(Node* root)
		{
			if (root == nullptr)
			{
				return;
			}

			_InOrder(root->_left);
			cout << root->_key << ":" << root->_value << endl;
			_InOrder(root->_right);
		}

		void Destroy(Node* root)
		{
			if (root == nullptr)
				return;

			Destroy(root->_left);
			Destroy(root->_right);
			delete root;
		}

		Node* Copy(Node* root)
		{
			if (root == nullptr)
				return nullptr;

			Node* newRoot = new Node(root->_key, root->_value);
			newRoot->_left = Copy(root->_left);
			newRoot->_right = Copy(root->_right);

			return newRoot;
		}

	private:
		Node* _root = nullptr;
	};
}
五、二叉搜索树的性能分析
插入和删除操作都必须先查找,查找效率代表了二叉搜索树中各个操作的性能。对有 n 个结点的二叉搜索树,若每个元素查找的概率相等,则二叉搜索树平均查找长度是结点在二插搜索树的深度的函数,即结点越深,则比较次数越多。但对于同一个关键码集合,如果各关键码插入的次序不同,可能得到不同结构的二叉搜索树。
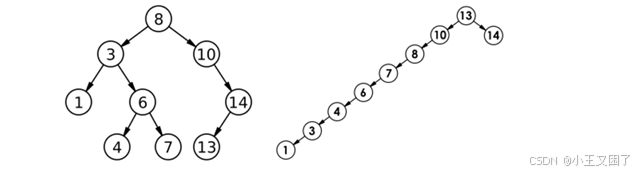
最优情况下:二叉搜索树为完全二叉树(或者接近完全二叉树),其平均比较次数为:log2n 。
最差情况下:二叉搜索树退化为单支树(或者类似单支),其平均比较次数为:N/2。如果退化成了单支树,那么二叉搜索树的性能就失去了。此时就需要用到即将登场的 AVL 树和红黑树了。
🎁结语:
本次的内容到这里就结束啦。希望大家阅读完可以有所收获,同时也感谢各位读者三连支持。文章有问题可以在评论区留言,博主一定认真认真修改,以后写出更好的文章。你们的支持就是博主最大的动力。
Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐
 22
 0
- 0


 已为社区贡献4条内容

所有评论(0)