C++进阶,迈出新手村,再学一次树
国庆过的好吗? 云狗国庆过的蛮开心的,嘿嘿……(^-^),总之我们今天就可以把树结了,可能会存在没有讲到的东西,但是如果你深入了解过C++就业分支的话,你会发现C++的教材在你学完基础的语法之后就应该分裂成若干本独立的教材,比如Qt方向在学习算法的过程中几乎用不到opencv的任何知识,以致于C++开发者们之间交流都可能存在一定的分歧,所以如果你发现本系列有些对你很重要的知识没有讲到,我只能在系列后期挑个别呼声大一点进行补坑,如果我没接触过的话,还得考虑学习成本和时间成本,很抱歉我爱莫能助(这一箭,支援未来!)
依旧叠甲:本文存在为了便于理解而可能将一些概念说错,甚至曲解了一些算法比较权威的解释,C++深入研究者,请谨慎辨别,本文面向刚学完C++语法的,没有什么实践项目,还在学习过程中的萌新、小白、业余爱好者、大学生(应试)、自学者、不太想啃黑书的程序员
废话不多说直接快进到我们的种树(根据数组建造一颗树),搜索树、B树,B+树、红黑树(教学顺序和思路会按照算法导论来,我个人也觉得比较好理解)
树的核心算法(Part3)
搜索树 (Binary Search Tree, BST)
在建立一棵树之后,如果你想要查找固定元素,结合之前的内容,我们可以简单改造一下bfs或dfs来完成搜索,可是如果这棵树特别大且位于这棵树最底部呢?当考虑这样的最差情况下我们发现遍历一棵树那真的得回家等通知了……,在一棵树中我们通常希望小数在左,大数在右,如果需要搜一个数,只要从根开始一一往下比较然后左右移动就好了,所以搜索树的一大特性便是这棵树的每个节点符合左小右大的特性,因此也叫排序树。
函数都还挺简单的所以不过多解释
struct BSTNode {
    int data;
    BSTNode* left;
    BSTNode* right;

    BSTNode(int val) : data(val), left(nullptr), right(nullptr) {}
};

class BST {
private:
    BSTNode* root;

    // 递归插入函数
    BSTNode* insert(BSTNode* node, int val) {
        if (node == nullptr) {
            return new BSTNode(val);
        }
        if (val < node->data) {
            node->left = insert(node->left, val);
        } else if (val > node->data) {
            node->right = insert(node->right, val);
        }
        // 如果 val == node->data,则什么都不做(不允许重复值)
        return node;
    }

    // 递归查找函数
    bool search(BSTNode* node, int val) const {
        if (node == nullptr) {
            return false;
        }
        if (val == node->data) {
            return true;
        }
        return val < node->data ? search(node->left, val) : search(node->right, val);
    }

    // 递归销毁函数
    void destroyTree(BSTNode* node) {
        if (node != nullptr) {
            destroyTree(node->left);
            destroyTree(node->right);
            delete node;
        }
    }
//对外接口
public:
    BST() : root(nullptr) {}
    ~BST() {
        destroyTree(root);
    }

    void insert(int val) {
        root = insert(root, val);
    }

    bool search(int val) const {
        return search(root, val);
    }
};
红黑树(Red-Black Tree, RBT)
好了,在实现红黑树之前问你一个问题,如果我在插入操作用的本身就是一个有序数组会发生什么?显然地,根据我们插入的逻辑这棵树会发生退化成为一个链表,这棵树显然不是一颗平衡树且我们查找的效率贬低,本来是时间复杂度logn现在直接退化成n了这显然是我们不希望发生的,那么我们怎么实现一棵树的自动平衡呢?
于是我们引入了红黑树,其定义基本和树一样,但是引入了颜色(红,黑)
这些颜色也存在一些规则:
1.根节点与叶子节点以及空节点是黑色的
2.一个节点是红色的其父节点以及叶子节点应当是黑色,反之亦然。
3.从任一节点到其所有后代叶子节点的路径上,黑色节点的数量都相同。(这保证了树的平衡性)
为了实现自平衡我们引入了两种算法(实际上算3种)来解决
1.变色:字面意思
2.旋转:分为左旋和右旋,其目的是使得树的结构改变,且性质不变
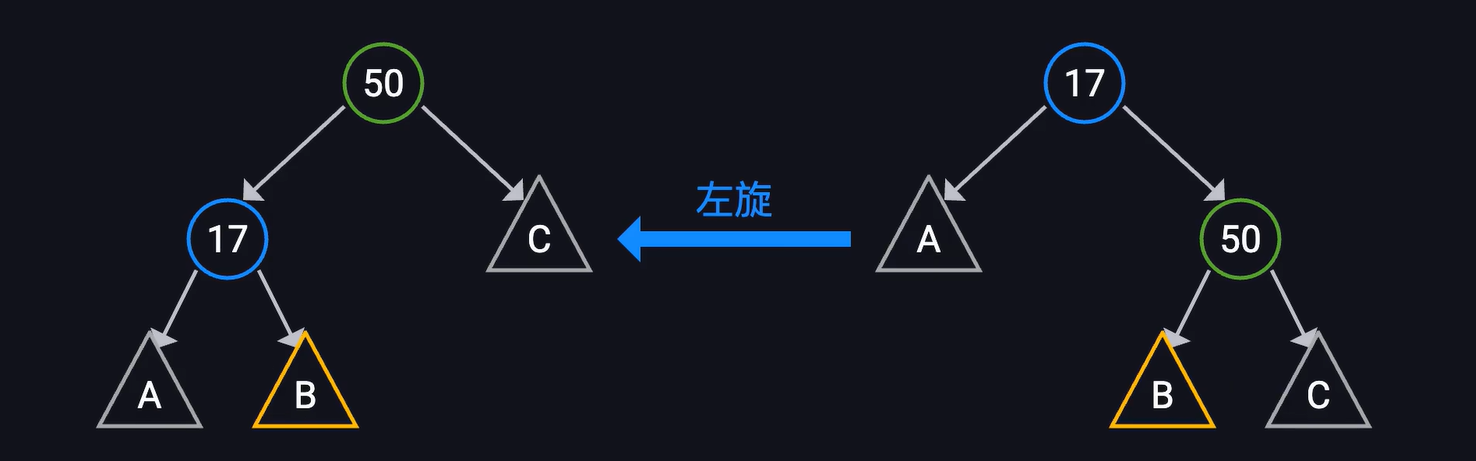
(ps:这里涉及到了节点之间叔父的概念,其实和家里的家庭树,族谱是一样的即父亲的弟弟……
我真的…,我不中了)
旋转算法的思路是
enum Color { RED, BLACK };

struct RBNode {
    int data;
    Color color;
    RBNode* left;
    RBNode* right;
    RBNode* parent;

    RBNode(int val) : data(val), color(RED), left(nullptr), right(nullptr), parent(nullptr) {}
};

class RBTree {
private:
    RBNode* root;
    RBNode* nil; // 所有叶子节点都指向这个哨兵节点

    // 左旋转
    void leftRotate(RBNode* x) {
        RBNode* y = x->right;
        x->right = y->left;
        if (y->left != nil) {
            y->left->parent = x;
        }
        y->parent = x->parent;
        if (x->parent == nil) {
            root = y;
        } else if (x == x->parent->left) {
            x->parent->left = y;
        } else {
            x->parent->right = y;
        }
        y->left = x;
        x->parent = y;
    }

    // 右旋转 (与左旋转对称)
    void rightRotate(RBNode* y) {
        RBNode* x = y->left;
        y->left = x->right;
        if (x->right != nil) {
            x->right->parent = y;
        }
        x->parent = y->parent;
        if (y->parent == nil) {
            root = x;
        } else if (y == y->parent->right) {
            y->parent->right = x;
        } else {
            y->parent->left = x;
        }
        x->right = y;
        y->parent = x;
    }

    // 插入后修复
    void insertFixup(RBNode* z) {
        while (z->parent->color == RED) {
            if (z->parent == z->parent->parent->left) {
                RBNode* y = z->parent->parent->right; // 叔父节点
                if (y->color == RED) {
                    // 情况1: 叔父是红色,只需要变色
                    z->parent->color = BLACK;
                    y->color = BLACK;
                    z->parent->parent->color = RED;
                    z = z->parent->parent;
                } else {
                    if (z == z->parent->right) {
                        // 情况2: 叔父是黑色,且z是右孩子,先左旋转变成情况3
                        z = z->parent;
                        leftRotate(z);
                    }
                    // 情况3: 叔父是黑色,且z是左孩子,变色+右旋转
                    z->parent->color = BLACK;
                    z->parent->parent->color = RED;
                    rightRotate(z->parent->parent);
                }
            } else {
                // 与上面对称,父节点是祖父节点的右孩子
                RBNode* y = z->parent->parent->left; // 叔父节点
                if (y->color == RED) {
                    z->parent->color = BLACK;
                    y->color = BLACK;
                    z->parent->parent->color = RED;
                    z = z->parent->parent;
                } else {
                    if (z == z->parent->left) {
                        z = z->parent;
                        rightRotate(z);
                    }
                    z->parent->color = BLACK;
                    z->parent->parent->color = RED;
                    leftRotate(z->parent->parent);
                }
            }
        }
        root->color = BLACK; // 确保根节点始终是黑色
    }

public:
    RBTree() {
        nil = new RBNode(0); // 创建哨兵节点,数据值无关紧要
        nil->color = BLACK;
        root = nil;
    }

    void insert(int val) {
        RBNode* z = new RBNode(val);
        RBNode* y = nil;
        RBNode* x = root;

        // 1. 像普通BST一样找到插入位置
        while (x != nil) {
            y = x;
            if (z->data < x->data) {
                x = x->left;
            } else {
                x = x->right;
            }
        }
        z->parent = y;
        if (y == nil) {
            root = z; // 树是空的
        } else if (z->data < y->data) {
            y->left = z;
        } else {
            y->right = z;
        }
        z->left = nil;
        z->right = nil;
        z->color = RED; // 2. 新插入的节点总是红色

        // 3. 修复红黑树性质
        insertFixup(z);
    }
};
B树
到了B树,这一部分的内容可能要更多的结合计组和CSAPP这两本书,因为其设计出来的目的就是为了适应磁盘等外存储设备。
我们比较常用,常考的B树 是 三阶B树
引入概念:B树的阶m 指的是 一个节点的子节点的最大值
优势比较明显:
- 高扇出 (High Fanout):一个节点可以存储很多关键字和子节点指针,使得树的高度非常低。
- 减少 I/O:对于磁盘来说,一次 I/O 可以读取一个节点。树的高度低意味着查找一个数据只需要几次 I/O 操作,效率极高
核心算法如下
- 插入:如果插入后节点关键字数量超过
m-1,则需要分裂 (Split) 该节点。 - 删除:如果删除后节点关键字数量低于
⌈m/2⌉ - 1,则需要从兄弟节点借 (Borrow) 或者与兄弟节点合并 (Merge)。
(以下内容不过多阐述,因为本身需要别的知识来支撑理解,想要了解的可以先学习对应内容)
插入算法分三步:
1.找到插入位置、2.分裂节点、3.叶子结点插入
删除算法分三步:
1.找到并删除节点、2.恢复结构
#include <iostream>
#include <vector>
#include <algorithm>

const int ORDER = 3; // 3阶B树
const int MIN_KEYS = (ORDER - 1) / 2; // 1
const int MAX_KEYS = ORDER - 1;       // 2

// 节点定义 (使用 int 类型)
struct BTreeNode {
    bool is_leaf;
    std::vector<int> keys;
    std::vector<BTreeNode*> children;

    BTreeNode() : is_leaf(true) {}
};

class BTree {
private:
    BTreeNode* root;

    // 分裂孩子节点
    void splitChild(BTreeNode* parent, int child_index) {
        BTreeNode* child = parent->children[child_index];
        BTreeNode* new_child = new BTreeNode();
        new_child->is_leaf = child->is_leaf;

        // 1. 将child的后半部分关键字和孩子移到new_child
        for (int i = 0; i < MIN_KEYS; ++i) {
            new_child->keys.push_back(child->keys[MAX_KEYS - MIN_KEYS + i]);
        }
        if (!child->is_leaf) {
            for (int i = 0; i < MIN_KEYS + 1; ++i) {
                new_child->children.push_back(child->children[MAX_KEYS - MIN_KEYS + 1 + i]);
            }
        }

        // 2. 缩小child
        child->keys.resize(MAX_KEYS - MIN_KEYS);
        child->children.resize(MAX_KEYS - MIN_KEYS + 1);

        // 3. 将new_child插入到parent的children中
        parent->children.insert(parent->children.begin() + child_index + 1, new_child);

        // 4. 将child的中间关键字提升到parent
        parent->keys.insert(parent->keys.begin() + child_index, child->keys[MIN_KEYS - 1]);
        child->keys.pop_back(); // 移除中间关键字
    }

    // 插入非满节点
    void insertNonFull(BTreeNode* node, int key) {
        int i = node->keys.size() - 1;
        if (node->is_leaf) {
            // 如果是叶子节点,直接插入
            node->keys.push_back(key);
            while (i >= 0 && key < node->keys[i]) {
                node->keys[i + 1] = node->keys[i];
                --i;
            }
            node->keys[i + 1] = key;
        } else {
            // 如果不是叶子节点,找到正确的子节点
            while (i >= 0 && key < node->keys[i]) {
                --i;
            }
            int child_index = i + 1;
            if (node->children[child_index]->keys.size() == MAX_KEYS) {
                // 如果子节点已满,先分裂
                splitChild(node, child_index);
                // 分裂后,确定新的插入位置
                if (key > node->keys[child_index]) {
                    child_index++;
                }
            }
            insertNonFull(node->children[child_index], key);
        }
    }

public:
    BTree() {
        root = new BTreeNode();
    }

    void insert(int key) {
        BTreeNode* r = root;
        if (r->keys.size() == MAX_KEYS) {
            // 如果根节点已满,创建新的根节点
            BTreeNode* new_root = new BTreeNode();
            root = new_root;
            new_root->is_leaf = false;
            new_root->children.push_back(r);
            splitChild(new_root, 0);
            insertNonFull(new_root, key);
        } else {
            insertNonFull(r, key);
        }
    }
};
B+树
B + 树是 B 树的一种变体,在数据库和文件系统中应用得更广泛
可以理解为B树的小升级
区别如下:
- 数据存储位置:B + 树的所有关键字和记录指针都存储在叶子节点中。非叶子节点只存储关键字的副本和子节点指针,用于索引。
- 叶子节点链表:所有叶子节点通过一个双向链表连接起来。
- 高效范围查询:可以先进行范围查询缩小搜索范围,然后进行搜索
- 查询更稳定:每次查询都必须到达叶子节点,路径长度相同,查询时间更稳定
- 更适合磁盘:非叶子节点不存储实际数据,所以同样大小的磁盘块可以容纳更多的索引项
对应地,代码实现也有点变化,但是很好理解(如果有理论知识支撑的会更容易一点)
#include <iostream>
#include <vector>
#include <algorithm>

const int ORDER = 3; // 3阶B+树
const int MIN_KEYS = (ORDER - 1) / 2; // 1
const int MAX_KEYS = ORDER - 1;       // 2

// 节点定义 (使用 int 类型)
struct BPlusTreeNode {
    bool is_leaf;
    std::vector<int> keys;
    std::vector<BPlusTreeNode*> children; // 非叶子节点指向子节点,叶子节点指向记录或下一页
    BPlusTreeNode* next; // 叶子节点的链表指针

    BPlusTreeNode() : is_leaf(true), next(nullptr) {}
};

class BPlusTree {
private:
    BPlusTreeNode* root;
    BPlusTreeNode* head; // 指向叶子节点链表的头

    // 分裂孩子节点 (逻辑与B树类似,但关键字提升方式不同)
    void splitChild(BPlusTreeNode* parent, int child_index) {
        BPlusTreeNode* child = parent->children[child_index];
        BPlusTreeNode* new_child = new BPlusTreeNode();
        new_child->is_leaf = child->is_leaf;

        // 1. 将child的后半部分关键字和孩子移到new_child
        for (int i = 0; i < MIN_KEYS; ++i) {
            new_child->keys.push_back(child->keys[MAX_KEYS - MIN_KEYS + i]);
        }
        if (!child->is_leaf) {
            for (int i = 0; i < MIN_KEYS + 1; ++i) {
                new_child->children.push_back(child->children[MAX_KEYS - MIN_KEYS + 1 + i]);
            }
        }

        // 2. 缩小child
        child->keys.resize(MAX_KEYS - MIN_KEYS);
        child->children.resize(MAX_KEYS - MIN_KEYS + 1);

        // 3. 将new_child插入到parent的children中
        parent->children.insert(parent->children.begin() + child_index + 1, new_child);

        // 4. 将new_child的第一个关键字提升到parent (B+树的关键区别)
        parent->keys.insert(parent->keys.begin() + child_index, new_child->keys[0]);

        // 5. 如果是叶子节点,更新链表指针
        if (child->is_leaf) {
            new_child->next = child->next;
            child->next = new_child;
            // 如果分裂的是头节点,更新头指针
            if (head == child) {
                head = new_child;
            }
        }
    }

    // ... insertNonFull 和 public insert 方法与B树类似 ...
    // 此处省略,因为逻辑高度相似,主要区别已在 splitChild 中体现
};

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐
 12
 0
- 0


 已为社区贡献3条内容

所有评论(0)