Langchain 学习四:文本嵌入模型Embedding
目录
1 安装langchain_text_splitter后无法识别
文本嵌入模型的原理是:将文本进入向量化,通过向量之间的相似度,得到匹配结果。当浏览器用就行。
1 模型下载
可以参考Langchain学习一,通过Ollama安装本地嵌入模型。LangChain学习一:开发一个小Demo-CSDN博客
我使用的是qwen3:0.6b
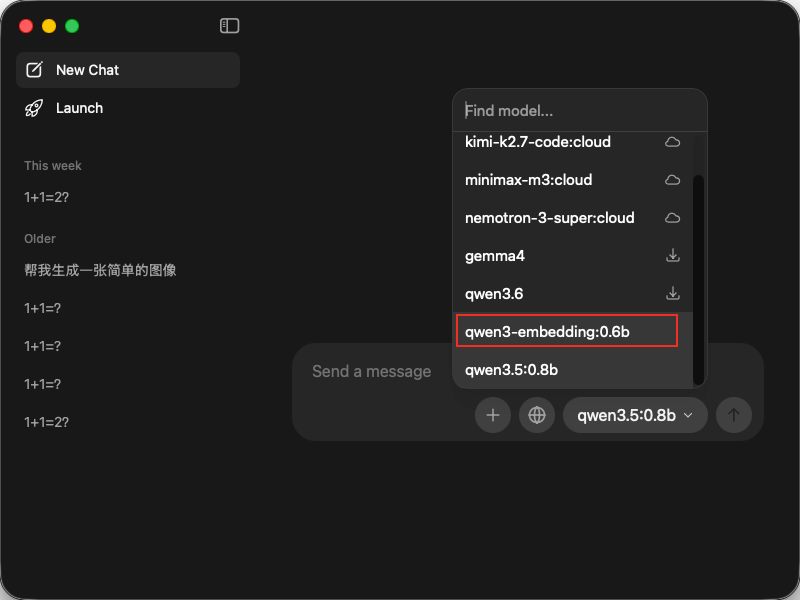
2 文本嵌入模型
2.1 导入包
不同的模型库导入方式并不相同,到模型下载的地方通常会有demo
from langchain_ollama.embeddings import OllamaEmbeddings2.2 创建向量化模型
模型名称和ollama中相同,地址采用ollama对外暴露的默认地址
embedding = OllamaEmbeddings(
    model="qwen3-embedding:0.6b",
    base_url="http://127.0.0.1:11434",
)
2.3 文本向量化
通过文本嵌入模型将文本进行向量化,输出值为多维度向量,不同嵌入式模型的结果不同。
prompt = "你好"
embedding_vector = embedding.embed_query(prompt)
print(embedding_vector)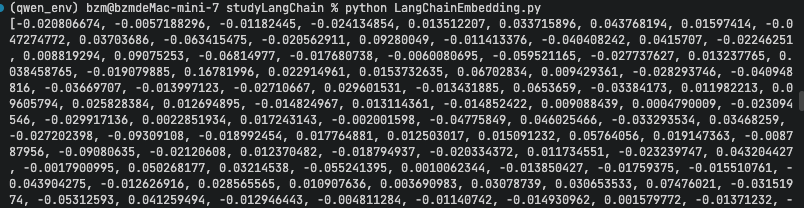
3 文本分割
文本分割的作用是将大文本分割成小块,然后将小块进行向量化处理,形成向量化数据库DB。当用户检索时,将用户检索的信息向量化为变量A。然后将用户检索A和数据库DB进行相似度计算,将DB中相似度较高的信息返回给用户。
3.1 文本分割
老版本中,当你下载完成Langchain包后,就包含文本分割模块。新版本langchain需要自己去下载一个文本分割工具。这里我仍然下载使用的为langchain的文本分割工具。
下载库的命令
(qwen_env) bzm@bzmdeMac-mini-7 studyLangChain % pip install langchain-text-splitters# 老版本已经废弃
# from langchain.text_splitter import RecursiveCharacterTextSplitter
# 新版本需要手动下载
from langchain_text_splitters import RecursiveCharacterTextSplitterfrom langchain_ollama import ChatOllama
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_ollama.embeddings import OllamaEmbeddings
embedding = OllamaEmbeddings(
model="qwen3-embedding:0.6b",
base_url="http://127.0.0.1:11434",
)
text_splitter = RecursiveCharacterTextSplitter(
chunk_size=5, # 分块大小
chunk_overlap=1, # 块重叠
# separators=[","], # 分割符
)
result = text_splitter.split_text("121,21,123456789101,32")
print(result)
输出结果:
(qwen_env) bzm@bzmdeMac-mini-7 studyLangChain % python LangChainEmbedding.py
['121,2', '21,12', '23456', '67891', '101,3', '32']
3.2 文件分割
3.2.1 文件加载工具
文件分割前需要对文件进行加载。
早期使用虚拟环境python安装langchain_community包(不在维护),它是第三方集成库。由于后面向量数据库也使用了它,因此我这次使用的仍然是这个。新版本的可以参考下面langchain_docling的介绍
因为langchain_community包过大,后面将把这个community包打散为多个包进行维护。
(qwen_env) bzm@bzmdeMac-mini-7 studyLangChain % pip install langchain_communityDocument loader integrations - Docs by LangChain新的文件加载模块 langchain_docling(官方提供不止这一个,可根据需求选择),支持异步加载,可参考文档。Document loader integrations - Docs by LangChain
(qwen_env) bzm@bzmdeMac-mini-7 studyLangChain % pip install langchain_docling3.2.2 文件加载并分割
创建文件:
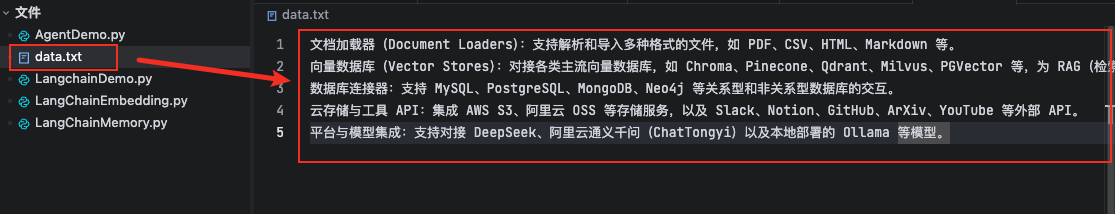
加载文件并分割
from langchain_ollama import ChatOllama
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_ollama.embeddings import OllamaEmbeddings
from langchain_community.document_loaders import TextLoader


embedding = OllamaEmbeddings(
    model="qwen3-embedding:0.6b",
    base_url="http://127.0.0.1:11434",
)

text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=5,
    chunk_overlap=1,
    # separators=[","],
)

# 方式1
result = TextLoader("data.txt").load_and_split(text_splitter)
# 方式2
# result = text_splitter.split_documents(TextLoader("data.txt").load())

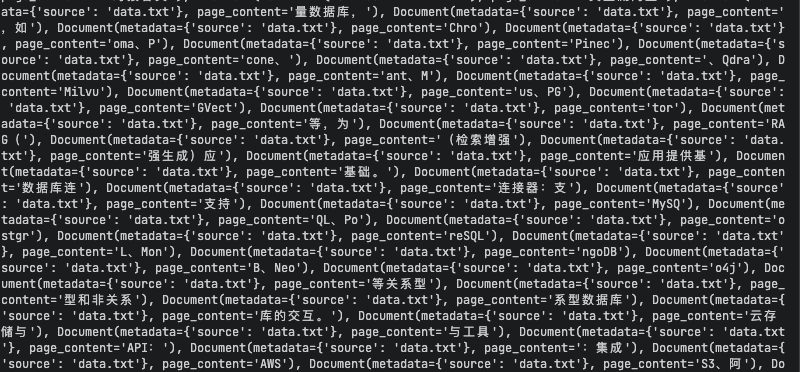
print(result)
分割结果为字符串数组。
4 向量数据库查找
将本地文件分割后,通过嵌入模型将文件向量化到本地数据库,并通过数据库去搜索相似数据块(chunk)
我选用的向量数据库为chromadb。通过向量搜索只是做匹配,并不是llm的模型生成
pip install chromadb
from langchain_ollama import ChatOllama
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_ollama.embeddings import OllamaEmbeddings
from langchain_community.document_loaders import TextLoader
from langchain_community.vectorstores import Chroma


embedding = OllamaEmbeddings(
    model="qwen3-embedding:0.6b",
    base_url="http://127.0.0.1:11434",
)

text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=20,
    chunk_overlap=1,
    # separators=[","],
)

# 方式1
result = TextLoader("data.txt").load_and_split(text_splitter)
# 方式2
# result = text_splitter.split_documents(TextLoader("data.txt").load())
# persist_directory持久化本地
vectorstore = Chroma.from_documents(result, embedding, persist_directory="chromaDB.db")

# k 为输出的结果
docs = vectorstore.similarity_search("Chroma",k=1)
print(docs)
坑
1 安装langchain_text_splitter后无法识别
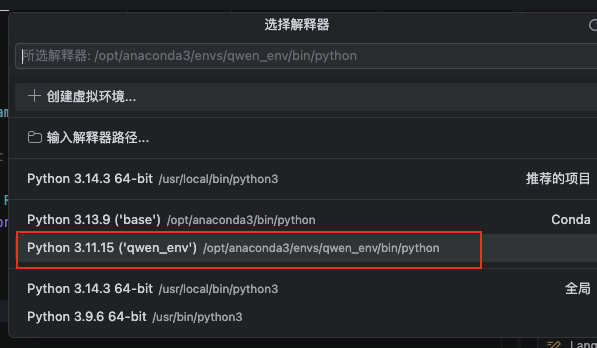
由于我电脑上安装了很多版本,导致我下载完成文本分割包后,仍然不识别langchain_text_splitters,需要设置编译环境使用的python版本为工具安装的版本。
我使用的为conda虚拟环境python安装的。编译器为vscode,因此在命令面板输入:
Select Interpreter,选择使用which pip的输出的版本
(qwen_env) bzm@bzmdeMac-mini-7 studyLangChain % which pip
/opt/anaconda3/envs/qwen_env/bin/pip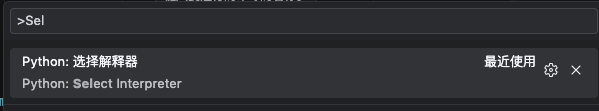

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐
 11
 0
- 0


 已为社区贡献2条内容

所有评论(0)